wtorek, 27 lutego 2018

Wybory parlamentarne z 2015 w woj pomorskim

Po latach wykonałem analizę (z rozpędu, zmotywowany analizowaniem wyników Danuty Hojarskiej). W województwie pomorskim są dwa okręgi wyborcze: 25 (Gdańsk) oraz 26 Gdynia. Zbiorcze wyniki z protokołów, które w swoim czasie pobrałem ze strony PKW są następujące:

  Komisje obwodowe wg ROZKŁADU głosów ważnych
  ** Okręg 26 126707 ważne głosy **
Kandydat    Komitet    Głosy Komisje Max      %  Średnia   Me 
-------------------------------------------------------------
Gromadzki   Stonoga     1521  795     12   1.20    1,9    1.0
Furgo       Petru      14239  795    224  11.23   17,9  10.00
Zwiercan    Kukiz      11801  795     65   9.31   14.8   13.0
Miller      Zlew       11524  795     72   9.09   14.5   10.0
Lewna       Psl         4644  795    213   3.66    5.8    2.0
Wysocki     Korwin      9491  795     54   7.49   11.9   10.0
Biernacki   Po         42535  795    312  33.56   53.5   38.0
Szczypińska PiS        30952  795    150  24.42   38.9   35.0

** Okręg 25 130348 ważne głosy **
Kandydat    Komitet    Głosy Komisje Max      %  Średnia   Me
-------------------------------------------------------------
Hojarska    Stonoga     1668  656    152   1.27    2.5    1.0
Lieder      Petru      23155  656    256  35.76   35.3   22.0
Błeńska     Kukiz       9410  656     45   7.21   14.3   14.0
Senyszyn    Zlew       13143  656     75  10.08   20.3   17.0
Sarnowski   Psl         3457  656    134   2.65    5.3    2.0
Rabenda     Korwin      8903  656     65   6.83   13.6   11.0
Krotowska   Razem       6995  656     45   5.36   10.7    9.0
Korol       PiS        28657  656    252  21.98   43.7   30.0
Sellin      PiS        34960  656    213  26.82   53.3   40.0

Te wyniki mogą (ale nie muszą) się ciut-niewiele różnić od oficjalnych--nie porównywałem

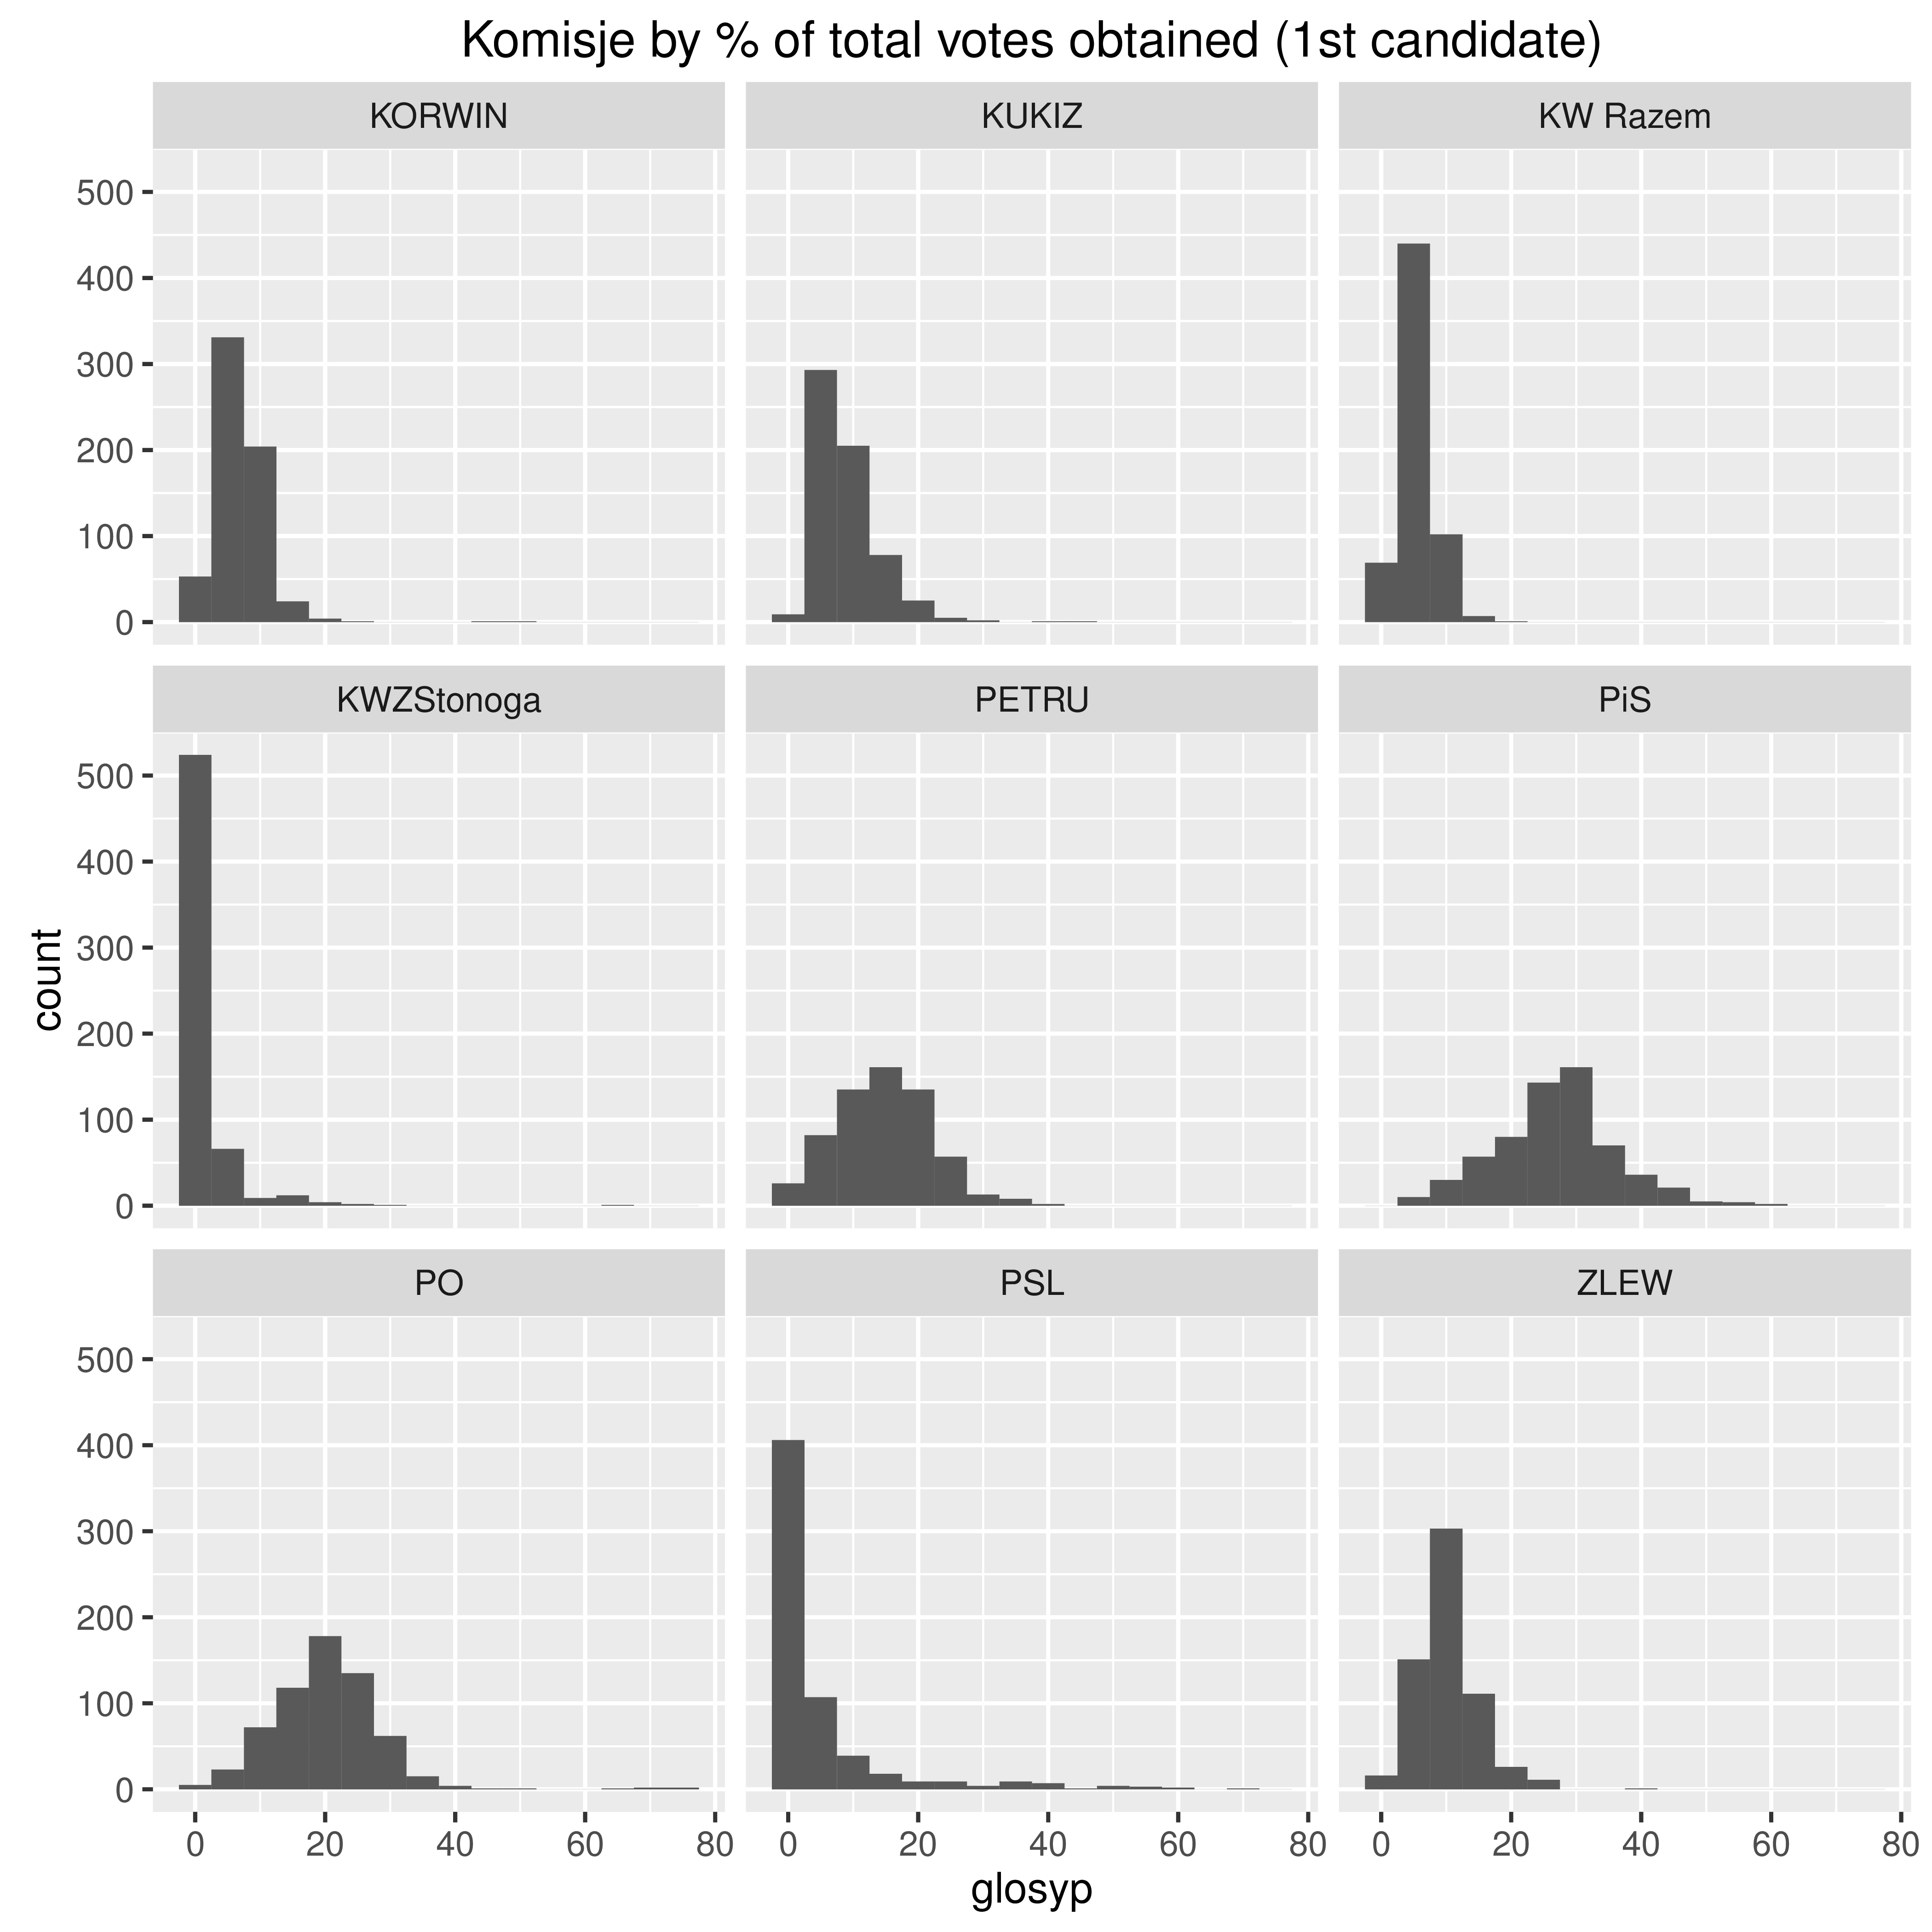
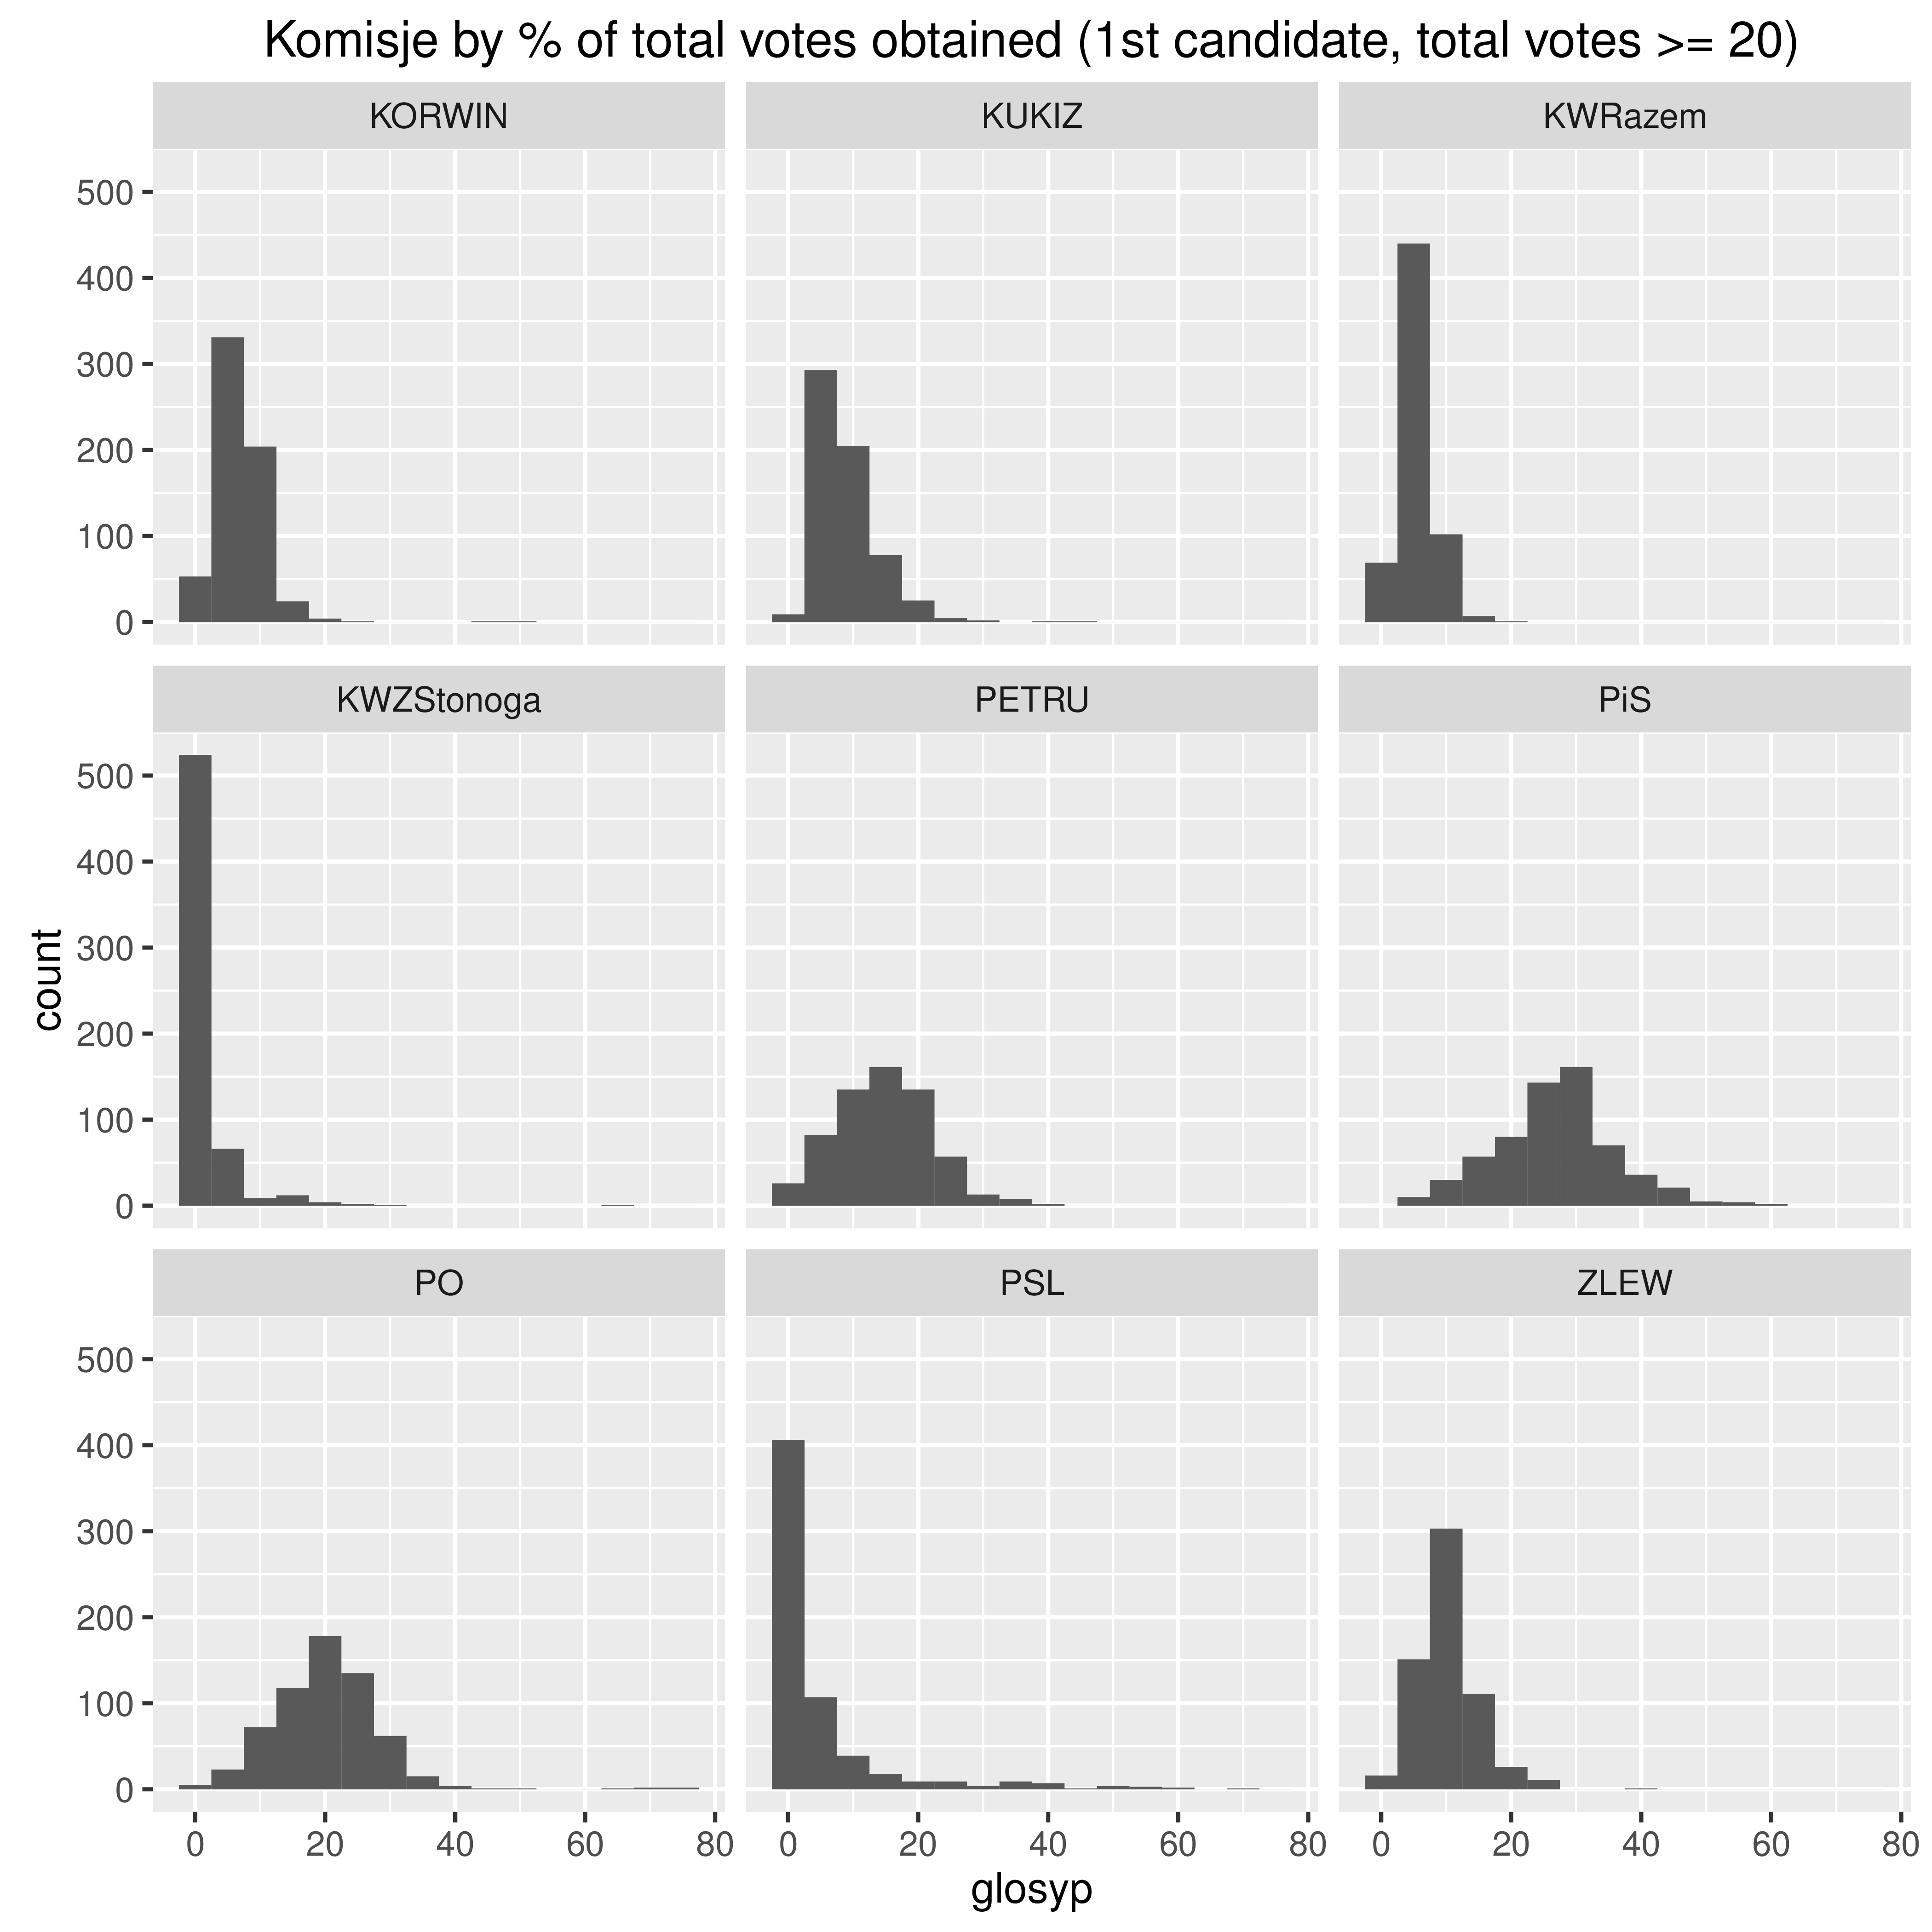
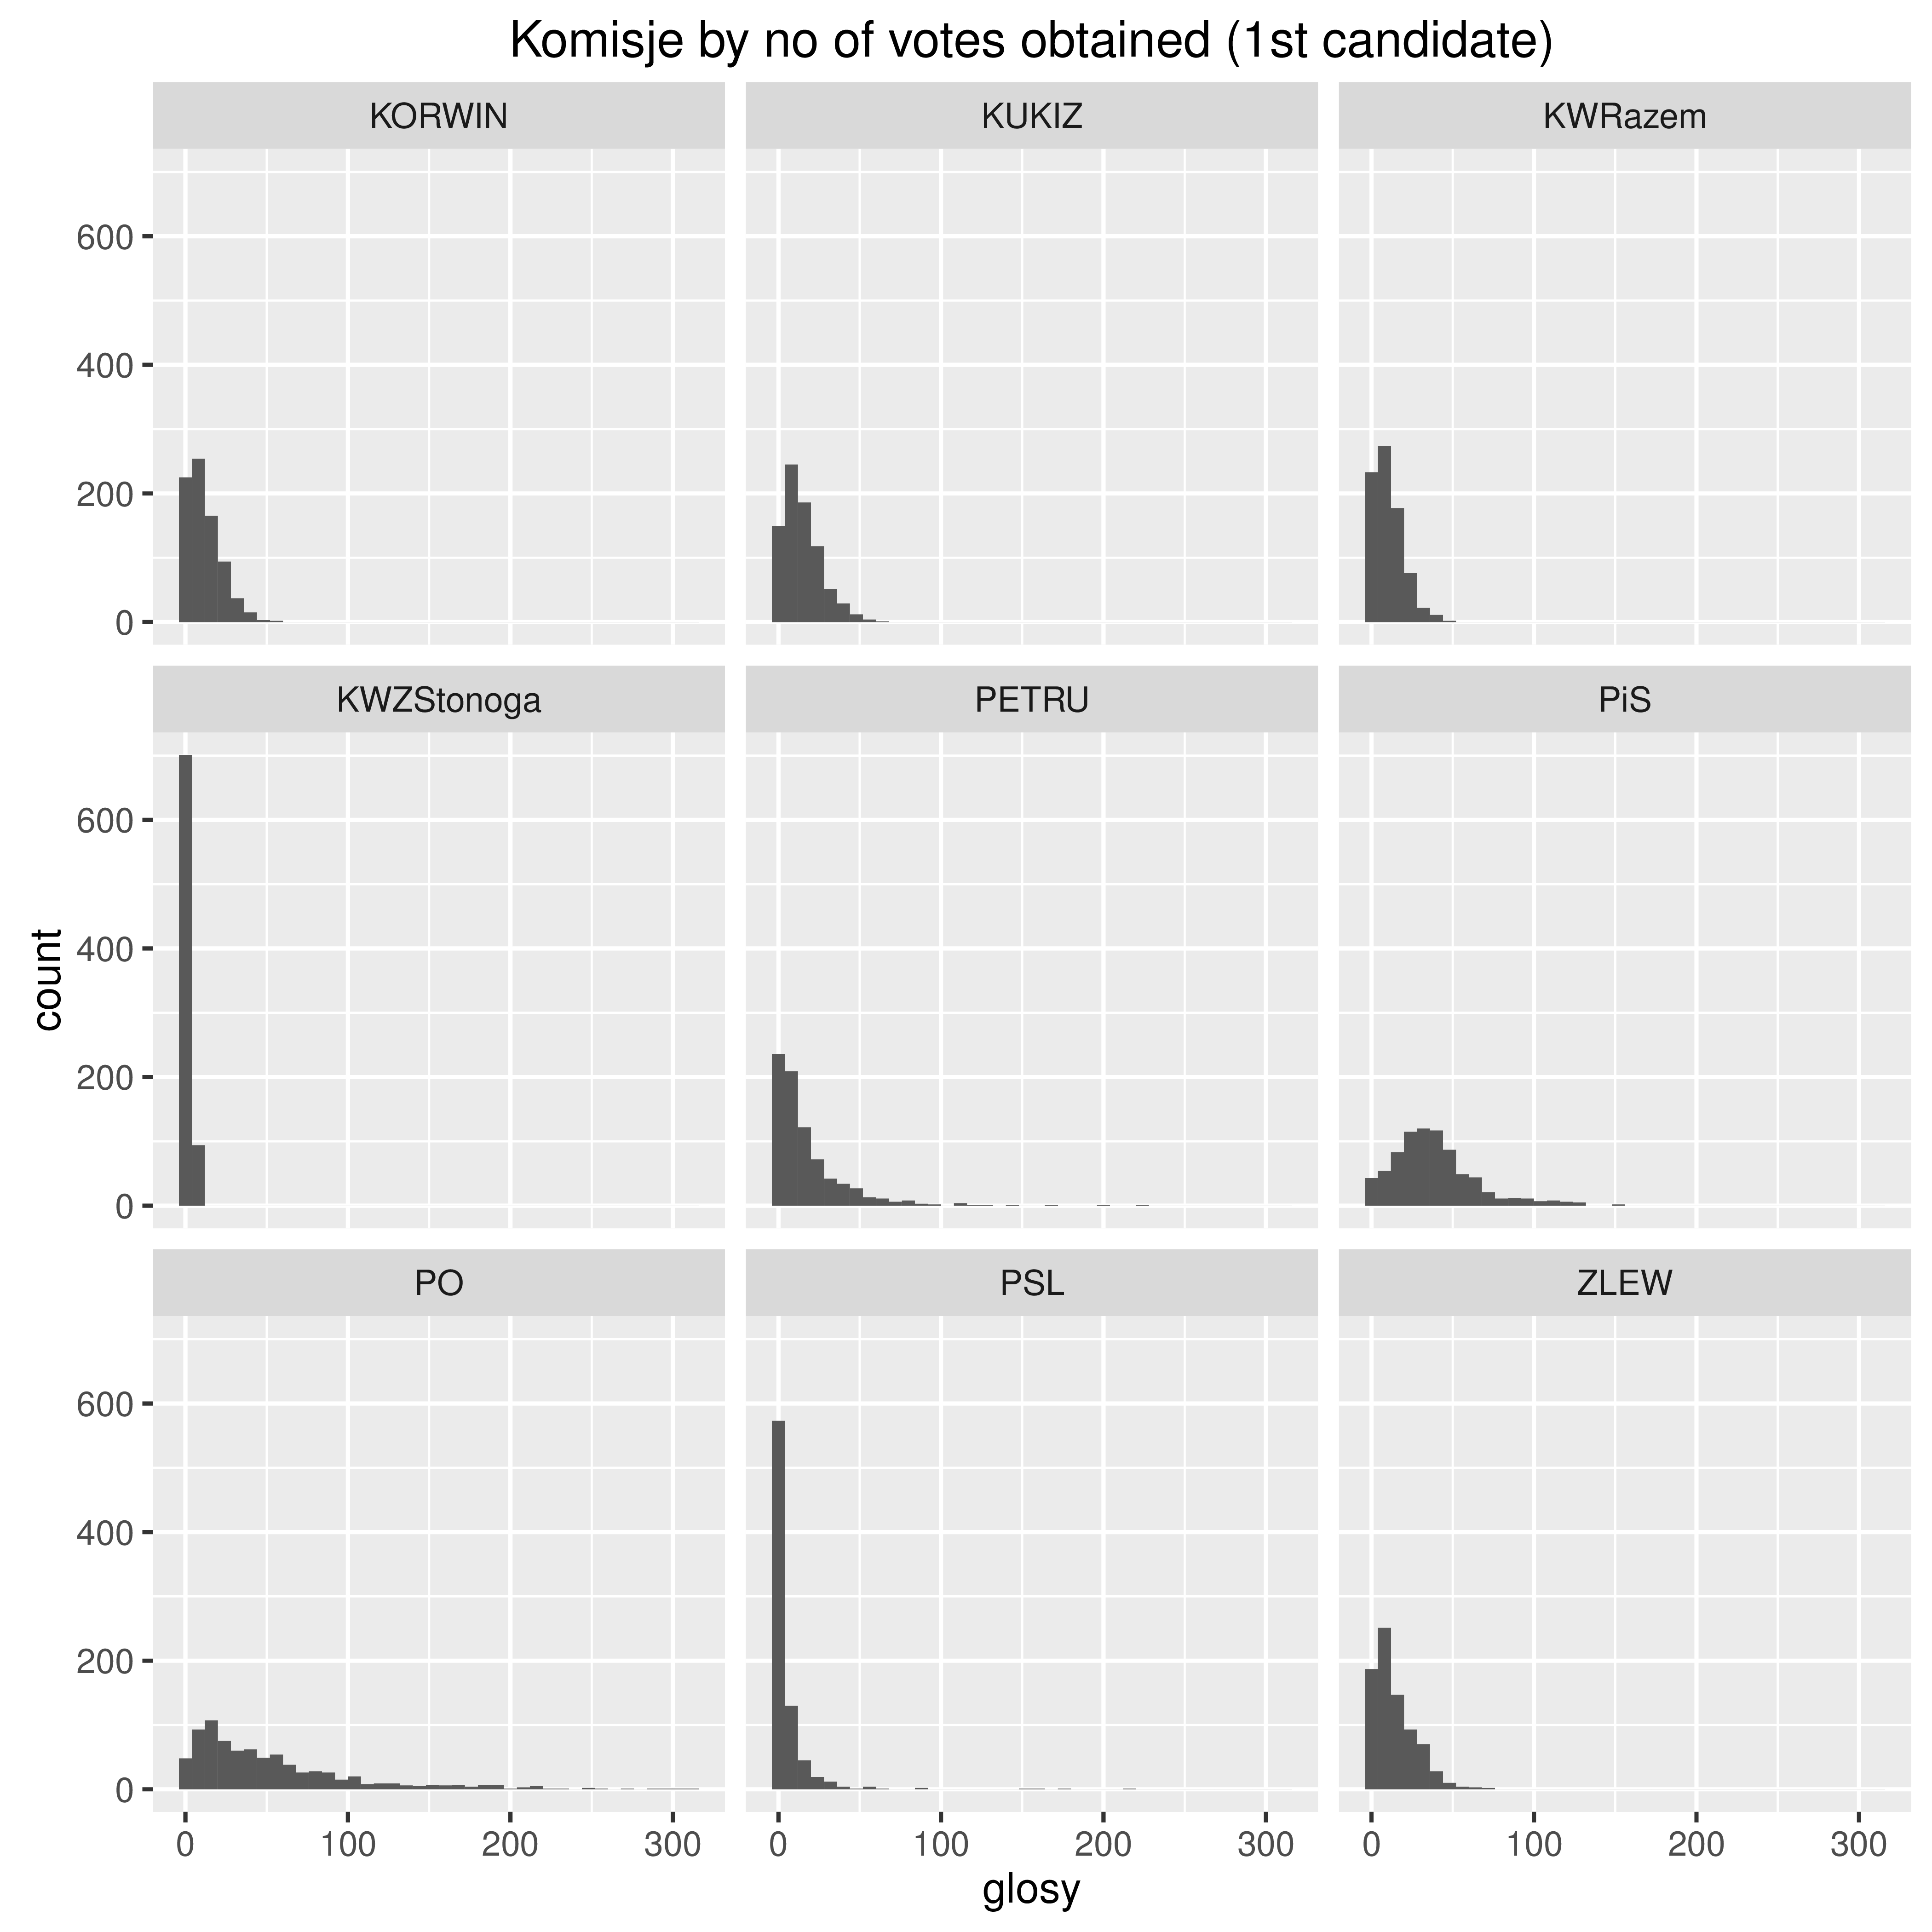
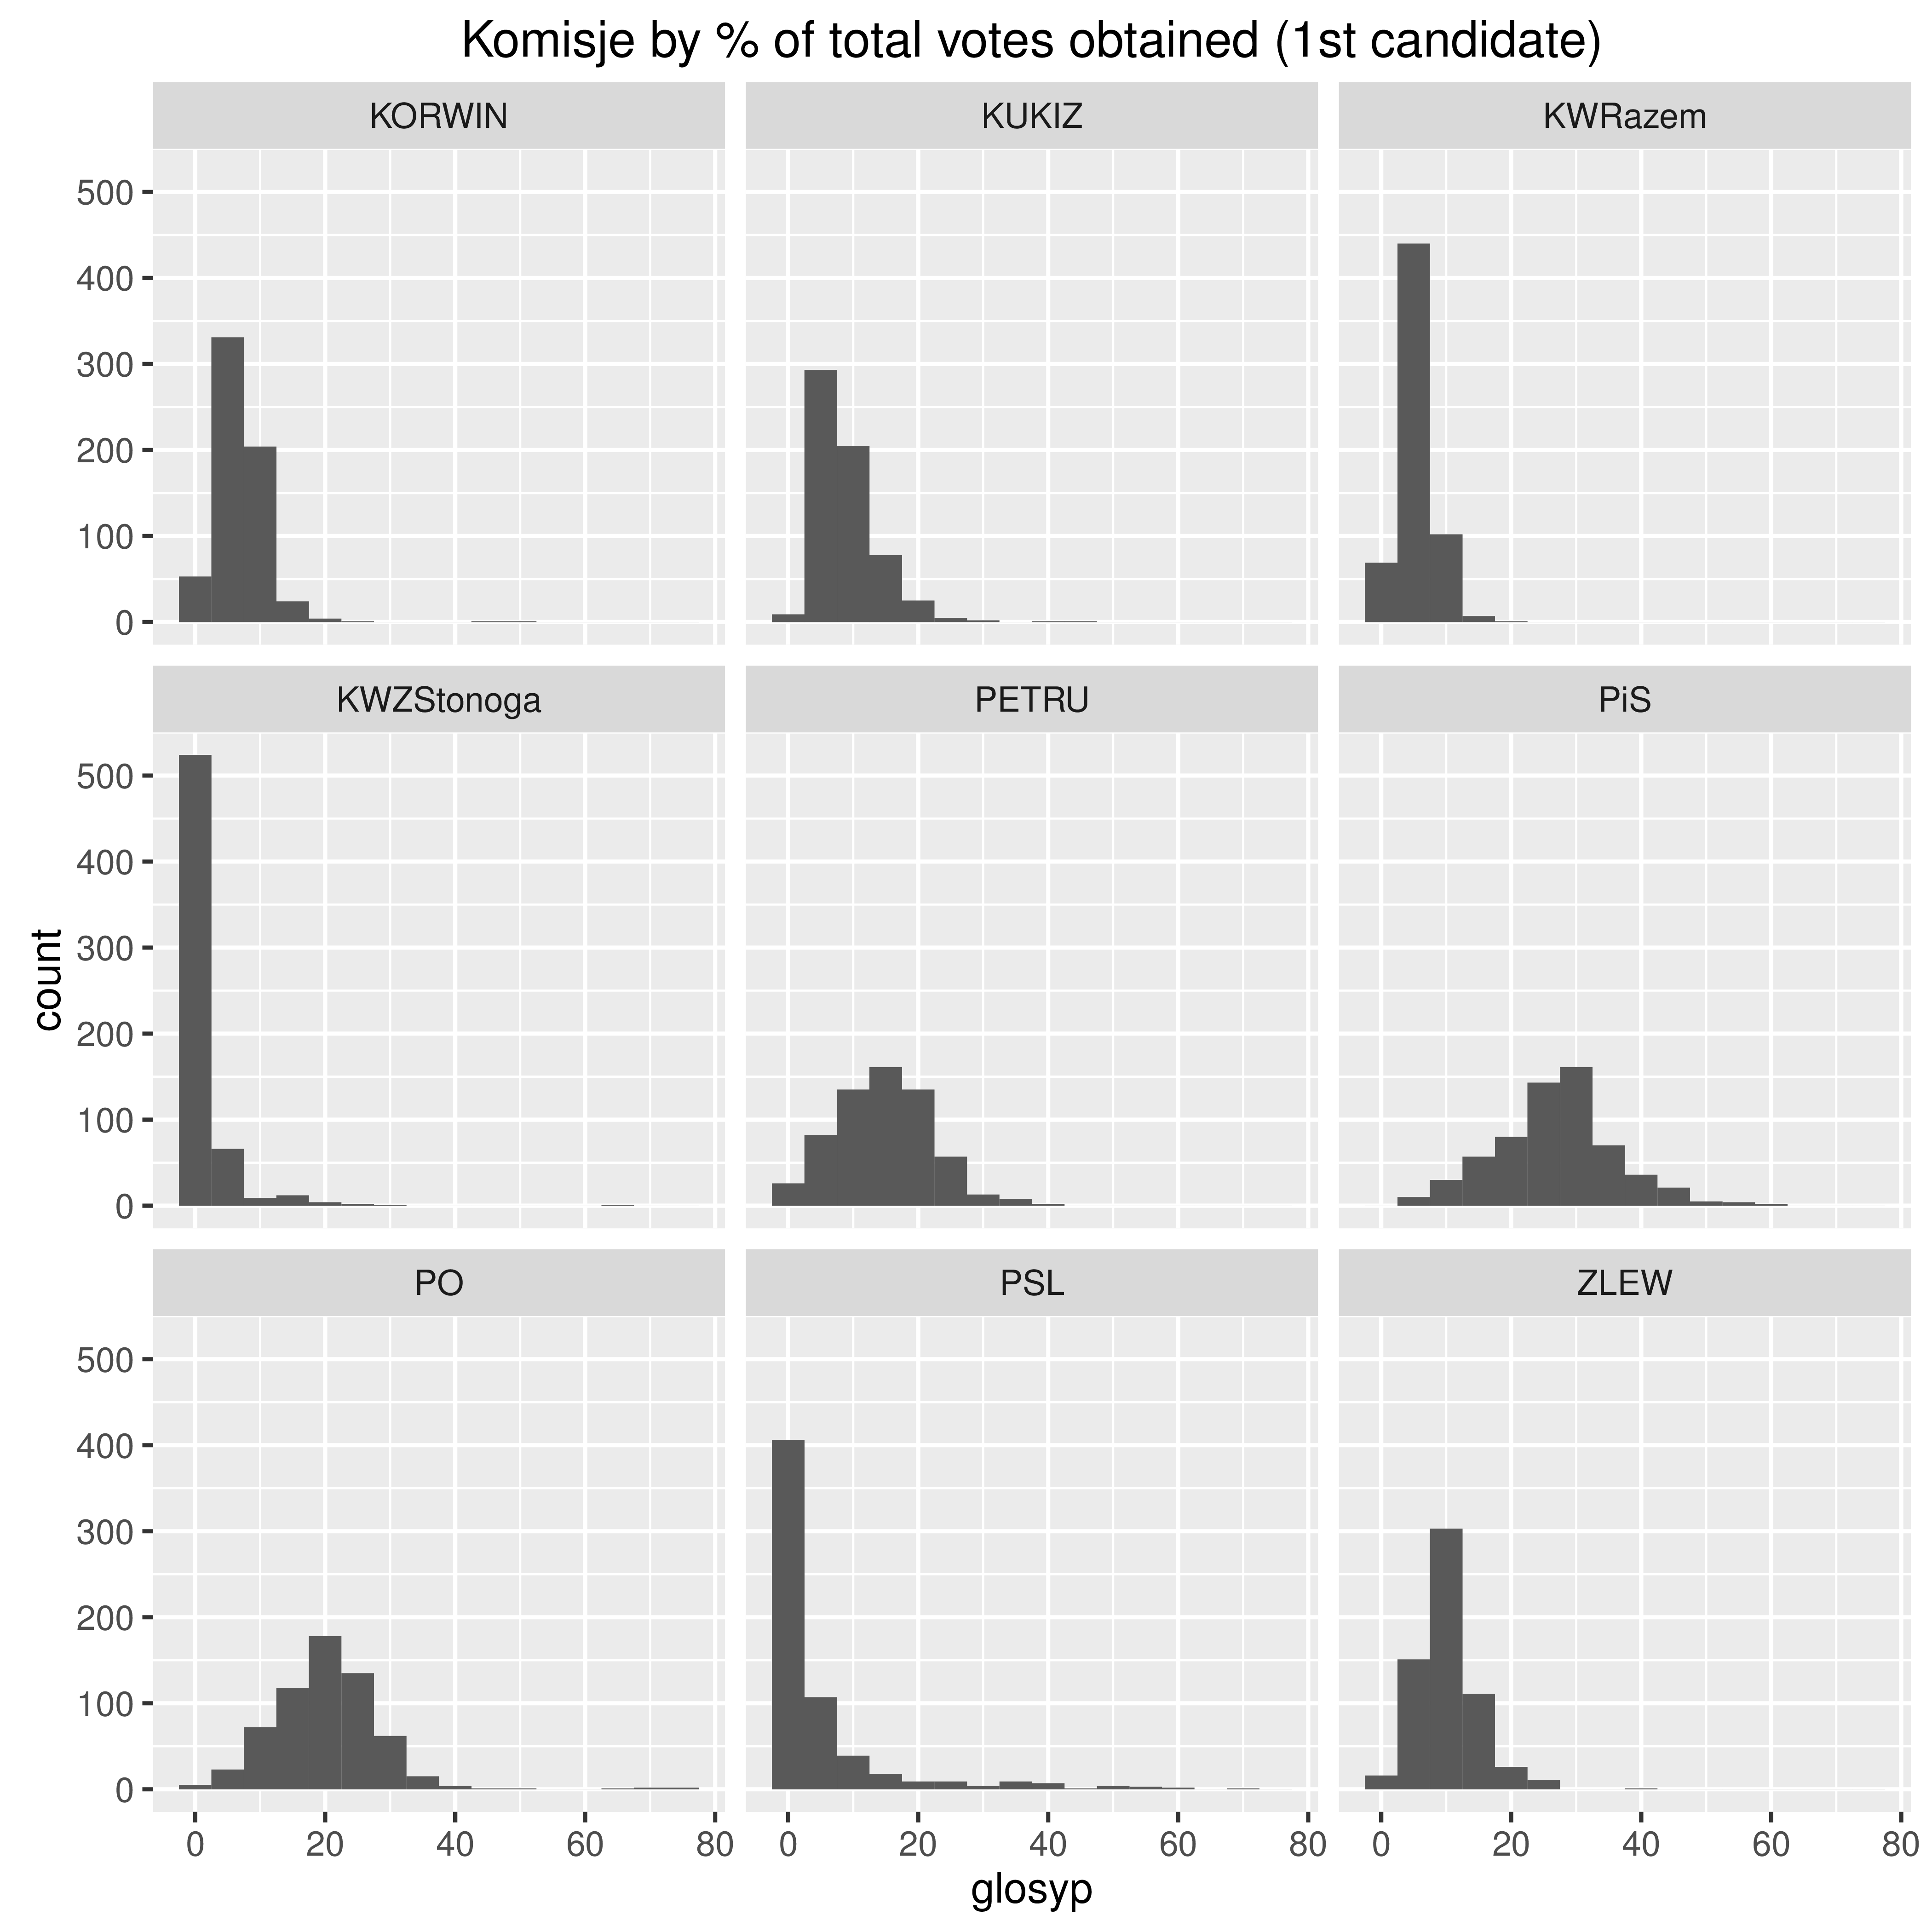
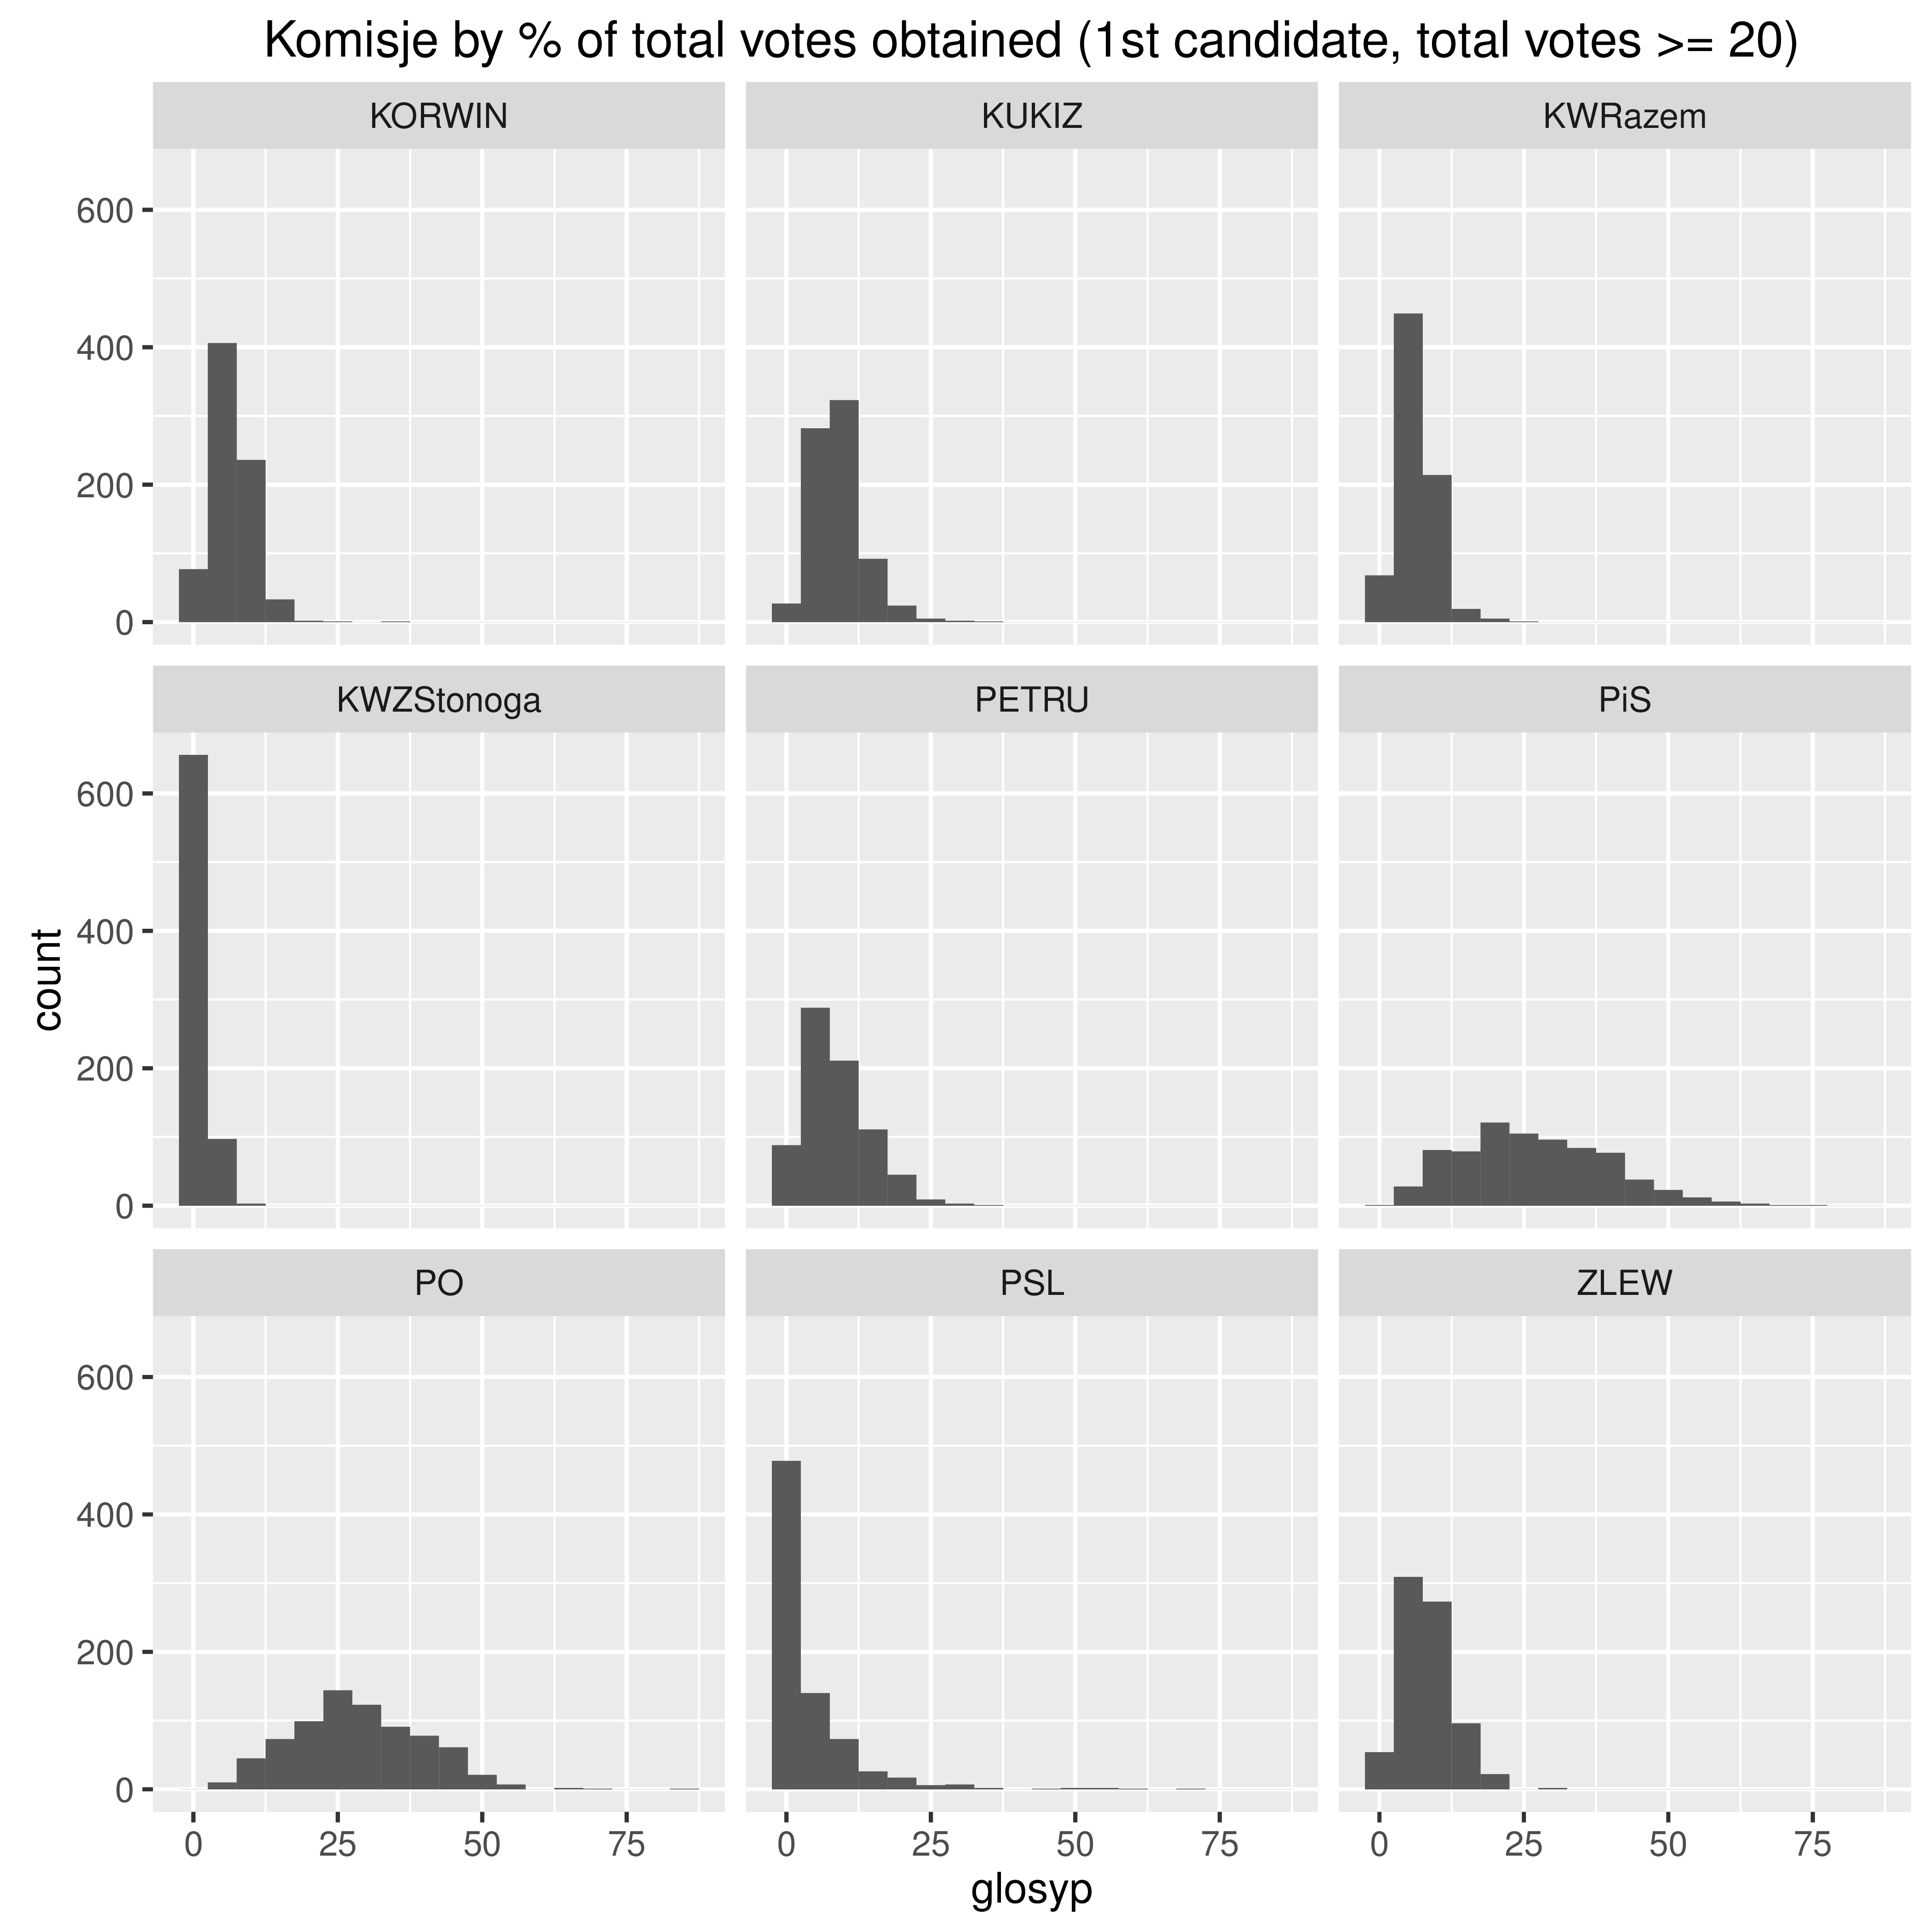
Czyli na przykład pani Hojarska dostała 1668 głosów w 656 komisjach co daje średnio 2,5 głosa/komisję (Mediana 1 głos). Rozkłady liczby głosów przedstawione w postaci wykresów słupkowych wyglądają następująco (pierwsze trzy rysunki to okręg 25, następne trzy to okręg 26):

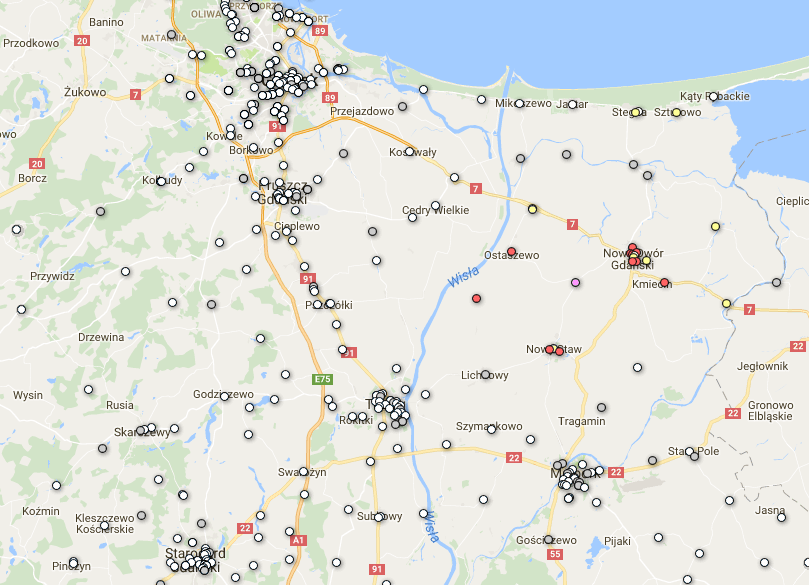
No i wreszcie przedstawienie wyników na mapie z wykorzystanie Google Fusion Tables link do GFT:

Link do danych jest tutaj.

niedziela, 25 lutego 2018

W prawe ucho lewą ręką przez poręcz

Doszedłem do punktu, w którym tylko tak mogę się podrapać:-)

Mianowicie do pisania bloga używam ciągle kodowania ISO8859-2. Chciałem zmienić na UTF-8, ale wymagałoby to pewnych zabiegów związanych z późniejszym publikowaniem. Nie wchodząc w szczegóły nie chce mi się poświęcać temu czas.

Z drugiej strony czasami ISO-8859-2 ogranicza. Na tę okoliczność wymyśliłem sprytny trick: teksty zawierająca nieincydentalne znaki spoza ISO8859-2 będę pisał w UTF-8 a potem zamienię znaki spoza zakresu ISO8859-2 na character entities typu &cośtam; a resztę przekoduję do ISO. Dało się:

  ## zmienia UTF na encje (http://billposer.org/Software/uni2ascii.html)
  uni2ascii -e -a D ekstremalna_skosnosc.bl8 > ekstremalna_skosnosc.enc
  ## zmienia encje na znaki iso8859-2 (tylko polskie znaki): 
  perl entutf2iso88592.pl ekstremalna_skosnosc.enc > ekstremalna_skosnosc.blx

Śmiesznie, ale działa. Programu uni2ascii nie było w archiwach Fedory, ale bez problemu się skompilował ze źródła.

Hojarskiej ekstremalnie skośny rozkład głosów

Uczono mnie, że współczynnik skośności aczkolwiek może przyjąć wartości większe od 3, to w praktyce taka sytuacja się nie zdarza. Dlatego z rezerwą podszedłem do obliczeń, z których wynikało, że dla pewnego zbioru danych wynosi on 14:

library(moments)
# Wynik 1-ki z listy komitetu Z.Stonogi (D.Hojarska, wybory 2015)
s <- read.csv("hojarska.csv", sep = ';', header=T, na.string="NA");
skewness(s$glosy)
[1] 14.08602

nrow(s)
[1] 657

sum(s$glosy)
[1] 1671

Pierwsza hipoteza jest taka, że formuła liczenia współczynnika może być egzotyczna. Ustalmy zatem jak toto jest liczone:

?skewness
Description:  
This function computes skewness of given data

Wiele to się nie dowiedziałem. Po ściągnięciu źródła można ustalić, że to współczynnik klasyczny czyli iloraz trzeciego momentu centralnego przez odchylenie standardowe do trzeciej potęgi. Zatem jak najbardziej klasyczny a nie egzotyczny. Sprawdźmy co wyliczy Perl dla pewności:

#!/usr/bin/perl

print STDERR "** Użycie: $0 plik numer-kolumny (pierwszy wiersz jest pomijany)\n";
print STDERR "** Domyślnie: wyniki kandydata nr1 na liście komitetu Z.Stonoga (okr.25 / D.Hojarska)\n";

$file = "hojarska.csv"; ## default file
$column = 1; ## first column = 0

if ( $#ARGV >= 0 ) { $file=$ARGV[0]; } 
if ( $#ARGV >= 1 ) { $column=$ARGV[1]; } 

open (S, "$file") || die "Cannot open $file\n";

print "\nDane z pliku $file (kolumna: $column):\n"; 
$hdr = <S> ; # wczytaj i pomin naglowek ($n będzie prawidłowe)
while (<S>) { chomp();
  @tmp = split (/;/, $_); 
  $v = $tmp[$column];
   push(@L, $v) ; 
   $sum += $v; 
   $Counts{"$v"}++;
   $n++;
}

# Wyznaczenie średniej:
$mean = $sum /$n; 

## Wyznaczenie dominanty:
## przy okazji wydrukowanie danych pogrupowanych
print "+--------+---------+--------+--------+--------+\n";
print "| Głosy  | Obwody  |  cumGł | cumGł% |  cumN% |\n";
print "+--------+---------+--------+--------+--------+\n";
$maxc = -1;
for $c (sort {$a <=> $b } keys %Counts ) { 
  $sumCum += $Counts{"$c"} * $c; 
  $nCum += $Counts{"$c"}; 
  if ($maxc_pos < $Counts{$c} ) { 
    $maxc_pos = $Counts{$c} ; $maxc_val = $c
  }
  printf "| %6d |  %6d | %6d | %6.2f | %6.2f |\n", 
    $c,  $Counts{$c}, $sumCum, $sumCum/$sum *100, $nCum/$n *100;
}
print "+--------+---------+--------+--------+--------+\n\n";

$mode = $maxc_val; # dominanta

## Wyznaczenie mediany:
$half = int(($#L +1)/2 );
@L = sort ({ $a <=> $b } @L) ; #numerycznie
##print "$half of @L\n";
$median = $L[$half];

printf "Średnie: x̄ = %.3f (N=%d) Me =%.3f D = %.3f\n", $mean, $n, $median, $mode;

## Odchylenia od średniej:
for my $l (@L) {##
  $sd1 = ($l - $mean) ; 
  $sd2 = $sd1 * $sd1; # ^2 
  $sd3 = $sd2 * $sd1; # ^3

  $sum_sd1 += $sd1; $sum_sd2 += $sd2;
  $sum_sd3 += $sd3;
}

# odchylenie std./3-ci moment:
$sd = sqrt(($sum_sd2 / $n)); 
$u3 = $sum_sd3/$n;

printf "Sumy (x-x̄): %.2f(¹) %.2f(²) %.2f(³)\n", 
   $sum_sd1, $sum_sd2, $sum_sd3;
printf "Rozproszenie: σ = %.3f µ³ = %.3f\n", $sd, $u3;

printf "Skośność: (x̄-D)/σ = %.2f", ($mean -$mode)/$sd;
printf " 3(x̄-Me)/σ) = %.2f", 3 * ($mean - $median)/$sd;
printf " (µ³/σ³) = %.2f\n", $u3/($sd*$sd*$sd);
##//

Uruchomienie powyższego skryptu daje w wyniku to samo. Moja pewność, że wszystko jest OK jest teraz (prawie że) stuprocentowa.

Wracając do R:

library(ggplot2);
p <-  ggplot(data = s, aes(x = glosy)) + geom_histogram(binwidth = 4)
p
breaks <- ggplot_build(p)$data
breaks

[[1]]
     y count   x xmin xmax      density      ncount    ndensity PANEL group
1  482   482   0   -2    2 0.1834094368 1.000000000 2628.000000     1    -1
2  140   140   4    2    6 0.0532724505 0.290456432  763.319502     1    -1
...

Pierwszy przedział jest definiowany jako (-2;2], ale z uwagi na wartość danych de facto liczy głosy w komisjach, w których Hojarska dostała 0--2 głosów (drugi to (2;6], itd) i ni cholery nie da się tego zmienić na coś bardziej zbliżonego do prawdy. Bo tak jak jest to faktycznie pierwszy przedział jest dwa razy węższy niż każdy pozostały. W szczególności prawdziwa średnia, w tym przedziale wynosi 1,259 głosa, zaś liczona jako środek przedziału przez liczebność wynosi 1.0 (482 *1/482). Wg formuły ggplota środek przedziału to zero zatem średnia też wyjdzie 0, tj. wartość jest wyznaczona z dużym/nieokreślonym błędem.

Dzieje się tak ponieważ: the histogram is centered at 0, and the first bars xlimits are at 0.5*binwidth and -0.5*binwidth. Dopiero gdy dane są dodatnie, to ggplot zaczyna od zera. No ale nasz zbiór zawiera zera i klops. Zmiana tego jest nietrywialna.

Zamiast ggplota moża użyć po prostu polecenia hist:

h <- hist(s$glosy, breaks=seq(0,max(s$glosy), by=4) )
h

$breaks
 [1]   0   4   8  12  16  20  24  28  32  36  40  44  48  52  56  60  64  68  72
[20]  76  80  84  88  92  96 100 104 108 112 116 120 124 128 132 136 140 144 148
[39] 152

$counts
 [1] 592  42   6   4   2   2   2   1   2   1   2   0   0   0   0   0   0   0   0
[20]   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   1

$density
 [1] 0.2252663623 0.0159817352 0.0022831050 0.0015220700 0.0007610350
 [6] 0.0007610350 0.0007610350 0.0003805175 0.0007610350 0.0003805175
[11] 0.0007610350 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[16] 0.0000000000 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[21] 0.0000000000 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[26] 0.0000000000 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[31] 0.0000000000 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[36] 0.0000000000 0.0000000000 0.0003805175

$mids
 [1]   2   6  10  14  18  22  26  30  34  38  42  46  50  54  58  62  66  70  74
[20]  78  82  86  90  94  98 102 106 110 114 118 122 126 130 134 138 142 146 150

No teraz liczy (prawie) jak trzeba pierwszy przedział [0;4], drugi (4;8] itd. Prawie bo na upartego pierwszy przedział jest szeroki na 5 wartości a kolejne na 4. Eh te detale i te upierdliwe zero:-)

Przy okazji się zadumałem, a cóż to jest to density. W pierwszym podejściu, że to są częstości, ale nie, bo ewidentnie nie sumują się do 1:

  ?hist
  density: values f^(x[i]), as estimated density values. If
          `all(diff(breaks) == 1)', they are the relative frequencies
          `counts/n' and in general satisfy sum[i; f^(x[i])
          (b[i+1]-b[i])] = 1, where b[i] = `breaks[i]

No dość kryptycznie, ale można się domyśleć, że nie $\sum_i d_i =1$, ale $\sum_i d_i * w_i$, gdzie $w_i$, to szerokość przedziału $i$ (a $d_i$ oznacza gęstość w przedziale $i$ oczywiście). Pole pod krzywą będzie zatem równe 1, jak tego należy się spodziewać po gęstości.

Wprawdzie już to padło mimochodem wyżej, ale analizowany zbiór danych to liczba oddanych głosów na numer jeden na liście komitetu wyborczego Zbigniewa Stonogi w okręgu wyborczym 25 w wyborach do Sejmu w 2015 roku. Tym numerem jeden była Danuta Hojarska, która faktycznie dostała 152 głosy w jednej komisji (we wsi, w której mieszka) oraz 0--4 głosów w 90% pozostałych komisjach (w tym 0 głosów w 191/657.0 = 29% komisjach).

Analiza przestrzenna

Ze starych zapasów odgrzebałem plik CSV ze współrzędnymi obwodowych komisji wyborczych i połączyłem go z wynikami uzyskanymi przez Hojarską z zamiarem wyświetlenia tego na mapie za pomocą Google Fusion Tables (GFT):

obwod;coordexact;glosy;icon
101884;54.2701205 18.6317438;3;measle_white
101885;54.260714 18.6282809;0;measle_white
101886;54.262187 18.632082;2;measle_white
101887;54.257501 18.63147;1;measle_white
101888;54.25786 18.6306574;7;measle_grey
...

Kolumna icon zawiera nazwę ikony, która jest definiowana wg schematu: 0--3 głosy biala (measle_white); 4--9 głosów szara (measle_grey) 9-19 głosów żółta (small_yellow) 20--99 głosów czerwona (small_red) 100 i więcej głosów purpurowa (small_purple). Zestawienie dostępnych w GFT ikon można znaleźć tutaj. Konfigurowanie GFT aby korzystała z kolumny z nazwami ikon sprowadza się do wyklikania stosownej pozycji (Configure map →Feature map →Change feature styles →Use icon specified in a column.)

Przy okazji odkurzyłem zasób skryptów/zasobów używanych do geokodowania i/lub przygotowywania danych pod potrzeby GFT, w szczególności: joincvs.pl (łączy dwa pliki csv w oparciu o wartości n-tej kolumny w pierwszym pliku oraz m-tej kolumny w drugim); geocodeCoder0.pl (uruchamia geokodera Google). Oba skrypty i jeszcze parę rzeczy można znaleźć: tutaj.

środa, 21 lutego 2018

time plot tygodniowej liczby twitów

Załóżmy, że plik CSV zawiera liczbę opublikowanych twitów (dane tygodniowe). Problem: przedstawić szereg w postaci przebiegu czasowego (time plot). Taki skrypt R wymyśliłem do zrealizowania tego zadania:

require(ggplot2)

args <- commandArgs(TRUE)
ttname <- args[1];
file <- paste(ttname, ".csv", sep="")
filePDF <- paste(ttname, ".pdf", sep="")

d <- read.csv(file, sep = ';',  header=T, na.string="NA", );
## Plik CSV jest postaci:

##str(d)

## wiersze 1,2 + ostatni są nietypowe (usuwamy)
rows2remove <- c(1, 2, nrow(d));
d <- d[ -rows2remove, ];

## szacujemy prosty model trendu
lm <- lm(data=d, posts ~ no ); summary(lm)
posts.stats <- fivenum(d$posts);
posts.mean <- mean(d$posts);
sumCs <- summary(d$posts);

otherc <- coef(lm);
# W tytule średnia/mediana i równanie trendu
title <- sprintf ("Weekly for %s # me/av = %.1f/%.1f (y = %.2f x + %.1f)", 
  ttname, sumCs["Median"], sumCs["Mean"], otherc[2], otherc[1] );

##str(d$no)
## Oś x-ów jest czasowa
## Skróć yyyy-mm-dd do yy/mmdd
d$date <- sub("-", "/", d$date) ## zmienia tylko pierwszy rr-mm-dd
d$date <- sub("-", "", d$date) ## usuwa mm-dd
d$date <- gsub("^20", "", d$date) ## usuwa 20 z numeru roku 2018 -> 18
weeks <- length(d$no);
## https://stackoverflow.com/questions/5237557/extract-every-nth-element-of-a-vector
## Na skali pokaż do 20 element /dodaj ostatni `na pałę' (najwyżej zajdą na siebie)
## możnaby to zrobić bardziej inteligentnie ale nie mam czasu
scaleBreaks <- d$no[c(seq(1, weeks, 20), weeks)];
scaleLabs <- d$date[c(seq(1, weeks, 20), weeks)];

ggplot(d, aes(x = no, y = posts)) +
  geom_line() +
  ggtitle(title) +
  ylab(label="#") +
  xlab(label=sprintf("time (yy/mmdd) n=%d", weeks )) +
  scale_x_continuous(breaks=scaleBreaks, labels=scaleLabs) +
  geom_smooth(method = "lm")

ggsave(file=filePDF)  

środa, 14 lutego 2018

Wycieczka do Lizbony 2018


Fatima

Dorsz czyli Bacalhau

Ciastka

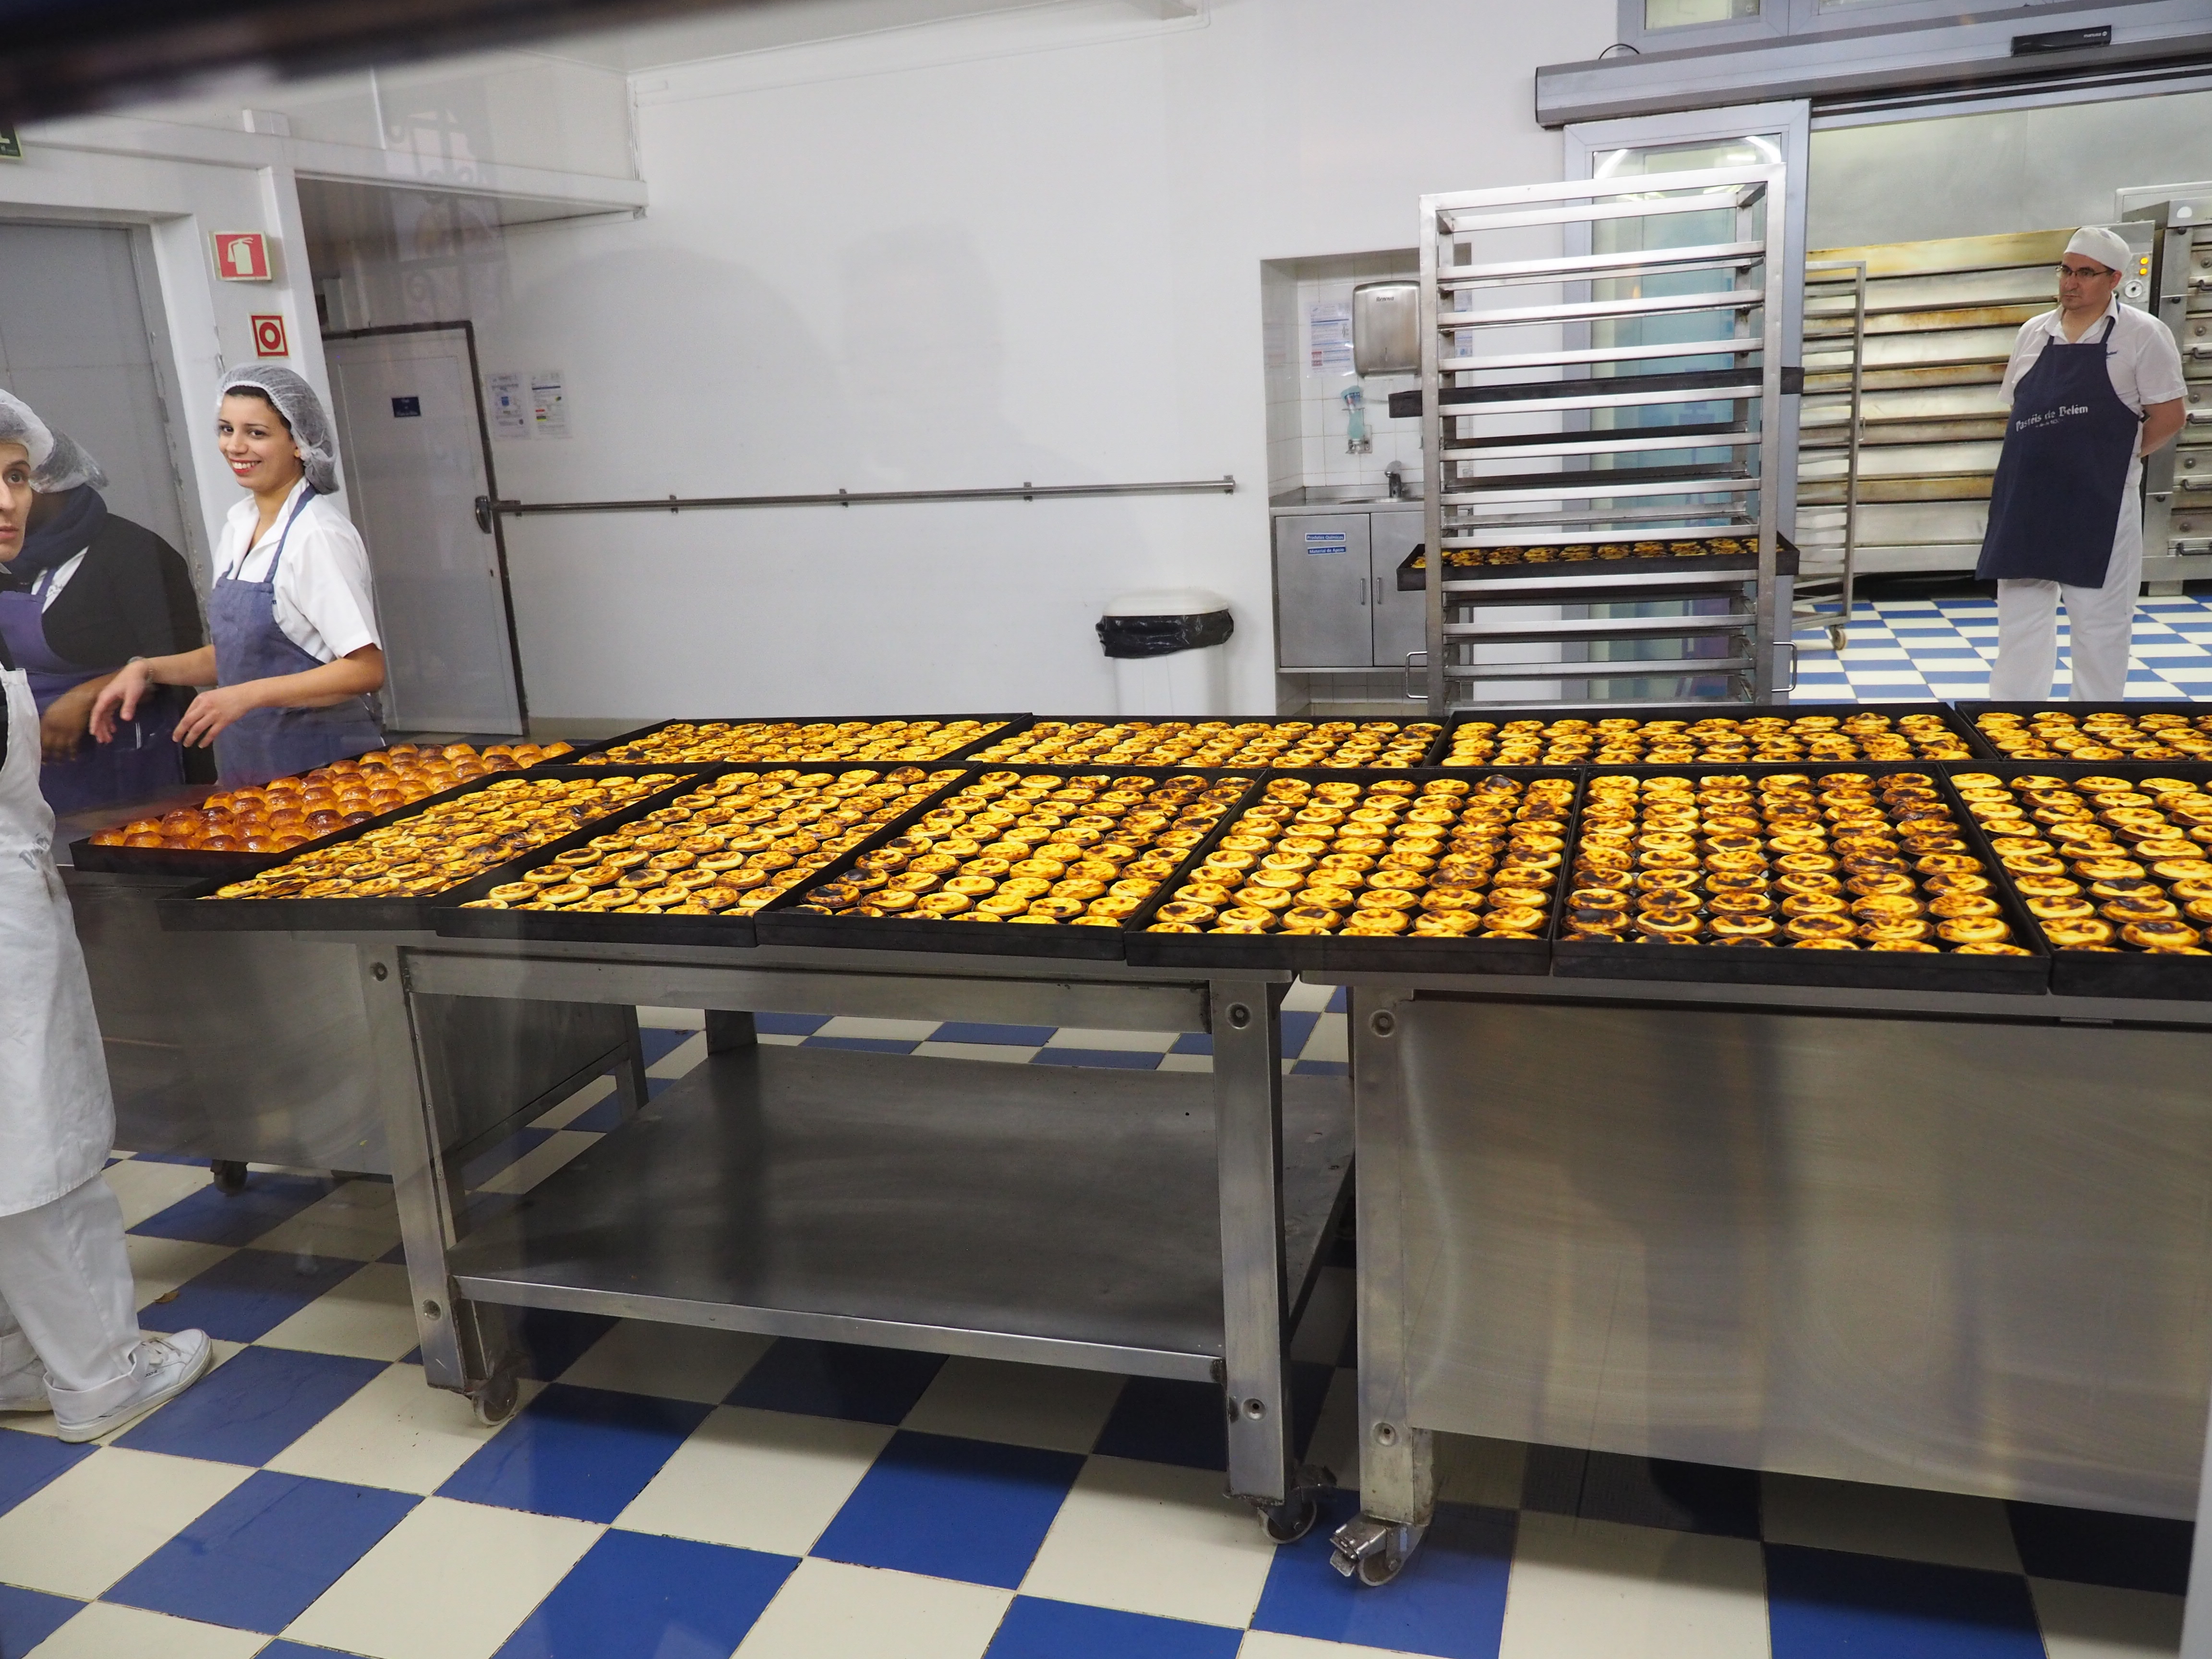
Słynna Pasteis de Belem

GDP Pocket

Szóstego lutego pojechaliśmy do Portugalii. Wizzair lata konkretnie z GDA do Lizbony.

Nasza kwatera była w centrum: 25 Rua do Cardal de S. José (25 to numer domu). Pod numerem 23 jest restauracja i tam urzęduje współwłaściciel. Z metra to 200m faktycznie:

You can also come with the underground. The access is nearby the exit of the airport. Line red til the end. Change for the blue line direction santa Apolonia, stop Avenida station. The apartment is located at some 200 metros.

Pobyt wyglądał tak, że #1 dzień: stare miasto, zamek św Jerzego oraz muzeum kafli ceramicznych (azulejos). Dzień #2: Fatima. Dzień #3: Sintra a konkretnie zwiedzanie dwóch pałaców tj. Palácio Nacional de Sintra + Quinta_da_Regaleira + wejście pod pałac Pena. Do pałacu Pena nie weszliśmy, bo była kiepska pogoda/gęsta mgła, więc i tak by było kiepsko widać z zewnątrz, a w środku to tam za dużo nie ma do oglądania. Poza tym byliśmy już zmęczeni. Za to po powrocie do Lizbony weszliśmy do muzeum pieniądza -- ale nie było warto (wstęp jest za darmo więc jak komuś się nudzi...) Dzień #4: Belem a konkretnie klasztor Hieronimitów (grobowiec v.d. Gammy) oraz Muzeum Morskie. W Belem była też czasowa wystawa grafik Eschera, ale się okazało, że wstęp za 11EUR więc nam przeszła chęć oglądania Eschera.

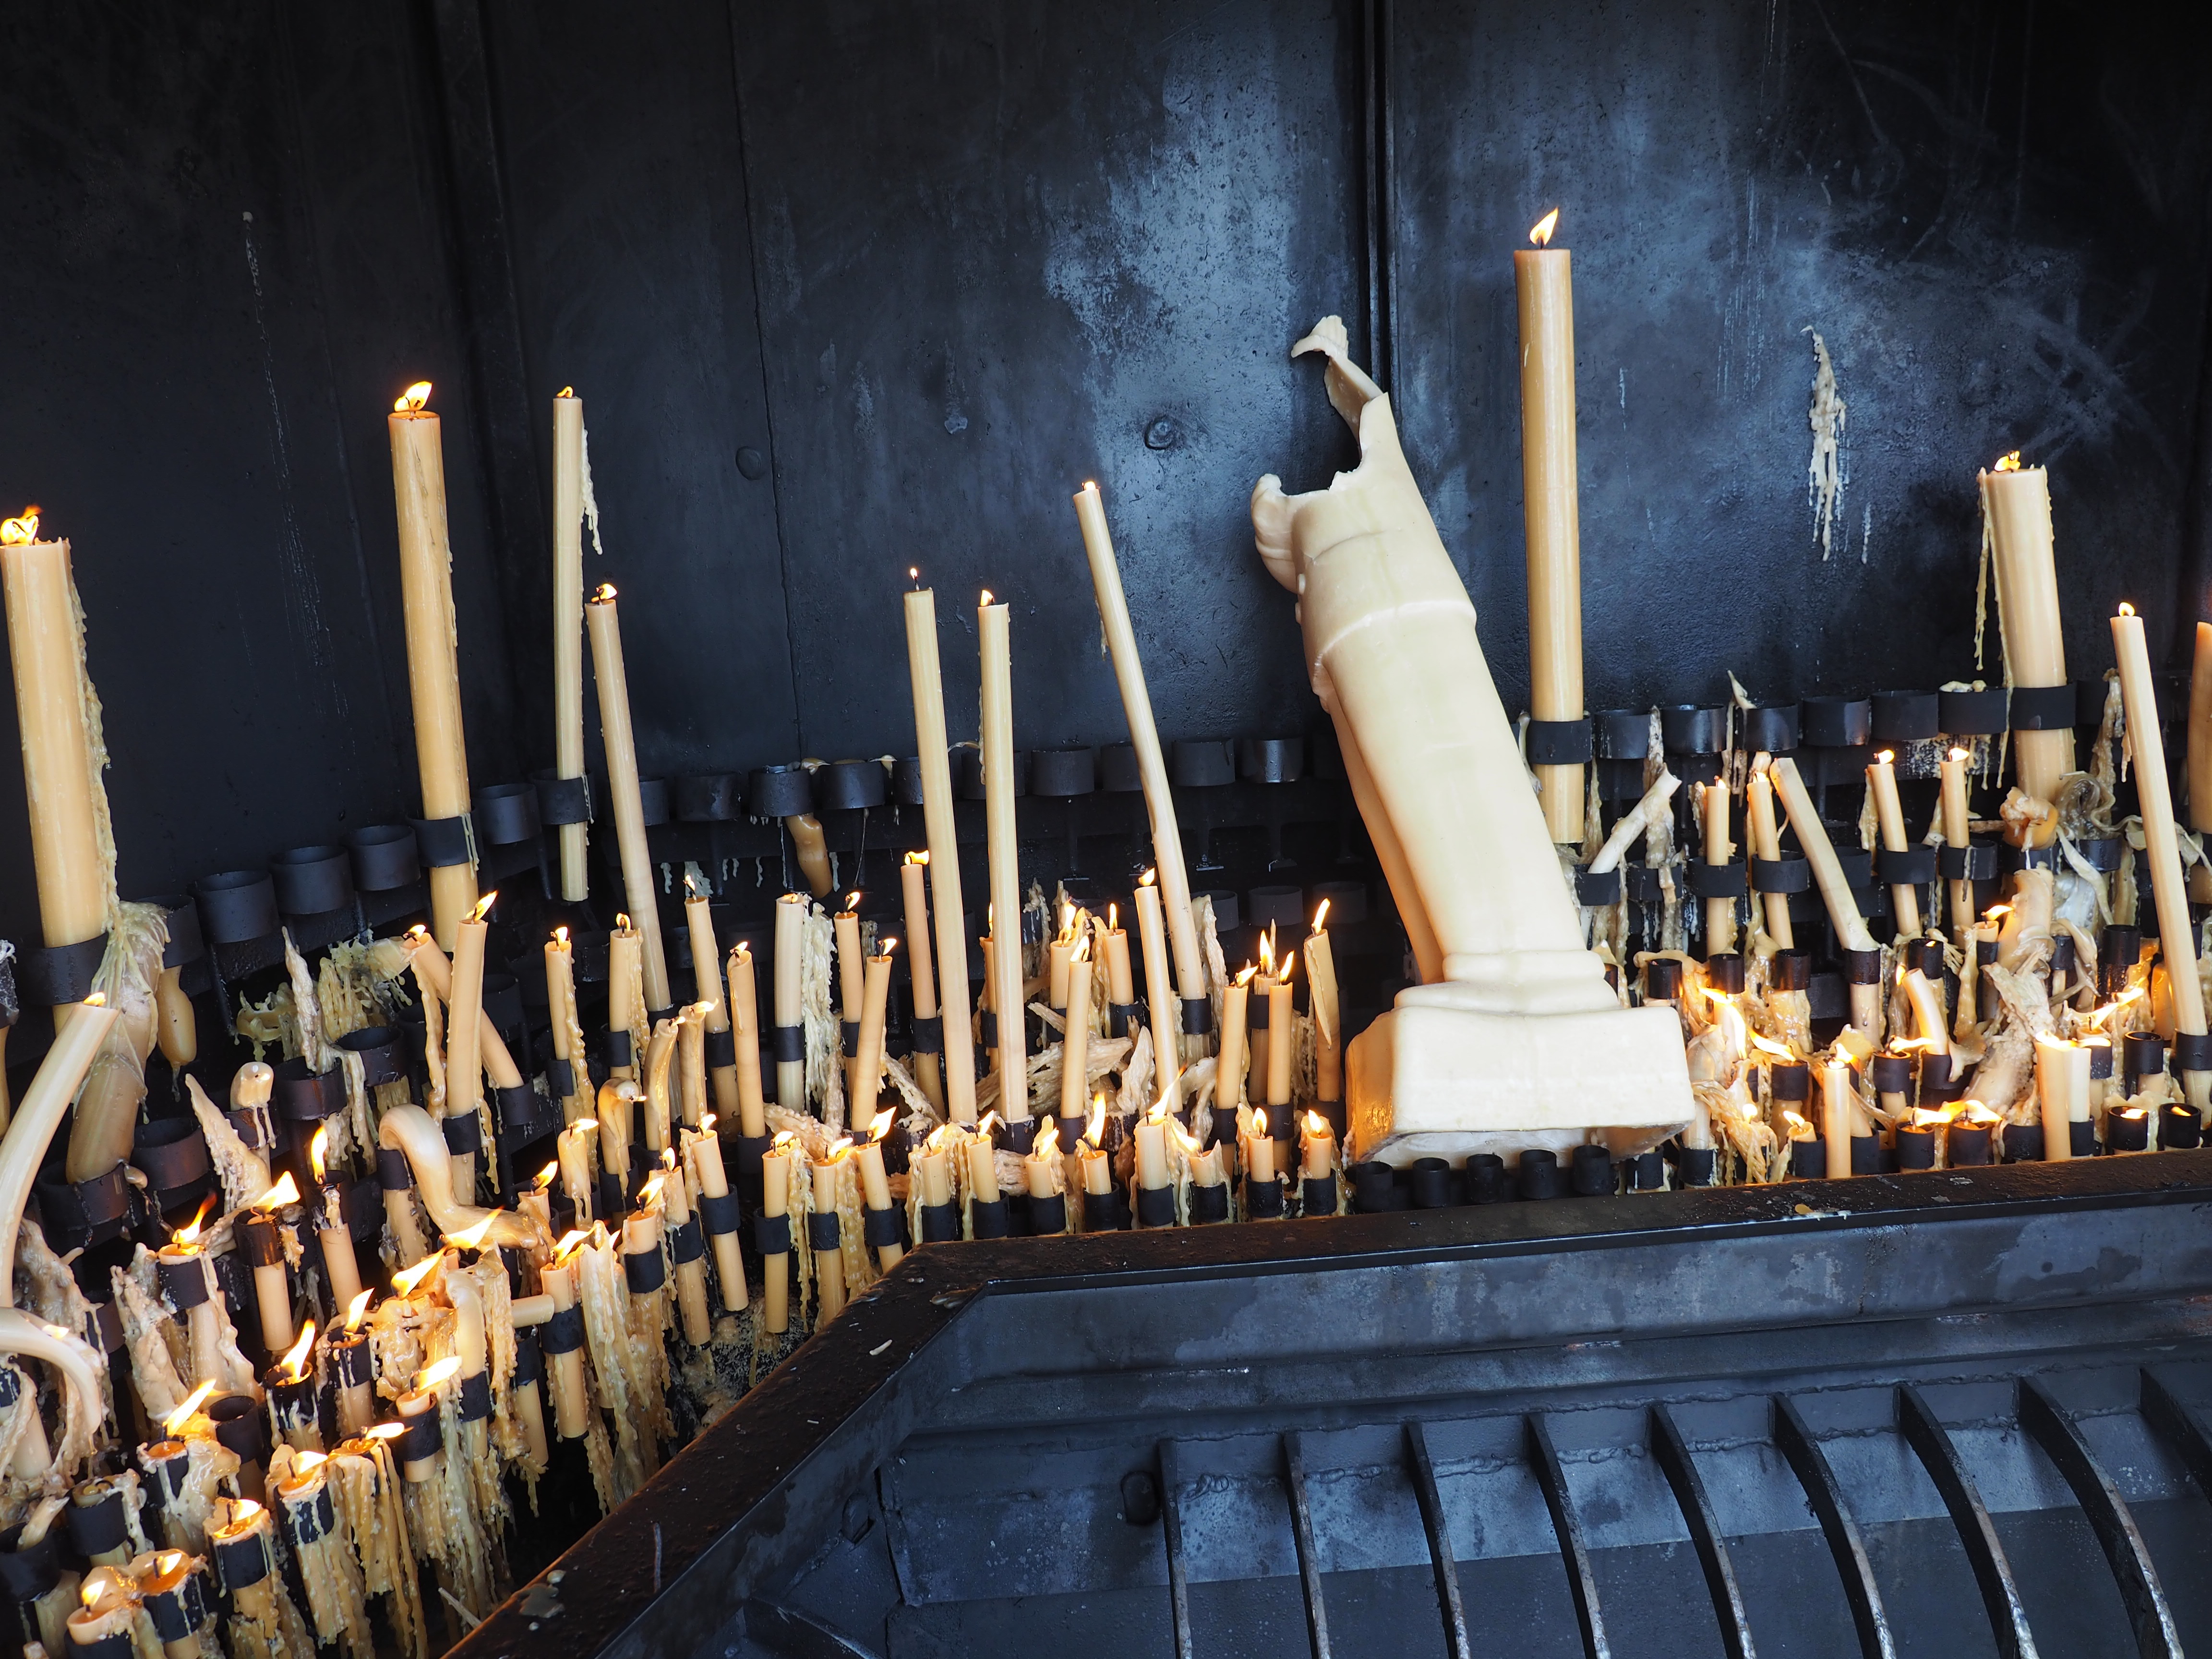
Wracając do dnia #2 czyli do Fatimy, to w szczególności ciekaw byłem konfrontacji opowieści W. Cejrowskiego z cyklu Boso przez świat z rzeczywistością. Ja przynajmniej po obejrzeniu Cejrowskiego odniosłem wrażenie niesłychanego skrzywienia w stronę komercji i dziwnych zabobonów, tj. że są tutaj jakieś gigantyczne wielkopowierzchniowe sklepy z dewocjonaliami, na których sprzedaje się masowo bardzo dziwne rzeczy typu woskowe organy ludzkie, które potem płoną na ogromnych stosach... Rzeczywistość nie potwierdziła tej wizji, nawet bym powiedział, że WC mocno przesadził. Owszem są sklepy, owszem sprzedaje się świece w kształcie organów, ale zarówno te sklepy nie są wcale gigantyczne jak i te dziwne dewocjonalia są marginesem. Jest też jeden całkiem mały budynek przeznaczony na spalenie świec ofiarnych (por. zdjęcie obok). Sklepy są wielkości tych z Częstochowy a dziwne świece stanowią margines -- dominują tradycyjne przedmioty, takie jak figura Matki Boskiej. Uwaga na koniec: podczas naszego pobytu Fatima była prawie pusta -- być może wrażenie jest inne podczas popularnych uroczystości kościelnych.

Co do kosztów to wydaliśmy 2700PLN na dwie osoby w tym 890 na bilety lotnicze + 520 PLN na kwaterę (4 noce x 2 osoby via AirBnB). W Sintrze wydaliśmy 40 EUR (2x pałac, tj. 4 bilety + dojazd) a w Fatimie 50 EUR (4x bilet autobusowy 2 x tam + 2 x stamtąd po 12,50 EUR). Bilet do muzeum morskiego 6.50EUR (warto), Azulejos 5.00 (też warto) Klasztor i zamek po circa 10EUR.

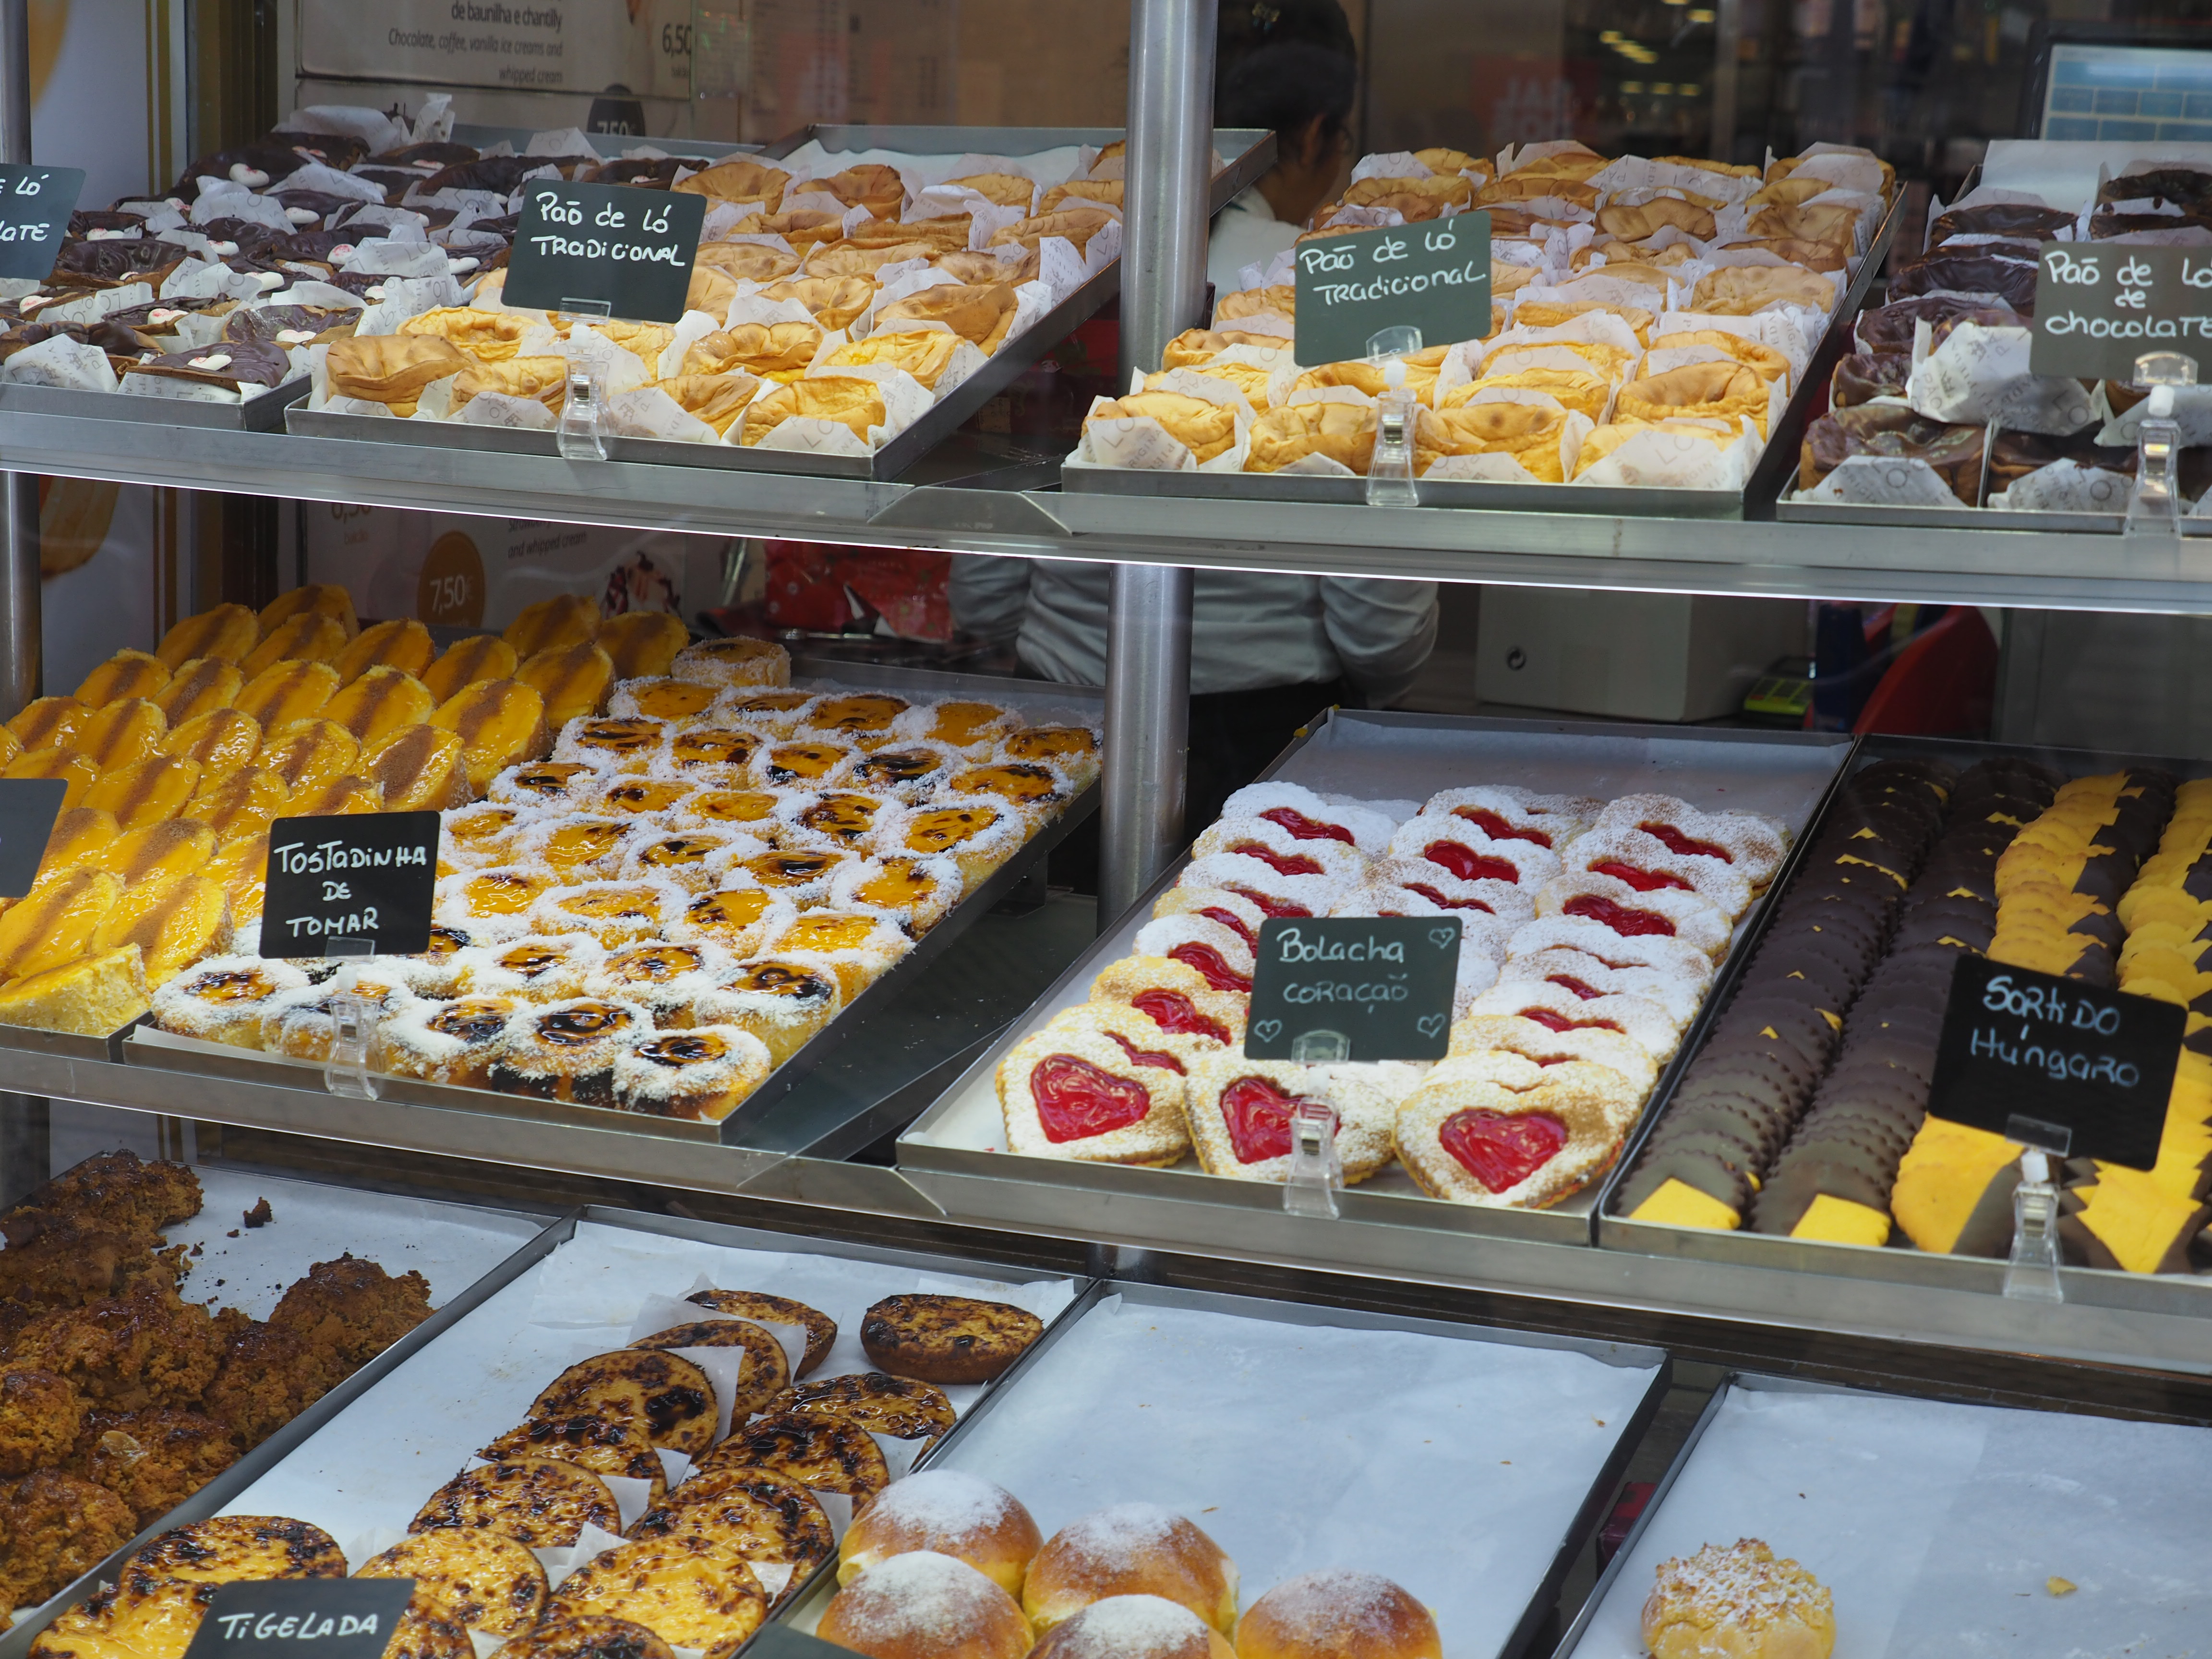
Rzucało się w oczy dla przybysza z kraju Biedronki tysiąca małych biznesów, a sklepów wielko czy średnio powierzchniowych jak na lekarstwo. Wśród sklepów #1 jest cukiernia/cukiernio-kawiarnia. Oni muszą pochłaniać ogromne ilości ciastek, które są mocno słodzone i zwykle nadziewane budyniem. Z zazdrością zauważyłem, że tego po miejscowych nie widać (że tyle cukru jedzą). W centrum Lizbony można też było spotkać małe-rodzinne sklepy spożywcze, sklepy AGD, księgarnie. Wygląda że wszystko to ma klientów i jakoś tam prosperuje...

W aspekcie sportowo-rekreacyjnym odniosłem za to wrażenie, że na rowerach to oni tu nie jeżdżą--być może wynika to z ukształtowania terenu. Na pewno w centrum Lizbony jeżdżenie na rowerze przy tamtejszych nachyleniach i wąskich ulicach to dla niewyczynowca mordęga. Trochę ludzi za to biega (po bruku--brrrr), nawet wcześnie rano widziałem takich zapaleńców. O tyle bieganie rano ma sens (w centrum), że nie ma ruchu (no i oczywiście zdaję sobie sprawę, że wielu biega rano bo potem leci do roboty.)

Przed wycieczką (z myślą o minimalizacji bagażu, ale także z planami wykorzystania w pracy) nabyłem najmniejszy laptop świata czyli GDP Pocket. Mało to on nie kosztował, ale sprawdził się. W wolnych chwilach doinstalowałem zresztą na nim prawie wszystko co mam na normalnym laptopie (bo zresztą na normalnym mam taki sam dysk jak na GP -- 120Gb), łącznie z TeXem, R oraz Pythonem i Perlem.

BTW na GDP Pocket jest dostępne Ubuntu i może bym i go zainstalował, gdyby nie plany używania tego urządzenia także w pracy -- Windows jednak jest bardziej kompatybilne ze wszystkim.

Samolot do GDA mieliśmy o 22.00, ale na lotnisko żeśmy się zwinęli już o 18:30, bo Elka była padnięta, a poza zwiedzaniem nie mieliśmy koncepcji co robić. W GDA byliśmy 02:30 nad ranem, przywitani zimą i -4C. W tamtą stronę podróż była mocno niekomfortowa, a to dlatego że było ciasno (rząd 28) a dwa rzędy przed nami rozkoszne Ruskie zresztą dziecię grało (bez słuchawek) w jakąś durną grę na konsoli. Powrotna za to była super komfortowa--mieliśmy miejsca w 4-tym rzędzie i wydaje mi się, że tam fotele są rzadziej rozstawione. No i nie było żadnego wkurwiającego ruskiego rebionka z konsolą.

Do pobrania ślady kml ze zdjęciami; zdjęcia; ślady gpx/kml.

Migracja do Debian Stretch na jupiterze (svn)

Się poprzedni wpis kończył jakoby odtworzenie repozytorium svn było prostą sprawą, ale w praniu się okazało, że nie do końca:

# zapisanie starego
svnadmin dump svnrepo > svnR.out
# odtworzenie
svnadmin create svnrepo
svnadmin load svnrepo < svnR.out

Próba zapisu skutkuje komunikatami o błędach. No tak zachciało mi się zmienić port na niestandardowy. Żeby svn wiedział jak się połączyć trzeba dopisać (na koncie komputera klienta, w sekcji [tunnels]):

vi ~/.subversion/config
ssh = $SVN_SSH ssh -q -p PORTNUMBER
# addgroup svn
Adding group `svn' (GID 1002) ...
# gpasswd -a "tomek" svn
##Adding user tomek to group svn
# chgrp -R svn path-to-svnrepo

Teraz

svn info
Ścieżka: .
Working Copy Root Path: /home/tomek/orgfiles
URL: svn+ssh://tomek@umbriel/media/usbstick/svnrepo/tp/orgfiles
...

## Zmień svn+ssh://tomek@umbriel/path-to-repo na nowe:
svn relocate svn+ssh://tomek@umbriel/path-to-repo/path-to-project

Staszek Wawrykiewicz

Staszek Wawrykiewicz zginął 7 lutego 2018 roku w dziwacznych okolicznościach (cytat z Dziennika Bałtyckiego):

W środę 7 lutego wyszedł na spacer by w marinie dojrzeć wschód słońca. Kamery miejskiego monitoringu zarejestrowały jak stoi na oblodzonym pomoście. Za chwilę obiektyw rejestrował inne miejsce, a kiedy zwrócił się ponownie na pomost, Stanisława już na nim nie było. Mężczyzna poślizgnął się i wpadł do wody. Niestety, drabinki, które umożliwiają wyjście z wody, rozmieszczone są w znacznych odległościach od siebie. Biorąc pod uwagę temperaturę wody, ubranie, które mężczyzna miał na sobie i szok termiczny, którego doznał, nie był w stanie wydostać się o własnych siłach z wody. Przyjmujemy, że doszło do nieszczęśliwego wypadku. -- informuje asp. szt. Tomasz Frąckowiak, naczelnik wydziału prewencji Komendy Miejskiej Policji w Sopocie.

Staszek był znany z udzielania się na dwóch polach: piosenki turystycznej (BAZUNA etc) oraz systemu składu tekstów TeX. Ja go znałem od circa 1990 roku bo obaj byliśmy użytkownikami TeXa, aktywnymi członkami GUSTu. Staszek mieszkał w Sopocie (tak jak ja), w odległości mniej niż 1km od mojego bloku.

sobota, 3 lutego 2018

Migracja do Debian Stretch na jupiterze

Jupiter to mój niepubliczny serwer. Podłączona do niego jest stacja pogody, termometry DS18B20, wykonywane są kopie zapasowe oraz założone repozytorium CSV. No i to powodowało że zabierałem się do aktualizacji systemu jak do jeża. Wszystko było tak stare, że już zapomniałem jak działa--a że działało, to teoretycznie nie było potrzeby wymiany.

Z drugiej strony jednak: system był już tak wiekowy, że niepielęgnowany. Nic nie można było ani doinstalować ani uaktualnić. Ponadto na drugiej szewie była inna wersja -- uruchamiany z karty SDHC Debian Lenny. Uruchamianie z karty (zamiast tego co jest wbudowane w komputerek) wydaje mi się bardziej eleganckie after all. No więc sytuacja dojrzała...

Obejrzałem sobie pliki crontab (roota i jedynego użytkownika tomek) i ustaliłem co trzeba uruchomić: rsync do robienia kopii zapasowych (nie pamiętam jak); pywwws do pobierania danych ze stacji pogodowej i wysyłania na wundergroud oraz jakieś skrypty Perla do prezentowania danych pogodowych na stronie pinkaccordions.blogspot.org (nie pamiętam jak to było konfigurowane); wreszcie odtworzenie repozytorium svn, którego używam na potrzeby wewnętrzne.

  ## Pobranie instalacja:
  root@umbriel:/home/tomek# pip install pywws
  Collecting pywws
  Downloading pywws-17.11.0.tar.gz (465kB) ....

  ## Testowania czy działa:
  root@umbriel:/home/tomek# pywws-testweatherstation
  10:52:45:pywws.Logger:pywws version 17.11.0, build 1380 (b01d94a)
  0000 55 aa 80 10...
  
  ## pakiet został umieszczony tutaj:
  /usr/local/lib/python2.7/dist-packages/pywws
  
  ## Inicjalizacja (/media/usbstick/Logs/weather/ to katalg z danymi)
  python -m pywws.LogData -vvv /media/usbstick/Logs/weather/
  ## Tutaj jest plik konfigurujący
  vi /media/usbstick/Logs/weather/weather.ini

  ## musiałem dodać typ stacji: ws type = 1080
  ## Wpis do Crontaba
  ## Dane pogodowe z WS1080
  ## 9 * * * *  /usr/local/bin/pywws-hourly -v /media/usbstick/Logs/weather >> \
  ##   /media/usbstick/Logs/root/weather/Hourly.log 2>&1

Wszystko działa but the wundergound. Trzeba dokonfigurować plik weather.ini, żeby pywwws wysyłało tam stosowne dane.

[underground]
station = IPOMORSK8
password = <PASSWORD>
template = default

[hourly]
services = ['underground']
text = []
plot = []

Dokładnie ma być jak wyżej underground a nie wunderground, bo tak się nazywa plik (/usr/local/lib/python2.7/dist-packages/pywws/services/).

Ponieważ mam dwie stacje (druga kupiona w projekcie, który nie został w końcu zrealizowany), to podłączyłem to drugą, do komputera z Debian Lenny (tego uaktualnię za czas jakiś, żeby mieć to samo na obu). Z tym drugim był większy problem bo w systemie nie ma pipa (pipy?)

#http://pywws.readthedocs.io/en/latest/guides/getstarted.html#test-weather-station
# stacja #2 ::

wget --no-check-certificate https://pypi.python.org/packages/49/ed/cd05eff0177b569c60230db5c13aded51355aada59f7f9d441d2d1353c4f/pywws-17.11.0.tar.gz
tar -zxvf pywws-17.11.0.tar.gz 
cd pywws-17.11.0
python setup.py build
python setup.py install

wget --no-check-certificate https://pypi.python.org/packages/fc/38/026f001aa0cf2656a3e52556be73cb2a84fc7f6f40ae1bf75099cb6fa3ea/libusb-1.0.21b1.zip
unzip libusb-1.0.21b1.zip 
cd libusb-1.0.21b1
python setup.py build
python setup.py install

wget --no-check-certificate https://pypi.python.org/packages/ec/5d/4fdac6c53525786fe35cff035c3345452e24e2bee5627893be65d12555cb/libusb1-1.6.4.tar.gz
tar -zxvf libusb1-1.6.4.tar.gz 
cd libusb1-1.6.4
python setup.py build
python setup.py install

neptune:/home/tomek# mkdir /media/patriot/Logs
neptune:/home/tomek# mkdir /media/patriot/Logs/weather
neptune:/home/tomek#  python -m pywws.LogData -vvv /media/patriot/Logs/weather/
09:27:28:pywws.Logger:pywws version 17.11.0, build 1380 (b01d94a)
09:27:28:pywws.Logger:Python...

## Na stronie wunderground dodałem drugą stację, po czym
## dopisałem co trzeba do weather.ini
vi /media/patriot/Logs/weather/weather.ini

[underground]
station = ISOPOT14
password = <PASSWORD>
template = default

Obie działają

Kopie zapasowe

No robię kopie, chociaż nie były mi potrzebne przez 6 lat eksploatacji moich komputerków. Strategia jest taka, że co tydzień robię kopię całego systemu a co 24h wybranych katalogów. Wszystko w sumie prosto ale problem pojawił się w przypadku tworzenia kopii na innym komputrze:

#!/bin/bash
# Kopią jest cały system na innym komputerze (neptune):
SOURCE=neptune::wholefs/
ROOTLOG=/media/usbstick/Logs/root/RSync/rsync-neptune.log

EXCLUDE=/root/.rsync/backup_exclude_neptune.lst
DESTDIR=/public/sheeva/backup/neptune/rootfs
COPYDIR=/public/sheeva/backup/neptune
rsync -av --bwlimit=500 --exclude-from=${EXCLUDE} --delete ${SOURCE} ${DESTDIR}

## Edytujemy /etc/rsyncd.conf
max connections = 2
log file = /var/log/rsync.log
timeout = 300

[share]
comment = Public Share
path = /home/share
read only = no
list = yes
uid = nobody
gid = nogroup
auth users = tomek
secrets file = /etc/rsyncd.secrets

##  Zawartość rsyncd.secrets

/etc/rsyncd.secrets
user:<PASSWORD>

## /etc/hosts
#Dopisane
192.168.1.142   neptune.pinaccordions.org       neptune
     
## na neptune konfiguracja demona
/etc/rsyncd.conf
hosts allow = 192.168.1.121

Sprawdzenie czy działa

rsync neptune::wholefs/

Svn

Prosta sprawa

# zapisanie starego
svnadmin dump svnrepo > svnR.out
# odtworzenie
svnadmin create svnrepo
svnadmin load svnrepo < svnR.out

Ponieważ mam trzy sheevy, miałem ten komfort że uruchomiłem zapasową, na której wszystko dokonfigurowałem. Ta nowa którą nazwałem umbriel przejęła zadania starej, którą po 6 latach wyłączyłem. Zamiast jupitera jest zatem umbriel (księżyc Urana), bo jupiter się mi już znudził.

poniedziałek, 22 stycznia 2018

Protest przeciwko zachowaniu

Kuriozum goni kuriozum. Robiący wiatr od 2 lat debile (KOD, i inni) protestowali 17.01.2018 przeciw (zachowaniu się :-) opozycji. Czemu debile?

Bo działają jak debile. Większość parlamentarna nie uchwali ustawy zgłoszonej przez mniejszość, to jest oczywiste. Że nie przyjmie ustawy sprzecznej ze swoim programem -- podwójnie oczywiste. Po cóż więc tracić czas na projekt mający dokładnie 0 (zero) szans powodzenia na realizację, i z tego powodu wszczynać kryzys?

Jeżeli z powodów czysto wizerunkowo-propagandowych, to kto-kogo bardziej oszukał? Biernacki przecinający PR-owy balon od razu, czy ci co chcieli gonić zajączka dalej? No i wreszcie z punktu widzenia elementarnych zasad demokracji parlamentarnej: oszukali was?, to głosujcie na innych. To takie proste. Ale tych innych-ni-ma, i tu jest problem. Stąd pewnie ,,protest przeciwko zachowaniu'' (domagamy się zmiany ,,zachowania''). Arbitrzy elegancji się kurna znaleźli...

It is better to keep your mouth closed and let people think you are a fool than to open it and remove all doubt.

niedziela, 14 stycznia 2018

Finis pseudoelit?

Wpis pro memoria, bo to co się dzieje teraz w pale się nie mieści. Zatem kalendarium pokrótce:

9 stycznia 2018. Tzw. wielka rekonstrukcja rządu, w tym pozbycie się A. Macierewicza. Część tzw. twardego elektoratu PiS demonstruje jawnie wielkie rozczarowanie. Pachnie problemami dla partii rządzącej, potencjalnym podziałem. AntyPiS ma nadzieję--wydaje się uzasadnioną. Przew. Schetyna wieszczy wojnę domową. Wygląda na poważny kryzys... (szczegóły tutaj)

Dzień po, czyli 10 stycznia w Sejmie procedują (pierwsze czytanie) tzw. obywatelskiego projektu ustawy pn O prawach kobiet i świadomym rodzicielstwie. Ustawa jest światopoglądowa, a dobrą tradycją jest nie zarządzania dyscypliny w takich sprawach, zwłaszcza w partiach światopoglądowo zróżnicowanych. Ww. Schetyna uważa inaczej--Platforma Obywatelska jest jedynym klubem (chyba), w którym taką dyscyplinę zarządzono. Nb. ustawa nie ma szans na uchwalenie (co jest oczywiste--przecież partia rządząca nie uchwali ustawy zgłoszonej przez opozycję i to taką z pianą na pysku chociażby dlatego, że dziwne byłoby branie na siebie odpowiedzialności za realizowanie nie swojego programu wyborczego -- przecież PiS nie obiecywało w tym temacie złagodzenia ustaw w/s aborcji czy obowiązkowej edukacji/indoktrynacji seksualnej dzieci) i jest wysoce beznadziejna merytorycznie.

Projekt zostaje odrzucony i nie przechodzi do prac w komisjach. Staje się tak z powodu dziwnej obstrukcji ze strony części posłów opozycji (dziwnej bo w sumie nie wiadomo czym motywowanej). Otóż 40% Nowoczesnej i 25% posłów PO nie popiera wniosku o dalsze procedowanie projektu, który to wniosek popierają źli ludzie z PiS typu prezes, b. minister Macierewicz czy Krystyna Pawłowicz. Wywołuje to szok, oburzenie i niedowierzanie:-) Trzech posłów PO zostaje usuniętych z partii...

W mediach, także antPiSowych, następuje wysyp opinii/komentarzy/analiz, iż opozycja jest beznadziejna i potrzebna jest inna, nowa. 2 lata wysiłków antyPiSa poszło się bujać albo inaczej: po 2 latach intensywnych wysiłków antyPiS jest dużo głębiej w ciemnej dupie niż był w 2015 roku jak przerżnął wybory i wydawało mu się, że już gorzej być nie może. Taka teza jest powszechna, nie ma innej narracji. Oczywiście nie wywołuje to refleksji: czy naprawdę jesteśmy tak (intelektualnie) wspaniali jak to sobie wmówiliśmy. Tradycyjnie winni są ONI (tym razem politycy typu Schetyna--tak jakby intelektualnie wspaniali nie mogli sobie wybrać lepszych i byli skazani na nieudaczników).

Jednocześnie pojawiają się głosy przed sesją Sejmu, że PiS samo wywoła kryzys--nie uchwalenie budżetu skutkuje -- zgodnie z konstytucją -- przyśpieszonymi wyborami. W sytuacji kompletnego uwiądu opozycji wynik tych wyborów byłby raczej łatwy do przewidzenia. Nic takiego nie następuje -- na tej samej sesji Sejmu bez zbędnych ceregieli uchwalono budżet na 2018 rok. Żaden z liderów opozycji nie zabrał głosu w sprawie. Jaskrawo to kontrastuje z tzw. puczem organizowanym rok wcześniej.

Ekspert TVN czyli R. Giertych twierdzi Nowacka jest agentem Kaczyńskiego (twitter: podejrzewam, że projekt @barbaraanowacka został zrobiony na zlecenie @pisorgpl).

W kolejnych dniach opozycja demonstruje nadzwyczajną skłonność do autodestrukcji (powód: umysłowa niesprawność?). Przykładowo była premier Kopacz/Nowa przewodnicząca Lubnauer opowiadają w detalach w mediach jak to było (zamiast milczeć i/lub zmienić temat). Lubnauer jest powszechnie wyśmiewana za naiwne tłumaczenia w rodzaju: jesteśmy nową partią i nie mamy jeszcze doświadczenia. Poseł Mężydło (PO): nie ma co myśleć o wygraniu wyborów w 2019. Powszechne są opinie, że partia pn. Nowoczesna jest już trupem.

W tle tych wydarzeń i na dokładkę osobnik, który wydawał się elitom wybitny, kompetentny i świetny pod każdym względem czyli R. Petru obwieszcza z poważną miną inicjatywę ponadpartyjną (cokolwiek to znaczy) pn. planPetru. PlanPetru póki co to jednostronicowa ulotka umieszczona na zarządzanej przez WordPressa stronie pn. planpetru.pl

Przed Sejmem demonstracja rozczarowanych. Nad tłumkiem powiewają czerwone flagi. IMO w PL maszerowanie z czerwoną flagą wydaje się samobójstwem, ale kto bogatemu zabroni? No i wreszcie "elita" nie używa fałszywych tylko przychodzi ze swoimi (flagami).

wtorek, 21 listopada 2017

Instalowanie Debiana Stretch na SheevaPlug


Stretch zainstalowany

Co to jest SheevaPlug? Przodek rapberryPi. Ciągle używam, bo jest niezawodne, a z rapberryPi jest gorzej -- czasami przestaje działać. Rzadko bo rzadko ale się zdarza.)

Ponieważ SheevaPlug (dalej Szewa) jest taka stara to i Debian na niej do nowych nie należy. Sytuacja dojrzała do wymiany. Mam na szczęście rezerwową/testową Szewę, co ułatwia decyzję, bo w razie problemów z aktualizacją nie zostanę z niczym.

Korzystam z tej samej strony co lata temu kiedy zaczynałem z Szewą, tj. Installing Debian on Plug Computers, która opisuje wszystko detalicznie i zawiera wszystko co potrzeba. Procedura jest prosta:

1. Należy uaktualić firmware zwany U-bootem. W tym celu trzeba się połączyć z Szewą kablem miniUSB-USB i uruchomić na PCcie program cu:

cu -s 115200 -l /dev/ttyUSB0

Teraz trzeba włączyć Szewę, a w terminalu PCta należy szybko nacisnąć dowolny klawisz co przerywa normalną sekwencję startu systemu i U-boot przechodzi do trybu interaktywnego zgłaszając się znakiem zachęty. Polecenie:

Marvell>> version

Pokazuje wersję system. Jeżeli w nazwie jest Marvell albo wersja jest stara (przed 2014/10) to należy dokonać aktualizacji. Przed aktualizację należy koniecznie ustalić MAC adres urządzenia Ja miałem przepisany z dokumentacji na obudowie; jak ktoś nie wie jaki ma adres, to może wydać polecenie:

print ethaddr

Teraz pobieramy stosowny firmware i kopiujemy go na (bootowalny) pendrive. Pendrive wsadzamy do Szewy, po czym wydajemy polecenie:

usb start
fatload usb 0:1 0x0800000 u-boot.kwb

Następnie

nand erase 0x0 0x80000
nand write 0x0800000 0x0 0x80000

Restartujemy szewę

reset

Na koniec przywracamy MAC adres

setenv ethaddr 00:50:43:01:c0:ab
saveenv
reset

Uwaga: przy (re)starcie komputer zawiśnie na etapie ładowania systemu, którego jeszcze nie ma...

2. Poniższy opis zakłada instalowanie systemu z karty SDHC (bo tak jest najprościej, skoro system ma potem być z tejże karty uruchamiany). Zatem należy sformatować kartę SDHC jako ext2 (wyłącznie ext2, nie należy używać innych typu ext4, że niby lepsze). Do tego użyłem gparted.

3. Pobieramy instalator składający się z 2 plików (SheevaPlug without eSATA: uImage and uInitrd). Pobrane plik kopiujemy na sformatowaną kartę. Kartę wsadzamy do Szewy, z którą połączymy się kablem miniUSB/USB i programem cu w sposób identyczny jak w przypadku aktualizacji firmware'a), wydajemy polecenie (jeżeli karta jest sformatowana jako vfat to zamiast ext2load ma być fatload):

ext2load mmc 0:1 0x00800000 /uImage
ext2load mmc 0:1 0x01100000 /uInitrd

Uruchamiamy instalator:

setenv bootargs console=ttyS0,115200n8 base-installer/initramfs-tools/driver-policy=most
bootm 0x00800000 0x01100000

Instalacja trochę trwa, ale jest bezproblemowa. Well, był problem bo zapomniałem wpisać następującej sekwencji (When the installation is done, you have to configure u-boot so it will automatically boot Debian. Interrupt the boot process of u-boot and enter the following commands.):

setenv bootargs_console console=ttyS0,115200
setenv bootcmd_mmc 'ext2load mmc 0:1 0x00800000 /uImage; ext2load mmc 0:1 0x01100000 /uInitrd'
setenv bootcmd 'setenv bootargs ${bootargs_console}; run bootcmd_mmc; bootm 0x00800000 0x01100000'
saveenv

Przyznam się bez bicia, że ponieważ pominąłem ten krok i system zawisł beznadziejnie potrzebna była konsultacja aż samego Marina Michlmayra.

Uwaga: 0:1 to nazwa bootowalnej partycji. Może być inna, można to ustalić wpisując (pierwsza wypisana jest bootowalna):

Marvell>> usb dev
Marvell>> usb part 0

Ostatecznie:

run bootcmd

Znowu dałem D... Nie przywracając MAC-adresu, co objawiło się tym że wprawdzie system się bootował ale instalator nie mógł się połączyć z Internetem. Należy czytać dokumentację uważnie i bez pośpiechu cnd.

Z uwagi na to, że projekt Szewa wydaje sie być dead&burried skopiowałem co trzeba lokalnie tutaj, na wypadek gdyby zniknęło w Internecie.