czwartek, 10 września 2020

Ciasto z cukinii

Wariant ciasta z dynią. Wczoraj zrobiłem i wszyscy zachwyceni.

Generalnie to wykonałem przepis ze strony https://beszamel.se.pl/ciasta-z-orzechami/niedzielne-ciasto-z-cukinii,7928/, ale ze zmianami. Oryginał to 3 szklanki startej cukinii + 3 szklanki mąki + 3 jajka + 1 szklanka oleju + 1,5 szklanki cukru + 2 łyżeczki cynamonu + 2 łyżeczki cukru waniliowego + łyżeczka proszku do pieczenia + garść orzeczów włoskich. Wszystko się miesza i piecze w 220C przez 60 min.

Mój zmodyfikowany przepis zachowuje proporcje głównych składników: 2 szklanki cukinii (około 400g) + 2 szklanki mąki i karobu (2 łyżki karobu; reszta mąka). Cukinię ścieram a wodę odlewam więc trzeba znacząco więcej zetrzeć żeby wyszło 2 szklanki, bo cukinia wodnista jest. Dwa jajka skoro po dwie szklanki mąki/cukinii...

Cukru moim zdaniem za dużo jest, podobnie jak oleju. Pół szklanki oleju + trochę więcej niż pół szklanki cukru (ja sypię ksylitol dla zdrowotności). Czubata łyżeczka proszku do pieczenie i taka sama sody. Łyżeczka cynamonu. Orzechy ziemne/włoskie według uznania, czyli garść minimum, ale może być więcej. Dodaję garść rodzynek (ulubionych uzbeckich, takich małych czarno--granatowych.)

Cukinię mieszam z mąką i karobem. Jajka, olej i cukier mieszam intensywnie. Wlewam do cukinii z mąką dodaję proszek, sodę i bakalie. Konsystencja od razu mi wyszła prawidłowa i nie musiałem nic dolewać...

Piekę jak w oryginalnym przepisie 220C przez 60minut.

wtorek, 8 września 2020

Wycieczka na Podlasie


Knyszyn

Pojechaliśmy pod koniec sierpnia na krótką wycieczkę na Podlasie. Wszystkiego 5 dni, a konkretnie 24--28 sierpnia czyli poniedziałek--piątek.

Start w poniedziałek około 9:00 i już około 16:00 byliśmy w Białowieży. Tam zakwaterowanie w pokojach pn [Apartamenty] Pod gruszą (ul. Pałacowa 24)... Nie chciało mi się straszenie, ale się zmusiłem i pojechałem rowerem do Hajnówki i z powrotem. Elka z Jankiem poszli zaś na miasto. Wracając zagiąłem jeszcze za miasto i obejrzałem restaurację pn. Carska, która mieści się w dawnym budynku stacyjnym Białowieża Towarowa, jakieś dwa kilometry za centrum.

Następnego dnia rano przed śniadaniem rowerem do Narewki i z powrotem. Po śniadaniu poszliśmy ścieżką pn. Żebra Żubra. Że ścieżka się zaczyna (lub kończy zależy od miejsca gdzie się zaczęło) w rezerwacie pokazowym żubrów obejrzeliśmy i ten rezerwat (średnio warto, a wstęp płatny). Powrót na parking. Potem zwiedzanie skansenu--ciekawy, tyle że względnie niewielki. Przed obiadem obejrzeliśmy jeszcze cerkiew pw. św Mikołaja. Wstęp płatny, a zwiedzanie z przewodnikiem w grupach co 2 godziny. My weszliśmy o 14:00. Interesujące i warto...

Oglądamy jeszcze restaurację Carska (za miasteczkiem, ja już tam byłem wczoraj więc robię za przewodnika), ale bez zamiaru zjedzenia tam czegokolwiek. Miejsce dla snobów. Rekord to bliny z kawiorem za 270 PLN/porcja. Co ciekawe nie ma w Internetach zdjęć jak te super-bliny wyglądają ani opisu, że ktoś zamówił/zjadł i mu smakowało. Nie ma bo ten kto zamówił, żałuje, że wydał 3 stówy bez sensu? (że lokal też nie zamieszcza w tej sytuacji jakby zrozumiałe) Literalnie znalazłem jedną rekomendację i to dotyczącą tańszej wersji tych blinów czyli z wędzonym łososiem. Z kawiorem to nikt się nie chwali, że kupił i mu smakowało...

Obiad w barze pn. Leśna Dziupla. Kartacze + soljanka. Potem do domu a po południu oglądamy park. Plan na jutro: jedziemy do Białegostoku zwiedzając po drodze Kruszyniany, Krynki i Supraśl. Kupujemy sera carskiego w liczbie siedem sztuk (w tym trzy dla znajomej Elki w Gdańsku).

Rano wstaję i jadę rowerem do Kruszynian (przez Narewkę). Elka z Jankiem też tam jadą, tyle że samochodem. Spotykamy się po 11:00. Idziemy zwiedzać meczet i cmentarz. Kupa luda jest tutaj, parking pełen samochodów. Po zwiedzaniu idziemy na kawę do Tatarskiej Jurty, ale tam generalnie obiadowe menu, a że na obiad za wcześnie nic nie zamawiamy i jedziemy do Krynek.

Krynki dziś to dziura, ale kiedyś to było duże miasteczko w którym mieszkali w większości Żydzi. Podobno 13 tysięcy przed pierwszą wojną, potem już tylko pięć, teraz zaledwie dwa no i nie Żydów. Centrum przemysłu garbarskiego (kiedyś)... Z tych czasów świetności pozostały dwa budynki po synagogach i cmentarz żydowski. Oglądamy synagogę przy Kaukaskiej -- teraz gminny ośrodek kultury. Jest tam nawet coś w rodzaju izby pamięci, ale mocno skromne: kilkanaście zdjęć na ścianie + jakieś świeczniki itp... Za to cmentarz duży -- kilkaset nagrobków.

Następny przystanek Supraśl, do którego docieramy około 14:00. Idziemy do klasztoru a tu przerwa obiadowa. No to my też na obiad. Potem wracamy i zwiedzamy kompleks klasztorny (ciekawe). Główna cerkiew została odbudowana całkiem niedawno bo w czasie wojny została zburzona, i jeszcze nie jest poświęcona. Zresztą w czasie zwiedzania widzimy gościa, który maluje freski na ścianie... Wychodzimy i Elka spotyka koleżankę z pracy, która czeka na wejście z następną grupą. W efekcie i w euforii zapominamy, że mieliśmy jeszcze w planach zwiedzanie muzeum ikon...

Około 17:00 jesteśmy w Białymstoku u koleżeństwa KBS. Idziemy wieczorem na miasto. Jutro będziemy zwiedzać okolicę czyli głównie Tykocin...

W Tykocinie zaczynamy od synagogi potem idziemy na zamek. Zamek wygląda całkiem, całkiem, ale się okazuje, że to nie jest oryginał--odbudowany. W środku nie ma rewelacji ale p. przewodniczka opowiada historię miejsca naprawdę ciekawie i zajmująco, więc warto kupić bilet. Potem obiad w restauracji przy moście nad Narwią. Po obiedzie, że jeszcze wcześnie i głupio wracać do Białegostoku, jedziemy do Knyszyna.

Dojeżdżamy, ale co my teraz mamy zwiedzać? Miał być zamek tyle że go nie ma... Był ale już nie ma. Koleżeństwo z Elką poszło studiować wielki plan miasta w rynku w poszukiwaniu atrakcji, a ja wbijam do smartfona: cmentarz+żydowski. Jest... To jedziemy...

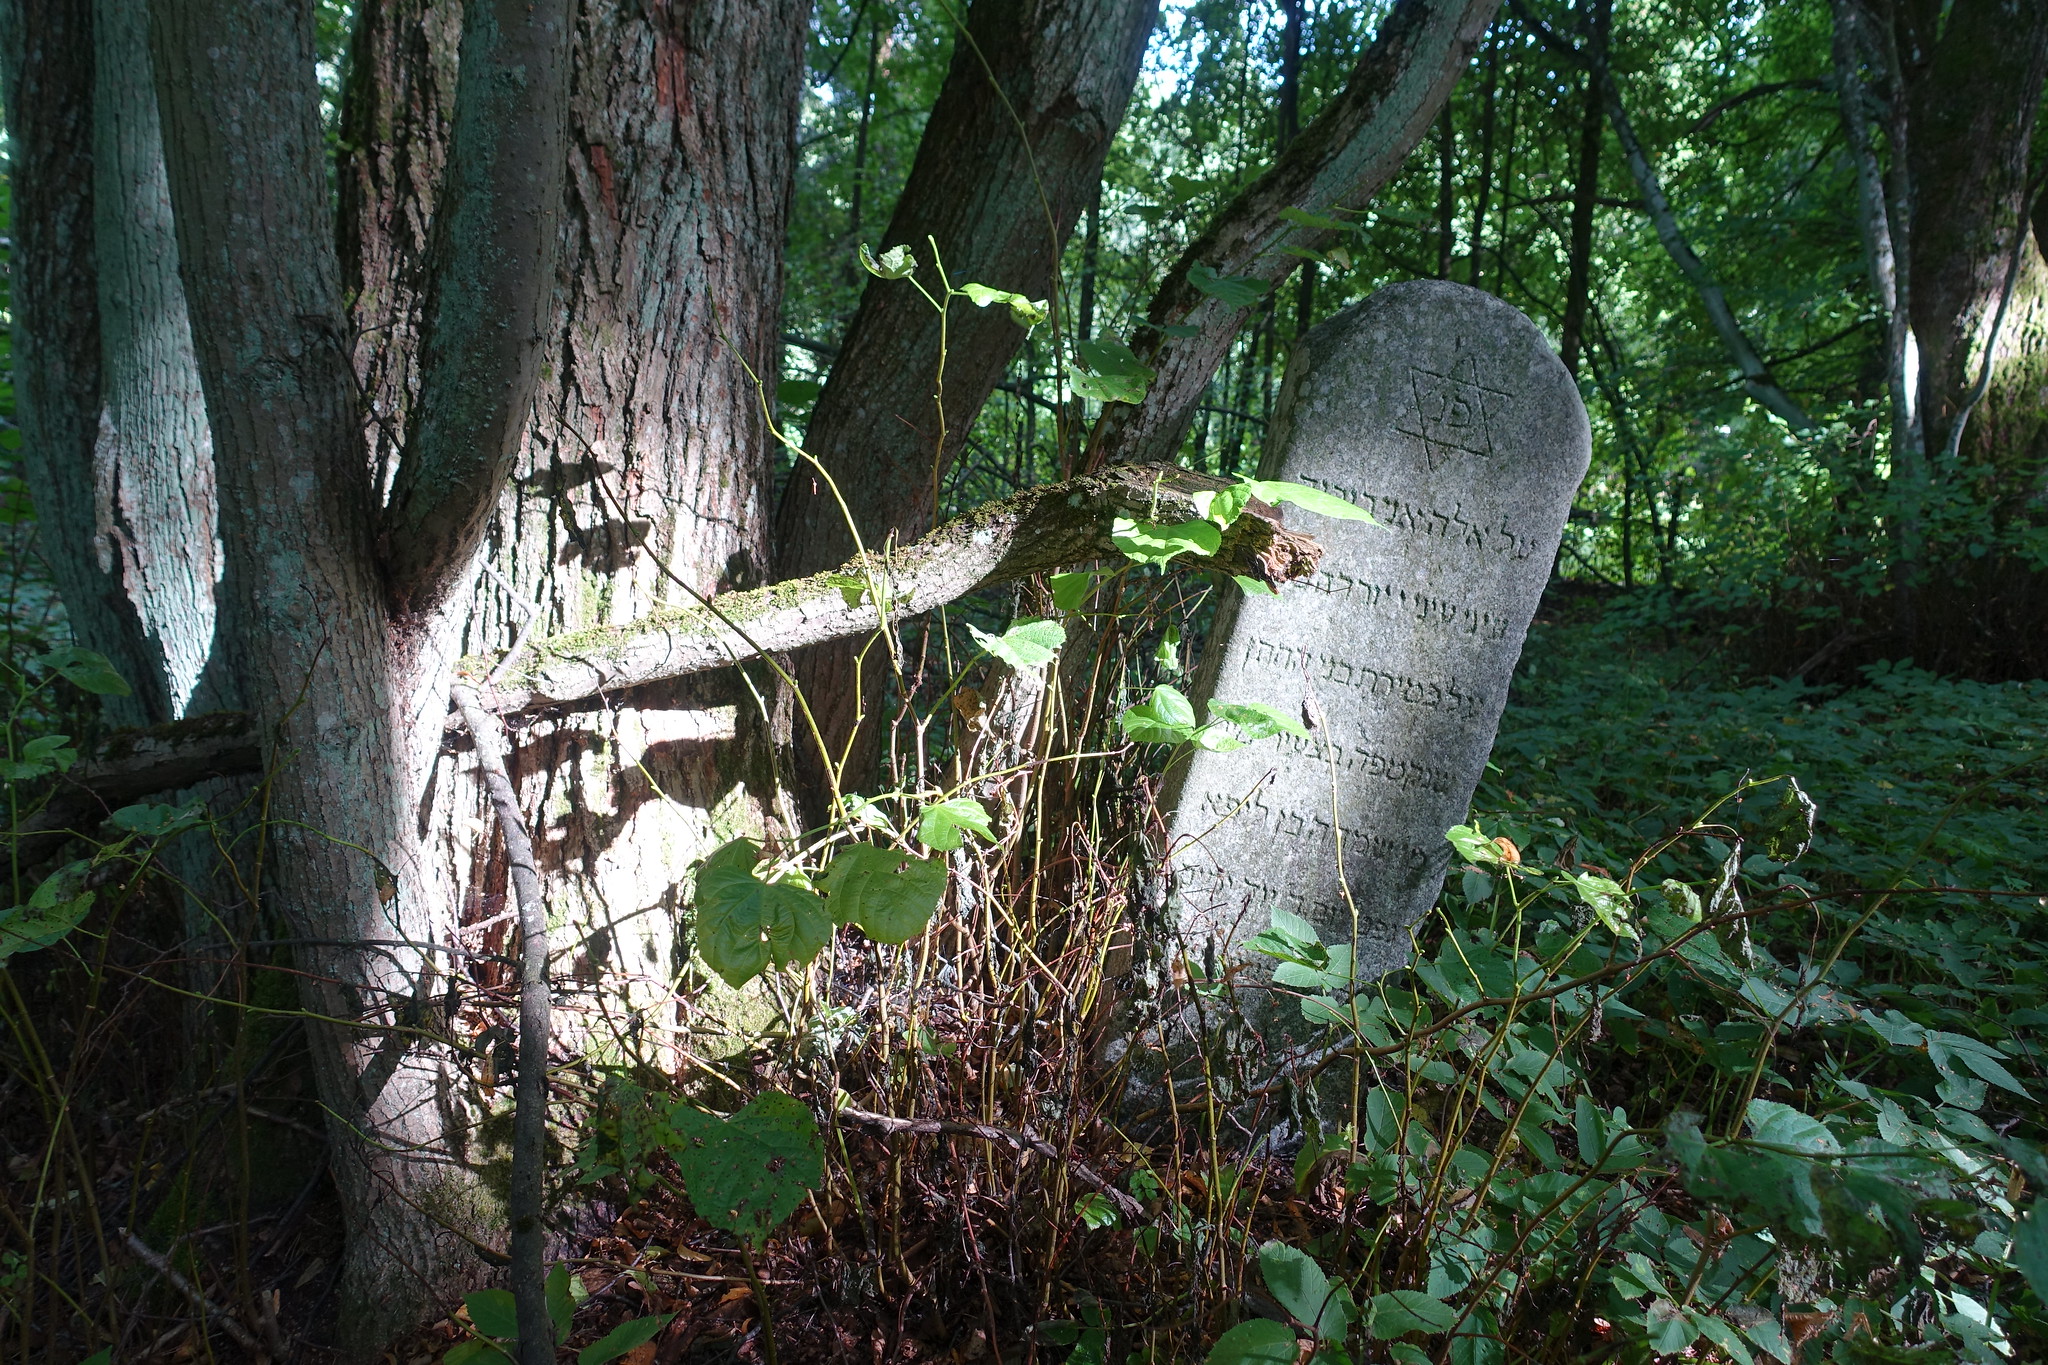
No i warto było. Podobno największy na Podlasiu. Zwiedzamy zatem dokładnie...

Piątek. Wracamy do domu, ale przed powrotem jedziemy do Supraśla raz jeszcze zwiedzić muzeum ikon. Bardzo ciekawe miejsce...

W domu jesteśmy około 19:00

Do pobrania/oglądania ślady kml ze zdjęciami; album ze zdjęciami.

środa, 2 września 2020

Wydłubywanie danych nt/ COVID19 z tweetów MZ

MZ to Ministerstwo Zdrowia. Specyfiką PL jest brak danych publicznych nt. Pandemii.. Na stronie GIS nie ma nic, a stacje wojewódzkie publikują jak chcą i co chcą. Ministerstwo zdrowia z kolei na swojej stronie podaje tylko dane na bieżący dzień, zaś na amerykańskim Twitterze publikuje komunikaty na temat. To co jest na stronie znika oczywiście następnego dnia zastępowane przez inne cyferki. Do tego są tam tylko dzienne dane zbiorcze o liczbie zarażonych i zmarłych, (w podziale na województwa). Nie ma na przykład wieku, płci itp... To co jest na Twitterze z kolei ma formę tekstowego komunikatu postaci: Mamy 502 nowe i potwierdzone przypadki zakażenia #koronawirus z województw: małopolskiego (79), śląskiego (77), mazowieckiego (75)... [...] Z przykrością informujemy o śmierci 6 osób zakażonych koronawirusem (wiek-płeć, miejsce zgonu): 73-K Kędzierzyn-Koźle, 75-M Łańcut, 92-K Lipie, 72-M, 87-M, 85-K Gdańsk.

Czyli podają zarażonych ogółem i w podziale na województwa oraz dane indywidualne zmarłych w postaci płci i wieku oraz miejsca zgonu (miasta żeby było inaczej niż w przypadku podawania zakażeń.)

No więc chcę wydłubać dane postaci 92-K z tweetów publikowanych przez Ministerstwo Zdrowia. W tym celu za pomocą tweepy pobieram cały streamline (+3200 tweetów zaczynających się jeszcze w 2019 roku), ale dalej to już działam w Perlu, bo w Pythonie jakby mniej komfortowo się czuję. Po pierwsze zamieniam format json na csv:

use JSON;
use Data::Dumper;
use Time::Piece;
use open ":encoding(utf8)";
use open IN => ":encoding(utf8)", OUT => ":utf8";
binmode(STDOUT, ":utf8");

##  ID = tweeta ID; date = data; 
##  repid -- odpowiedź na tweeta o numerze ID
##  text -- tekst tweeta
print "id;date;repid;text\n";

while (<>) {
  chomp();
  $tweet =  $_;

  my $json = decode_json( $tweet );
  #print Dumper($json);
  $tid = $json->{"id"};
  $dat = $json->{"created_at"};
  ## Data jest w formacie rozwlekłym zamieniamy na YYYY-MM-DDTHH:MM:SS
  ## Fri Oct 04 14:48:25 +0000 2019
  $dat = Time::Piece->strptime($dat,
     "%a %b %d %H:%M:%S %z %Y")->strftime("%Y-%m-%dT%H:%M:%S");
  $rep = $json->{"in_reply_to_status_id"};
  $ttx = $json->{"full_text"}; $ttx =~ s/\n/ /g;
  ## Zamieniamy ; na , w tekście żeby użyć ; jako separatora
  $ttx =~ s/;/,/g; ####

  print "$tid;$dat;$rep;$ttx\n";

Komunikaty dłuższe niż limit Twittera są dzielone na kawałki, z których każdy jest odpowiedzią na poprzedni, np:

1298900644267544576;2020-08-27T08:30:20;1298900642522685440;53-M, 78-K i 84-K Kraków. Większość osób ...
1298900642522685440;2020-08-27T08:30:20;1298900640714948608;67-K Lublin (mieszkanka woj. podkarpackiego), 85-K Łańcut,...
1298900640714948608;2020-08-27T08:30:19;1298900639586680833;kujawsko-pomorskiego (24), świętokrzyskiego (18), opolskiego...
1298900639586680833;2020-08-27T08:30:19;;Mamy 887 nowych i potwierdzonych przypadków zakażenia #koronawirus z województw: ...

Czyli tweet 1298900639586680833 zaczyna, 1298900640714948608 jest odpowiedzią na 1298900639586680833, a 1298900642522685440 odpowiedzią na 1298900640714948608 itd. Tak to sobie wymyślili... W sumie chyba niepotrzebnie, ale w pierwszym kroku agreguję podzielone komunikaty w ten sposób, że wszystkie odpowiedzi są dołączane do pierwszego tweeta (tego z pustym polem in_reply_to_status_id):

## nextRef jest rekurencyjna zwraca numer-tweeta,
## który jest początkiem wątku
sub nextRef {
  my $i = shift;

  if ( $RR{"$i"} > 0 ) {  
    return ( nextRef( "$RR{$i}" ) );
  } else { return "$i" }
}

### ### ###
while (<>) { chomp();
   ($id, $d, $r, $t) = split /;/, $_;

   $TT{$id} = $t;
   $RR{$id} = $r;
   $DD{$id} = $d;
}

### ### ###
for $id ( sort keys %TT ) {  
   $lastId = nextRef("$id");
   $LL{"$id"} = $lastId;
   $LLIds{"$lastId"} = "$lastId"; 
}

### ### ###
for $id (sort keys %TT) {  
    ## print "### $DD{$id};$id;$LL{$id};$TT{$id}\n";  }
    $TTX{$LL{"$id"}} .= " " . $TT{"$id"};
    $DDX{$LL{"$id"}} .= ";" . $DD{"$id"};
}
### ### ###

for $i (sort keys %TTX) { 

    $dates = $DDX{"$i"};
    $dates =~ s/^;//; ## pierwszy ; jest nadmiarowy
    @tmpDat = split /;/, $dates;

    $dat_time_ = $tmpDat[0]; 
    ($dat_, $time_) = split /T/, $dat_time_;
    $ffN = $#tmpDat + 1;
    $collapsedTweet = $TTX{$i};
    print "$i;$dat_;$time_;$ffN;$collapsedTweet\n";
}

Zapuszczenie powyższego powoduje konsolidację wątków, tj. np. powyższe 4 tweety z 2020-08-27 połączyły się w jeden:

1298900639586680833;2020-08-27;08:30:19;4; Mamy 887 nowych i potwierdzonych przypadków
zakażenia #koronawirus z województw: małopolskiego (233), śląskiego (118), mazowieckiego (107),
[...] Liczba zakażonych koronawirusem: 64 689 /2 010 (wszystkie pozytywne przypadki/w tym osoby zmarłe).

Teraz wydłubujemy tylko tweety z frazą nowych i potwierdzonych albo nowe i potwierdzone:

## nowych i potwierdzonych albo nowe i potwierdzone
## (MZ_09.csv to CSV ze `skonsolidowanymi' wątkami)
cat MZ_09.csv | grep 'nowych i pot\|nowe i pot' > MZ_09_C19.csv
wc -l MZ_09_C19.csv
189 MZ_09_C19.csv

Wydłubanie fraz wiek-płeć ze skonsolidowanych wątków jest teraz proste:

  perl -e '
while (<>) {
 ($i, $d, $t, $c, $t) =  split /;/, $_;

  while ($t =~ m/([0-9]+-[MK])/g ) {
   ($w, $p) = split /\-/, $1;
   print "$d;$w;$p\n";
  }
}' MZ_09_C19.csv > C19D.csv
wc -l C19PL_down.csv
1738

Plik wykazał 1738 osób. Pierwsza komunikat jest z 16 kwietnia. Ostatni z 31. sierpnia. Pierwsze zarejestrowane zgony w PL odnotowano 12 marca (albo 13 nieważne). W okresie 12 marca --15 kwietnia zmarło 286 osób. Dodając 286 do 1738 wychodzi 2024. Wg MZ w okresie 12.03--31.08 zmarło 2039. Czyli manko wielkości 15 zgonów (około 0,5%). No trudno, nie chce mi się dociekać kto i kiedy pogubił tych 15...

Równie prostym skryptem zamieniam dane indywidualne na tygodniowe

#!/usr/bin/perl -w
use Date::Calc qw(Week_Number);

while (<>) {
  chomp();
  ##if ($_ =~ /age/) { next }  ##

  my ($d, $w, $p ) = split /;/, $_;
  my ($y_, $m_, $d_) = split /\-/, $d;
  my $week = Week_Number($y_, $m_, $d_);

  $DW{$week} += $w;
  $DN{$week}++;

  $DD{$d} = $week;
  $YY{$week} = 0;
  $YY_last_day{$week} = $d;

  ## wiek wg płci
  $PW{$p} += $w;
  $PN{$p}++;
}

for $d (keys %DD) {
    $YY{"$DD{$d}"}++; ## ile dni w tygodniu   
 }

print STDERR "Wg płci/wieku (ogółem)\n";

for $p (keys %PW) {
  $s = $PW{$p}/$PN{$p};
  printf STDERR "%s %.2f %i\n", $p, $s, $PN{$p};
  $total += $PN{$p};
}

print STDERR "Razem: $total\n";
print "week;deaths;age;days;date\n";

for $d (sort keys %DW) {
  if ($YY{$d} > 2 ) {## co najmniej 3 dni 
    $s = $DW{$d}/$DN{$d};
    printf "%s;%i;%.2f;%i;%s\n", $d, $DN{$d}, $s, $YY{$d}, $YY_last_day{$d};
  }
}

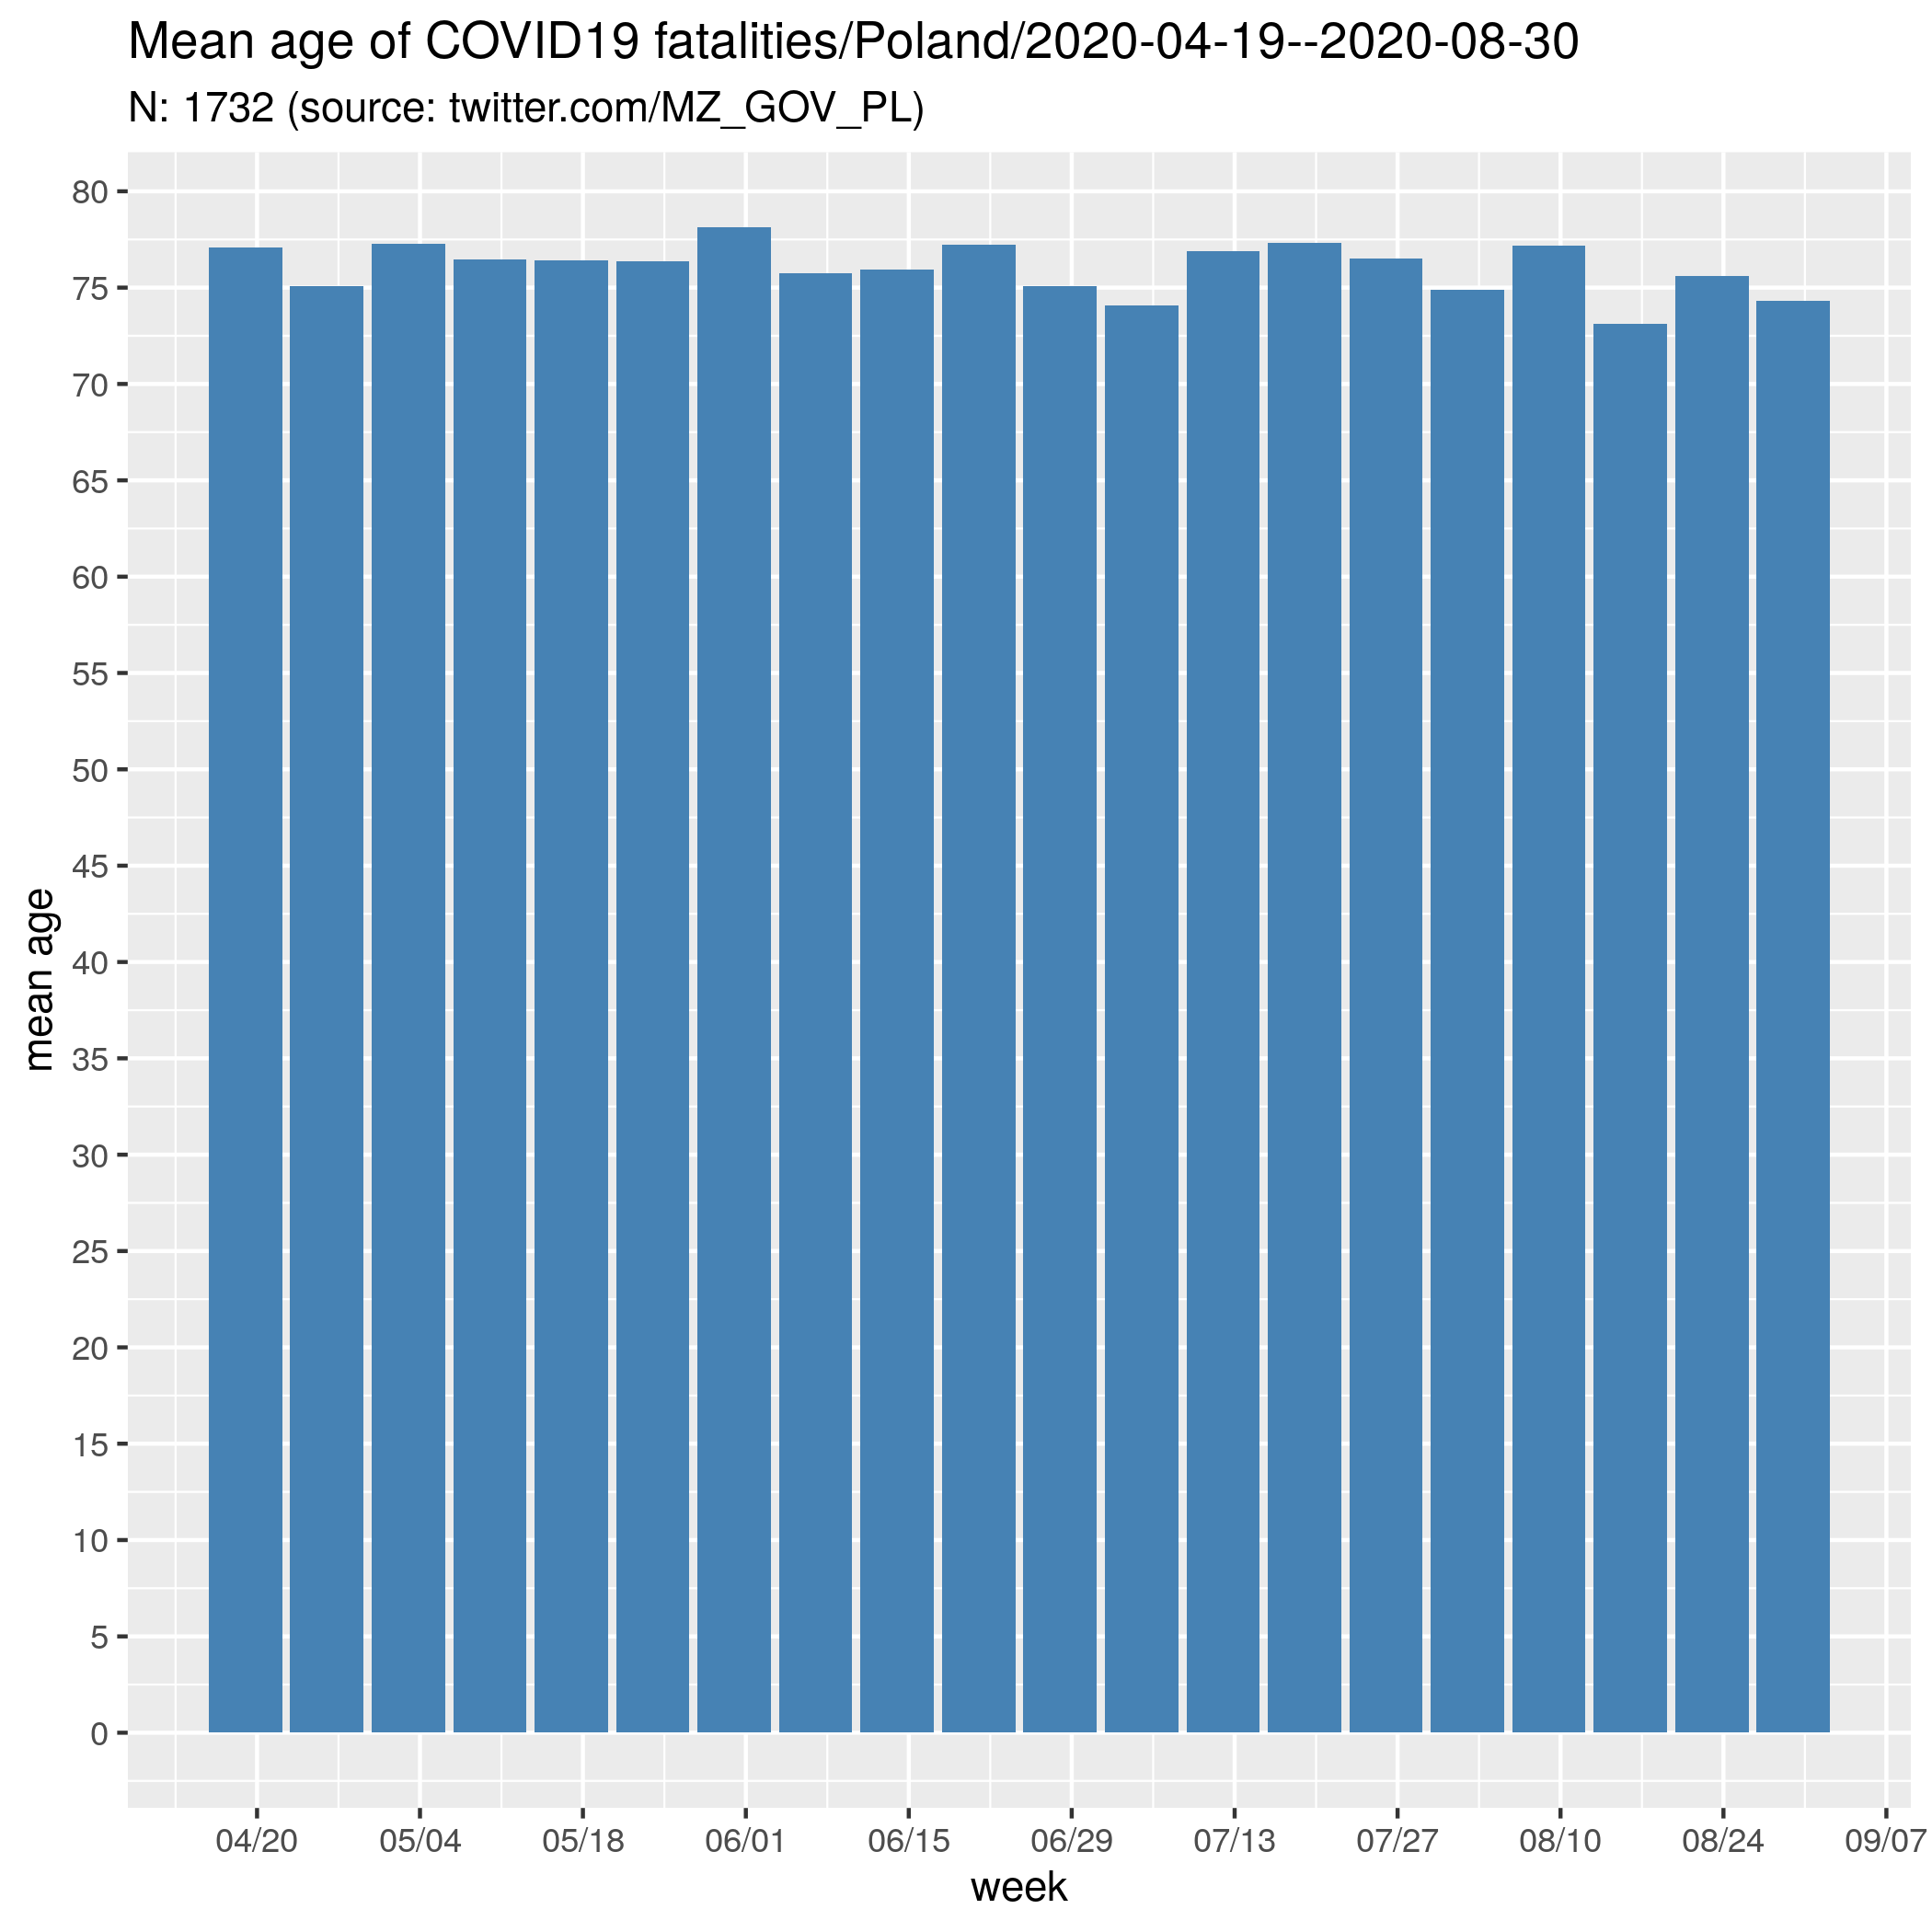
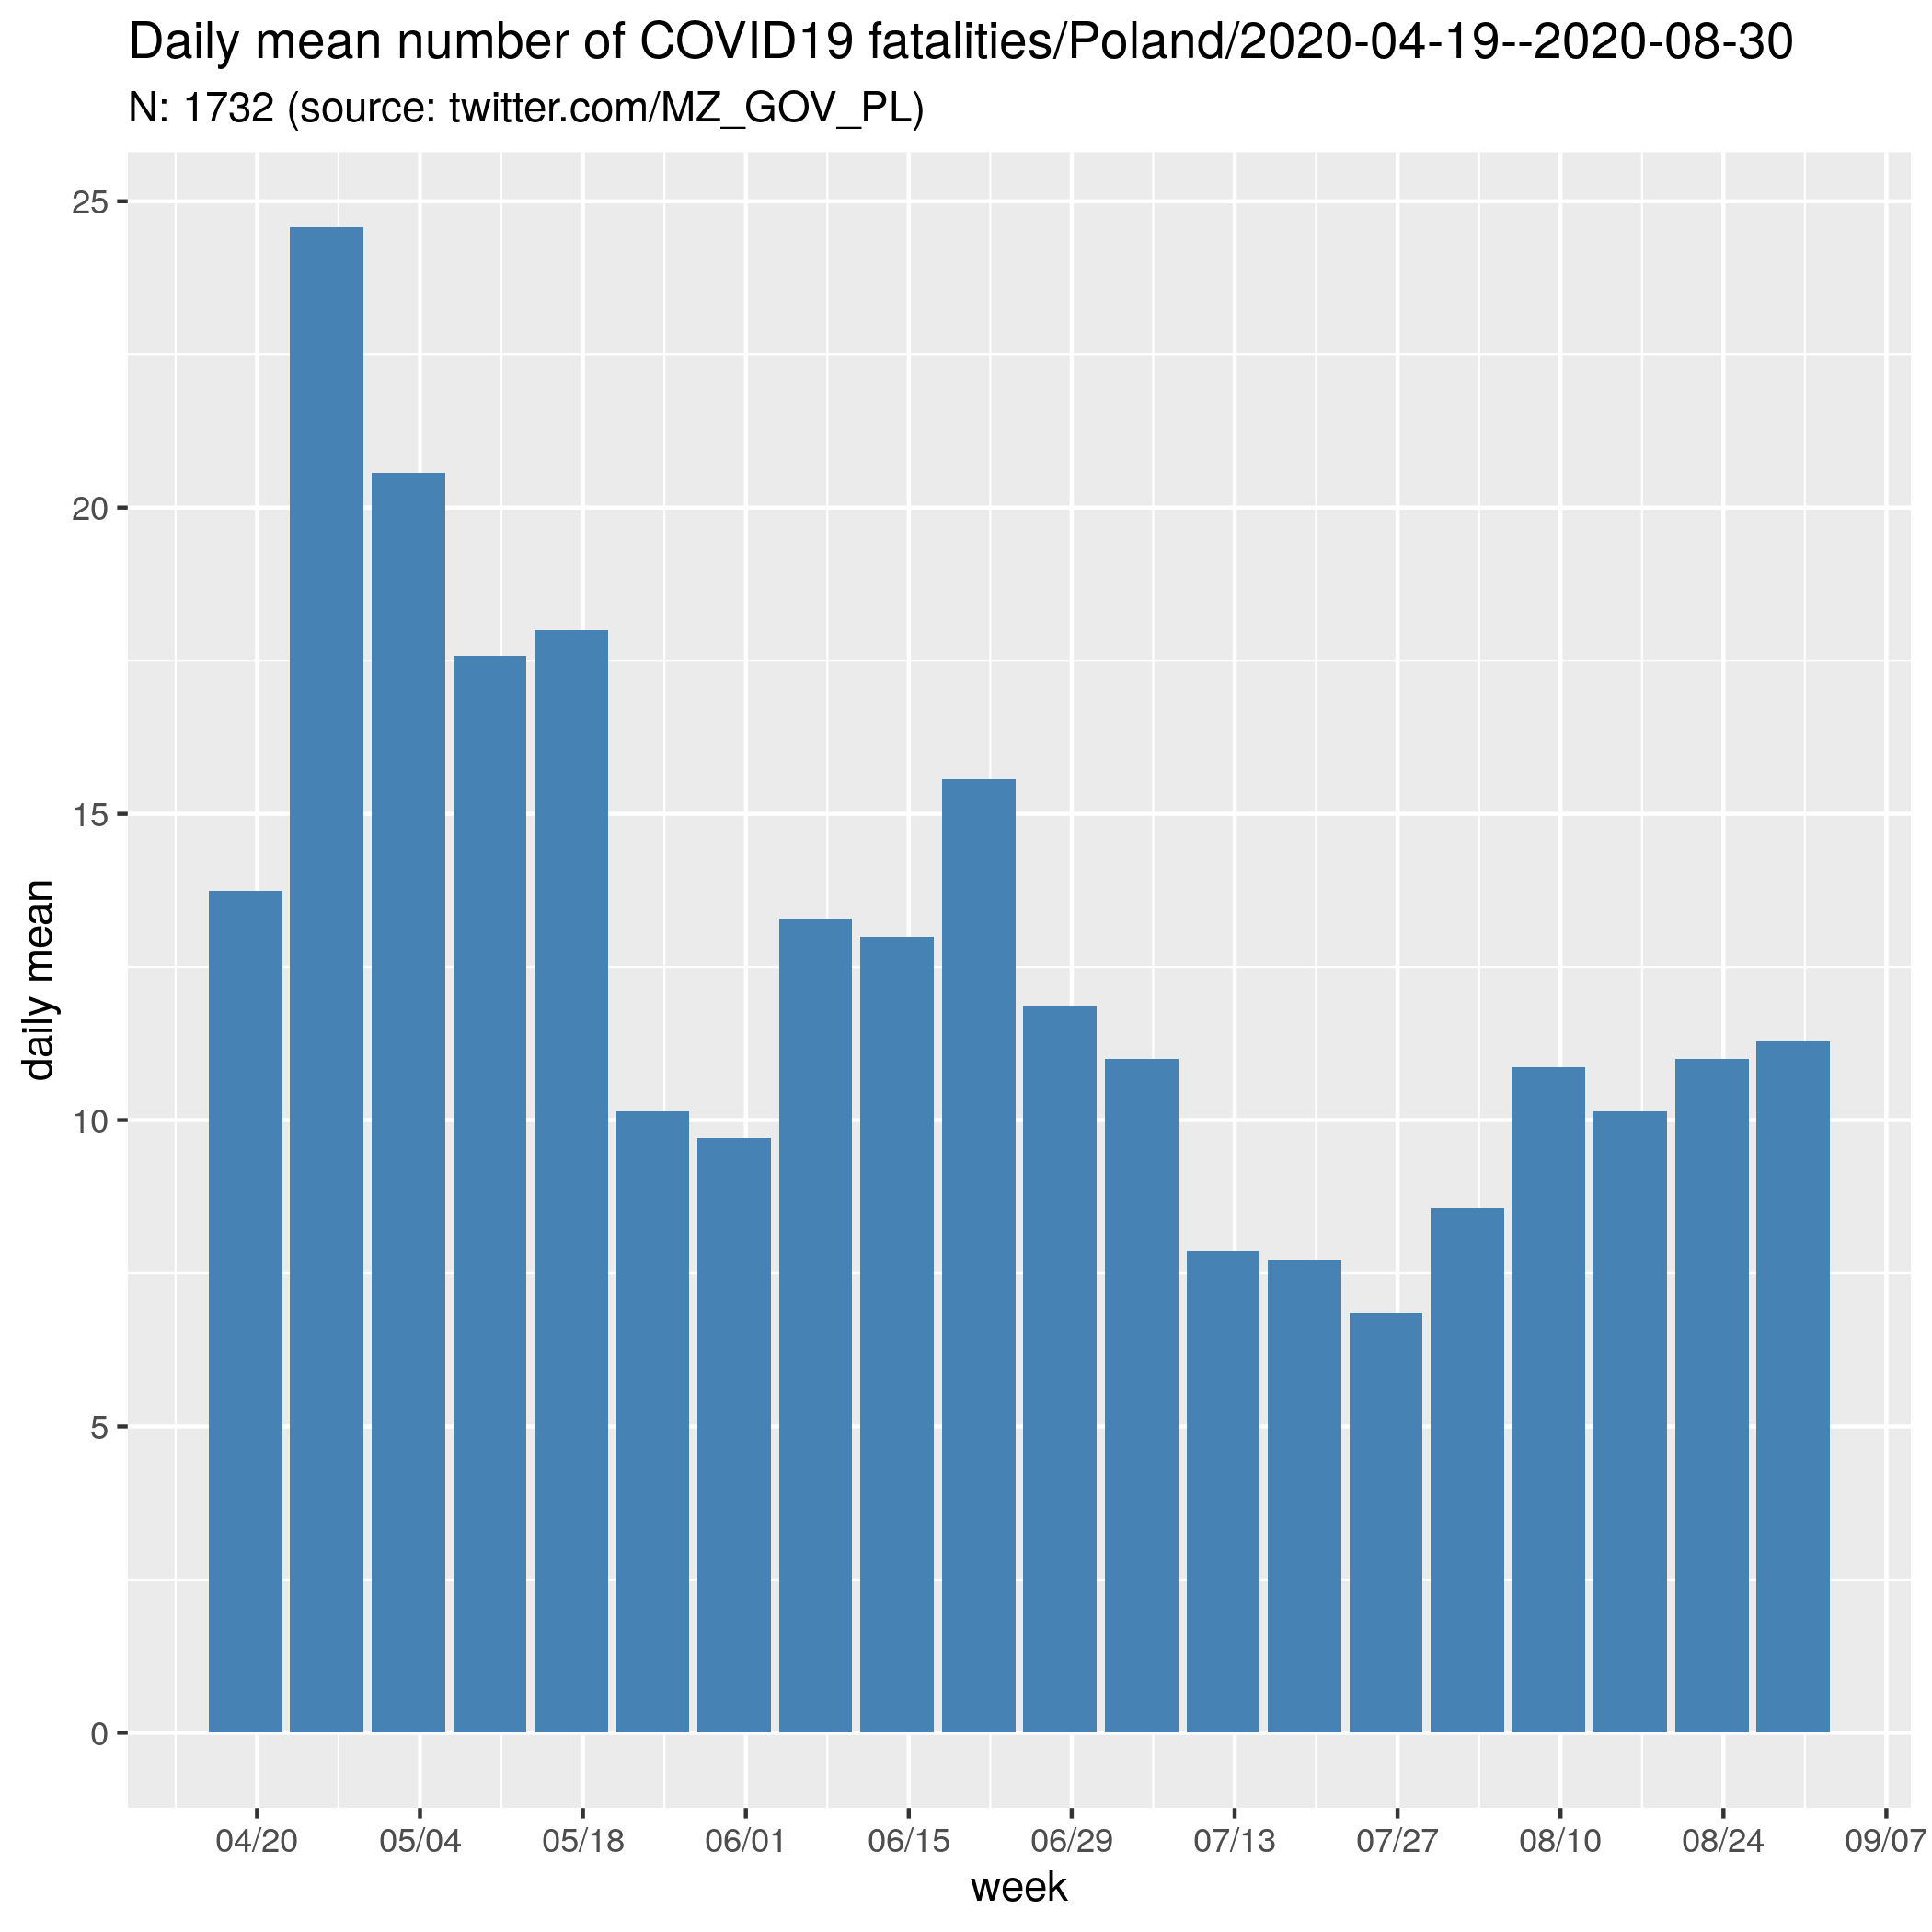
Co daje ostatecznie (week -- numer tygodnia w roku; meanage -- średni wiek zmarłych; deaths -- liczba zmarłych w tygodniu; days -- dni w tygodniu; date -- ostatni dzień tygodnia):

week;deaths;meanage;days;date
16;55;77.07;4;2020-04-19
17;172;75.09;7;2020-04-26
18;144;77.29;7;2020-05-03
19;123;76.46;7;2020-05-10
20;126;76.40;7;2020-05-17
21;71;76.37;7;2020-05-24
22;68;78.12;7;2020-05-31
23;93;75.73;7;2020-06-07
24;91;75.93;7;2020-06-14
25;109;77.24;7;2020-06-21
26;83;75.06;7;2020-06-28
27;77;74.09;7;2020-07-05
28;55;76.91;7;2020-07-12
29;54;77.33;7;2020-07-19
30;48;76.52;7;2020-07-26
31;60;74.88;7;2020-08-02
32;76;77.17;7;2020-08-09
33;71;73.11;7;2020-08-16
34;77;75.61;7;2020-08-23
35;79;74.33;7;2020-08-30

To już można na wykresie przedstawić:-)

library("dplyr")
library("ggplot2")
library("scales")
##
spanV <- 0.25
d <- read.csv("C19D_weekly.csv", sep = ';',  header=T, na.string="NA")

first <- first(d$date)
last <- last(d$date)
period <- sprintf ("%s--%s", first, last)
d$deaths.dailymean <- d$deaths/d$days

cases <- sum(d$deaths);
max.cases <- max(d$deaths)

note <- sprintf ("N: %i (source: twitter.com/MZ_GOV_PL)", cases)

pf <- ggplot(d, aes(x= as.Date(date), y=meanage)) +
 geom_bar(position="dodge", stat="identity", fill="steelblue") +
 scale_x_date( labels = date_format("%m/%d"), breaks = "2 weeks") +
 scale_y_continuous(breaks=c(0,5,10,15,20,25,30,35,40,45,50,55,60,65,70,75,80)) +
 xlab(label="week") +
 ylab(label="mean age") +
 ggtitle(sprintf ("Mean age of COVID19 fatalities/Poland/%s", period), subtitle=note ) 

note <- sprintf ("N: %i (source: twitter.com/MZ_GOV_PL)", cases)
pg <- ggplot(d, aes(x= as.Date(date), y=deaths.dailymean)) +
 geom_bar(position="dodge", stat="identity", fill="steelblue") +
 scale_x_date( labels = date_format("%m/%d"), breaks = "2 weeks") +
 scale_y_continuous(breaks=c(0,5,10,15,20,25,30,35,40,45,50)) +
 xlab(label="week") +
 ylab(label="daily mean") +
 ggtitle(sprintf("Daily mean number of COVID19 fatalities/Poland/%s", period), subtitle=note )

ggsave(plot=pf, file="c19dMA_w.png")
ggsave(plot=pg, file="c19dN_w.png")

Wynik tutaj:

Średnia Wg płci/wieku/ogółem. Ogółem -- 75,9 lat (1738 zgonów) w tym: mężczyźni (914 zgonów) -- 73.9 lat oraz kobiety (824) -- 78.4 lat. Stan pandemii na 31.08 przypominam. Apogeum 2 fali... Średnia wieku w PL (2019 rok) 74,1 lat (M) oraz 81,8 lat (K).

wtorek, 11 sierpnia 2020

Wolność słowa i casus Radia Nowy Świat

Cała sprawa miała swój początek w trakcie jednego z serwisów informacyjnych Radia Nowy Świat (RNS). Podający się za kobietę Michał Sz., ps. "Margot", został określony jako mężczyzna. Stacja została za to ostro skrytykowana.

W obronie [..] stanął prezes spółki zarządzającej Radiem Nowy Świat Piotr Jedliński: Jeżeli Margot oraz akolici tak bardzo apelują o poszanowanie wolności, to dlaczego nie szanują wolności mediów oraz mojej, jako osoby? Dlaczego chcą mi na siłę narzucić sposób postrzegania świata, zmuszając, żebym określał kogoś, kogo odbieram jako mężczyznę, zaimkami żeńskimi?

To nic nie zmieniło a nawet od wypowiedzi prezesa odcięła się reszta: Zastosowana przez nas forma męskoosobowa ("aktywista") w odniesieniu do Margot była nieintencjonalnym błędem, który w żadnej mierze nie definiuje stanowiska Radia Nowy Świat wobec wspomnianych osób i wydarzeń. Nasz zespół składa się z osób zróżnicowanych pod względem wieku, przekonań, koloru skóry oraz orientacji seksualnej i jesteśmy świadomi, że to właśnie różnorodność stanowi siłę Radia Nowy Świat. W tym kontekście pragniemy podkreślić, że wpis Piotra Jedlińskiego jest jego prywatną opinią.

Jedliński próbował wyjaśniać składając samokrytykę i używając `właściwej' formy: Szanowni Państwo, Odpowiadając na zarzuty wywołane formą gramatyczną, w jakiej w serwisach RNŚ mówiono o Margot, miałem na celu obronę niezależności naszego radia także przed naciskami opinii publicznej. Jednak dalsze działania władzy wobec Margot, zwłaszcza osadzenie jej w areszcie dla mężczyzn, ze skandalicznym komentarzem jednego z polityków, istotnie zmieniło w moich oczach kontekst całej sprawy. Nie zamierzałem i nie zamierzam bronić prześladowania mniejszości przez władze. Nie zamierzałem dołączać do prześladujących. Nie wycofując się z wiary w wartość bycia niezależnym, w dzisiejszym konflikcie między prześladującymi i prześladowanymi jestem po stronie prześladowanych.

Mimo to było już za późno na `samokrytykę'. W poniedziałek po godz. 22 Radio Nowy Świat poinformowało w mediach społecznościowych, że Jedliński zrezygnował z funkcji prezesa.

Czyli klasyka, jak za Stalina. Najpierw samokrytyka a potem w piach. Oczywiście za Stalina fizycznie, teraz tylko gość traci pracę. Czasy się zmieniły nie ma potrzeby na bardziej radykalne środki.

Dla przypomnienia RNS powstało, bo dziennikarze uważali że usunięcie piosenki Kazika `Twój ból jest lepszy niż mój' to cenzura, ograniczanie wolności słowa itp. Odeszli z gnębionej przez PiS Trójki i założyli radio `niezależne'.

Teraz uważają że wszystko jest w porządku...

W tzw. międzyczasie Szutowicz (czyli ten Sz.) awansował na `osobę niebinarną': Michał Sz. to osoba niebinarna identyfikująca się jako kobieta i posługująca pseudonimem Margot. W dokumentach ma nadal wpisaną płeć męską. (NB osoba-niebinarna https://en.wikipedia.org/wiki/Non-binary_gender#History wydaje się być kreacją takich właśnie Szutowiczów, bo próżno na stronie Wiki odszukać choć jeden poważny tekst nauki na temat (Psychologia to nie nauka albo inaczej zbyt dużo tam jest ideologii i oszustw żeby się bezkrytycznie podpierać każdym tekstem z tej dziedziny).

Pomimo wielkiej kariery medialnej Szutowiczem słabo interesują się media: `aktywista LGBT' oczywiście, `osoba niebinarna', 24-lata to już trzeba sporo się natrudzić żeby odszukać. Studiował nie-wiadomo-co na UW (nie dziwi). Związany z osobą określającą się jako lesbijka. Tyle ma wystarczyć.

To słabe zainteresowanie zwłaszcza brukowców czy TV no dziwi. Normalnie takie dziwo jest prześwietlane od urodzenia albo i wcześniej. Są wywiady z byłymi sympatiami, opisy z dzieciństwa, itd. Zdolny wrażliwy, wiersze pisał itd/itp. Albo zepsuty do cna od zawsze. To się przecież sprzedaje...

A tu nic.

I jeszcze p. niedoRzecznik Bodnar na koniec kariery postanowił się ośmieszyć ostatecznie nie tylko określając nie wiedzieć czemu Szutowicza jako kobietę (o zmianie płci w PL decyduje sąd), ale jeszcze pisząc jakieś nonsensowne raporty z wizytacji w pierdlu `u Margot', w którym to pierdlu zapewne jest znany jako Szutowicz, a o jakiejś Margot nikt nie słyszał -- więc po co ta komedia?

Wreszcie: cała afera powstała bo ww. Szutowicz został osadzony na 2 miesiące za czyny chuligańskie co do czego nikt poza ostatnimi kretynami nie ma wątpliwości. Więc broni się Szutowicza inaczej: że zatrzymanie było nie-ten-teges (brutalne), że 2 miesiące sankcji to za dużo (ale 3 lata dla Macieja Dobrowolskiego za nic dla tych samych ludzi to OK oczywiście wtedy -- za Tuska -- było), że siedzi w męskim pierdlu (ale ciekawe nikt z zatroskanych tj. GW/TVN, itd się nie pyta czy `panie osadzone' na oddziałach żeńskich chciałby siedzieć z `niebinarnym' facetem? Albo do jakiej publicznej toalety chodził do tej pory Szutowicz, który wizualnie wygląda jak facet dodam). Kretyni `nieostatni' wymyślają teorie, że kryminalna działalność Szutowicza jest politycznie motywowana i jako taka usprawiedliwiona: Margot jest wandalką [słowo oznaczone jako błędne w słowniku aspell BTW i słusznie, bo Wandale to byli faceci, ale politniepoprawne :-)] w podobny sposób, jak wandalami byli powstańcy malujący Kotwicę na murach. (przy okazji: od malowania to był mały sabotaż za tzw. okupacji a powstanie to polegało na strzelaniu raczej, ale wymagać od ąę-kretyna z wielkiego miasta żeby to wiedział, to za dużo przecież)...

Że współczesny świat (zachodu) zmierza do chaosu o czym świadczą (porządek dowolny): dezinformujące globalne media (stare upadające + nowe elektroniczne); zdegenerowana nauka (zdominowana przez ideologię oraz pieniądze/korporacje). dziwna ekonomia (na przykład ujemne stopy procentowe), pseudo-pandemia (globalny i rujnujący lockdown), wojna/rewolucja kulturowa (w tym potępienie w czambuł białego człowieka), wojna o świeże powietrze (św. Greta z Thundberg, z którą mają obowiązek konsultować się przywódcy państw), to teksty na tematy polityczne będę oznaczać jako chaos.

niedziela, 9 sierpnia 2020

Mierzenie wilgotności gleby

Kupiłem GW1000 firmy Ecowitt celem monitorowania wilgotności gleby + trzy stosowne czujniki o symbolu WH51 (w amazon.com). Nie doczytałem wszakże, że to działa z amerykańską częstotliwością 915Mhz więc wprawdzie działa, ale jest niekompatybilne z klonem od Froggita (DP1500)

Żeby pobierać dane lokalnie trzeba zainstalować weeWX:

# install weeWX
wget -qO - http://weewx.com/keys.html | sudo apt-key add -
wget -qO - http://weewx.com/apt/weewx.list | \
   sudo tee /etc/apt/sources.list.d/weewx.list
sudo apt-get update
sudo apt-get install weewx

# shut down weeWX
sudo /etc/init.d/weewx stop

# install weewx-interceptor extension and enable the driver
git clone https://github.com/matthewwall/weewx-interceptor.git
sudo wee_extension --install weewx-interceptor
sudo wee_config --reconfigure

Teraz trzeba skonfigurować GW1000 za pomocą apki WS View:

Server: IP address of computer running weeWX+interceptor
Path: /
Port: 8000

W pliku konfiguracyjnym /etc/weewx/weewx.conf należy zmienić sekcję [Interceptor]:

[Interceptor]
   driver = user.interceptor
   device_type = fineoffset-bridge
   port = 8000

W pliku konfiguracyjnym /etc/weewx/weewx.conf należy upewnić się, że station_type = Interceptor.

# run weewx directly to verify the data collection (ctrl-c to stop)
weewxd /etc/weewx/weewx.conf
# run weewx as a daemon and forget about it!
sudo /etc/init.d/weewx start

Dane są zapisywane do bazy znajdującej się w /var/lib/weewx/weewx.sdb:

  sqlite3 /var/lib/weewx/weewx.sdb
  .tables
  ###
  .schema archive
  select dateTime, soilMoist1, soilMoist2, soilMoist3  from archive;

Działa...

niedziela, 2 sierpnia 2020

Projekt zawodzie

Zawodzie to ulica w Gdańsku. W dzielnicy Olszynka.

Olszynka to specyficzna dzielnica. Tereny depresyjne, zabudowa niska. Dużo ogrodów, działek i pól.

Moja teściowa ma tam działkę, którą uprawia od wieków. Uprawia z wielką determinacja dodajmy: autobusem/tramwajem na Olszynkę potem 2 km piechotą. Z powrotem drugie 2 km, w sezonie z siatami zawierającymi zbiory. Ponieważ zdrowie już nie te co kiedyś, wymyśliłem sobie że będę jej pomagał.

W tzw. międzyczasie zdrowie teściowej jeszcze bardziej podupadło a ja z kolei nie miałem co robić bo pandemia. Zaangażowałem się na całego.

Działka ma około 380m2 i jest w kształcie prostokąta około 40m x 10m.

Z przodu domek, potem grządka truskawek, reszta trawa w zasadzie.

Po pierwsze dużo pracy pochłonęło odtrawienie/odchwaszczenie działki. Kupiliśmy szklarnię (12m2) w celu hodowania pomidorów. Obok szklarni umyśliłem założyć dużą grzędę na dynie i cukinie. Teren obok domku wyrównałem, położyłem kratki żeby Elka miała parking. Kupiłem stół piknikowy. Osłoniłem częściowo działkę płotem (ażurowym) od ulicy (wewnętrznej). Założyłem rynny na domku i kupiłem zbiornik na deszczówkę (na dniach go zamontuję)

W szklarni zasadziłem 16 pomidorów, 6 papryk i 4 ogórki. Ogórki są OK, papryki coś tam urodziły. Pomidory tak średnio rokują, liczyłem na więcej. Dynie umyśliłem że będą rosły w pionie (w tym celu zbudowałem wymyślną podporę). 4 rzędy dyń po 4 dynie/cukinie w rzędzie (co 80cm) z odstępem 1m między rzędami. Ekstra odstęp po 2-gim rzędzie. Podpora w środku pomiędzy rzędami 1/2 oraz 3/4. Na brzegach 4 ogórki i trochę fasoli tyczkowej, pomiędzy rzędami 2/3 wsadziłem paprykę (bo jest ekstra odstęp). Na razie wszystko rośnie. A ja jeżdżę i podwiązuję żeby szło w górę a nie po ziemi. Cukinii mamy po pachy. Dyń jeszcze nie ma, ale są już owoce w dużej liczbie więc zbiory zapowiadają więcej niż dobrze.

Nie byłbym sobą gdybym nie kombinował czegoś z elektroniką. Oryginalny pomysł był taki żeby zainstalować kamerę dla teściowej, żeby mogła oglądać jak jej rośnie. Konkretnie wymyśliłem sobie raspberry pi wysyłające zdjęcie raz na 3 godziny. Żeby utrudnić złodziejom robotę kamera+pi są obudowane czymś co imituje budkę dla ptaków i umieszczone jest na dachu domku (3m nad ziemią więc wysokość akurat nie jest zbytnią barierą dla ewentualnego złodzieja). W domku jest router z Allegro (50PLN). W routerze prepaidowa karta SIM z njuMobile. Działa. Do pi dołączony jest czujnik temperatury/wilgotności/ciśnienia BMP280 (Allegro/Alibaba)

Jest też druga kamera w szklarni. Ponieważ szklarnia jest 30m od domku, to drugie pi łączy się z routerem po kablu. Do tego pi też jest dołączony czujnik BMP280.

Z tym drugim pi był problem zasilania. Nie decydowałem się na ciągnięcie kabla 230V a 30m pomiędzy zasilaczem na komputerkiem spowodowało spadek napięcia, poniżej poziomu przy którym pi się uruchamia. Szczęśliwie mam znajomego eksperta od tych spraw, który podpowiedział rozwiązanie w postaci przetwornicy DC-DC 12V/5V Step-Down USB microUSB (konkretnie https://allegro.pl/oferta/przetwornica-dc-dc-12v-5v-step-down-usb-microusb-8491672731)

Ponieważ mamy już sierpień to wygląda, że w tym roku więcej nic nie wymyślę. Na przyszły rok zostawiam wykonanie kompostownika (porządny murowany) oraz systemu do automatyzacji podlewania. To drugie wymaga zmodyfikowania instalacji wodnej, która teraz składa się z jednego kranu obok domku. Jak już pociągnę wodę wdłuż całej działki, to może pociągnę też 230V.

środa, 29 lipca 2020

Po wyborach

Na stronie FB osoby którą znam (z realu zresztą, od wielu/wielu lat, nie z sieci) taki wpis (pod nazwiskiem, ale nie będę się znęcał więc zamazałem) ewidentnie wyborcy z miasta uważającego się za inteligentnego tj. wyborcy R. Trzaskowskiego:

Liczenie na kolejne wybory nic nie da. Te 50% obywateli to wielka niewiadoma i inteligencja /miasto do nich nie dotrze.

Musi być akcja bojkotu i nieposłuszeństwa.

Propagowanie inpeachmentu, sprzeciw, bojkot, zbieranie podpisów, wspieranie protestów kobiet i LGBT+, ruchów na rzecz klimatu i ekologii, propagowanie apostazji z KK, domaganie się zwiększenia integracji z UE i wprowadzenia waluty euro, prawa kobiet do aborcji, prawo do eutanazji, równość wyznań i rozdzielność państwa od kościoła etc.

Ochrona samorządności i propagowanie zwiększenia autonomii samorządów (dochody z podatków zostają na miejscu, tylko część wędruje do budżetu państwa. Idąc dalej federalizacja Polski i Europy. To są tematy na wrzucenie do opinii publicznej i następnie domaganie się realizacji od władzy.

To są dziesiątki spraw, którymi można zarzucić władzę, oczywiste jest, że będzie musiała podejmować tematy, ale z nimi sobie nie poradzi, gdyż jest zbyt głupia.

Czyli reasumując walczymy o demokrację ale że nie ma szans na większość to trzeba ją ustanowić metodami jak wyżej (wrzucenie do opinii publicznej i następnie domaganie się realizacji od władzy :-))

Autorów nie znam (sądząc ze strony FB dwójka jebniętych staruchów, którym się wydaje), ale znam gościa, na którego stronie to się pojawiło. Niby normalny a nawet wielu uważa, że mądry (ja nie), ale odpowiedział ,,ogólnie się w pełni zgadzam''. I tak to jest z tymi wyborcami od Rafała. Im się wydaje, że są tak mądrzy i wybitni, że władza im się należy, a nie tym głupkom co w sposób nieuprawniony ją sprawują...

Tak BTW: ww. ,,manifest'' sugeruje, że wprowadzenie EUR, wydawanie kasy ,,na klimat'', robienie publicznego zamętu wokół LGBT, itd/itp to tylko środki do celu... Brawo za szczerość a postulat w/s eutanazji bym sugerował zacząć od siebie.

BTW2: ludzie się dziwią co motywuje tych pierdolniętych w większości staruszków do robienia z siebie pośmiewiska, w postaci 5 czy 15 osobowych manifestacji. Normalni ludzie pytają się czy nie szkoda czasu na takie bezcelowe błazenady. Oni jak widać oni szczerze wierzą, że ,,zarzucą władzę'' a ona ,,sobie nie poradzi, gdyż jest zbyt głupia.''

sobota, 25 kwietnia 2020

Master-plan Jacka Sasina

Przyznam się że typa nie lubię. Oceniam go jako nietypowego partyjnego aparatczyka: mierny ale wierny, tyle że nie bierny (w tym sensie nietypowy, co w połączeniu z cechą pierwszą powoduje, że nawet gorszy niż ten co niewiele robi). Sasin działa. Jest gwiazdą TV (nie oglądam wywiadów z tą gwiazdą). Jest także autorem dwóch projektów, które zapamiętałem: 1) zmiana granic okręgów wyborczych w wyborach samorządowych celem ułatwienia wyboru kandydata PiS (Ustawa o ustroju miasta stołecznego Warszawy; więcej google: zmiana+granic+okręgów+Sasin) oraz 2) pozbawienie prezydent Łodzi Hanny Zdanowskiej biernego prawa wyborczego (Sasin o Zdanowskiej: Nawet jeśli wygra, nie będzie rządzić; więcej: google: zdanowska+sasin)

Wszystkie te projekty mają jeden wspólny mianownik: 1) dotyczyły wyborów, 2) były na wariata, 3) nie wyszły. OK, wybory 10-05-2020 mogą wyjść, bo się jeszcze nie odbyły. Jest teoretycznie szansa, że panu premierowi odwróci się karta, ale ja powiem już dziś: myślę, że wątpię. Powiem więcej: ten project jest tak na wariata, że cały czas mam przeświadczenie, że to dywersja (zwana także zasłoną dymną). Tj. prawdziwy projekt jeszcze nie został ujawniony.

Przy czym projekt wybory korespondencyjne sam w sobie nie jest zły. Nie jest ani niebezpieczny dla zdrowia (bzdura wymyślona przez opozycję) ani nie jest niekonstytucyjny (kolejna bzdura). W stanie Oregon od 1998 roku wybory są wyłącznie korespondencyjne, tyle że w Oregonie: pakiety są wysyłane trzy tygodnie przed dniem głosowania, a w zasadzie liczenia głosów (co daje możliwość reklamowania się jak się koperty nie dostało), podpisane koperty zwrotne są weryfikowane z podpisem wyborcy z rejestru (coś jak weryfikacja podpisu w banku, co mocno IMO ogranicza możliwość wysyłania głosów za kogoś), komisja potwierdza przyjęcie ważnego głosu (SMSem). Wszystkie wymienione pozwalają moim zdaniem ograniczyć możliwe fałszerstwa i omyłki. Powiem że a la Oregon to ja bym nawet wolał niż łazić do lokalu i głosować osobiście (i pewnie by taniej wyszło). No ale to co wymyślił Sasin to się ma jak pięść do nosa do procedury oregońskiej: jaka jest gwarancja formalna że każdy dostanie kartę do głosowania, jak list ma być dostarczony 3 dni przed i nierejestrowany? Jak wykryć fałszerstwa? Wolne żarty, że się będzie zatrudniać grafologa. Załóżmy, że wpłynie 50 tys skarg na fałszywy podpis pod kartą złożonych nawet złośliwie przez opozycyjnych członków komisji (mają prawo nawet do obstrukcji, podobnie jak PiS co nie miał żadnych podstaw ale składał protesty w ostatnich wyborach samorządowych, bo ,,różnica była mała''). No więc kiedy wtedy SN by uznał ważność wyborów? Za 10 lat? Albo hurtem oddalił wszystkie protesty?

Tak to widzę...

Worldometer vs ECDC

Jak już pisałem danych nt COVID19 jest multum bo są traktowane jako treść promocyjna, przyciągająca klikających. Każda tuba medialna (gazeta/portal/telewizja) w szczególności publikuje dane nt.

Źródłem pierwotnym każdego wydają się być raporty narodowe (bo jak inaczej), ale ponieważ te raporty narodowe są składane w różny sposób, to ich połączenie w jedną bazę też różnie może wyglądać. Generalnie ci co takie bazy robią to albo przyznają się, że działają na hmmm niekonwencjonalnych źródłach (Twitter) albo nic nie piszą, skąd mają dane. Mają i już...

Wydaje się (chyba, że czegoś nie wiem), że ECDC, OWiD, CSSE oraz Worldometers (dalej WMs) są najpopularniejszymi źródłami danych nt COVID19 w przekroju międzynarodowym. (Nawiasem mówiąc: WHO nie publikuje danych -- publikuje raporty z danymi w formacie PDF. Wydobycie z nich danych jest nietrywialne i kosztowne, bo nie da się tego na 100% zautomatyzować. W rezultacie prawie nikt nie powołuje się na WHO jako źródło danych -- lekki szejm przyznajmy, bo niby ta organizacja jest od tego żeby m.in. zbierać i udostępniać informację n/t.) Taka drobna różnica na początek: ECDC, OWiD oraz CSSE to prawdziwe bazy: zarejestrowane z dzienną częstotliwością zgony, przypadki, testy i co tam jeszcze. OWiD kopiuje dane z ECDC, kiedyś kopiowało z WHO ale napisali że WHO zawierało liczne błędy i to ich skłoniło do korzystania z ECDC (0:2 dla WHO). WMs publikuje stan na, bazy jako takiej nie ma (przynajmniej publicznie albo nie potrafię jej odszukać na stronie). Można założyć że jak się ogląda stronę WMs z ,,notowaniami'' nt/ koronawirusa w dniu X o godzinie T to jest to stan na X:T. Nawiasem mówiąc tak jest wygodniej, ale jednocześnie komplikuje to sprawę w aspekcie: dzienna liczba przypadków chociażby z uwagi na różnice czasu (jak w PL kończy się dzień to na Fiji jest w połowie inny; inna sprawa, że wątpię żeby ktoś się tym przejmował). Niemniej WMs ma rubrykę "nowe przypadki", tyle że nie bardzo wiadomo co to znaczy...

No więc po tym przydługim wstępie do rzeczy: jak się mają dane z WMs względem ECDC? Jak wspomniałem, na stronie WMs nie ma bazy -- jest tabela z danymi ze stanem ,,na teraz''. ECDC z kolei publikuje bazę w postaci arkusza kalkulacyjnego. Ściągam dane codziennie. Ze strony WMs o 21:00 (koniec dnia, przynajmniej w PL) oraz o 23:00 ze strony ECDC. Dane te wyglądają jakoś tak (WMs, po konwersji HTML→CSV):

date;country;totalC;newC;totalD;newD;totalT
04040600;USA;277467;+306;7402;+10;830095

Stempel czasu jest ustalany w momencie pobrania danych. Na stronie WMs czas nie jest podany explicite (nie ma czegoś takiego jak np. dane aktualizowano o H:M). Czyli 04040600 to dane z 2020/04/04 z godziny 6:00.

Dane ECDC wyglądają jakoś tak:

date;id;country;newc;newd;totalc;totald
2020-04-04;US;United_States_of_America;32425;1104;277965;7157

NewC -- nowe przypadki (dzienne); NewD -- nowe zgodny; totalC -- przypadki łącznie; totalD -- zgony łącznie. Baza ECDC ma stempel czasu (dzień).

W przypadku PL wiem, że Ministerstwo Zdrowia (MinZ) publikuje dane generalnie o godzinie 10-coś-tam oraz o 17/18-coś-tam. (Czemu tak nie wiem). Patrząc na dane z WMs wiedzę, że o 21:00 publikują już dane aktualne na ten dzień, w tym sensie, że uwzględnią stan z ostatniego dziennego komunikatu MinZ (ale jakiego formalnie dnia te dane dotyczą, to już inna sprawa, bo ten dzień przecież się nie skończył :-)). Jeżeli chodzi o ECDC to dane pobrane w dniu X zawierają dane do dnia X-1, żeby było śmieszniej ECDC dla tego dnia przypisuje dane z komunikatu MinZ z dnia X-2. Czyli na przykładzie: arkusz pobrany o 23:00 dnia 24/04/2020 będzie miał ostatni wiersz datowany 23/04 ale dane w tym wierszu będą tymi które pojawiły się na stronie MinZ w dniu 22/04.

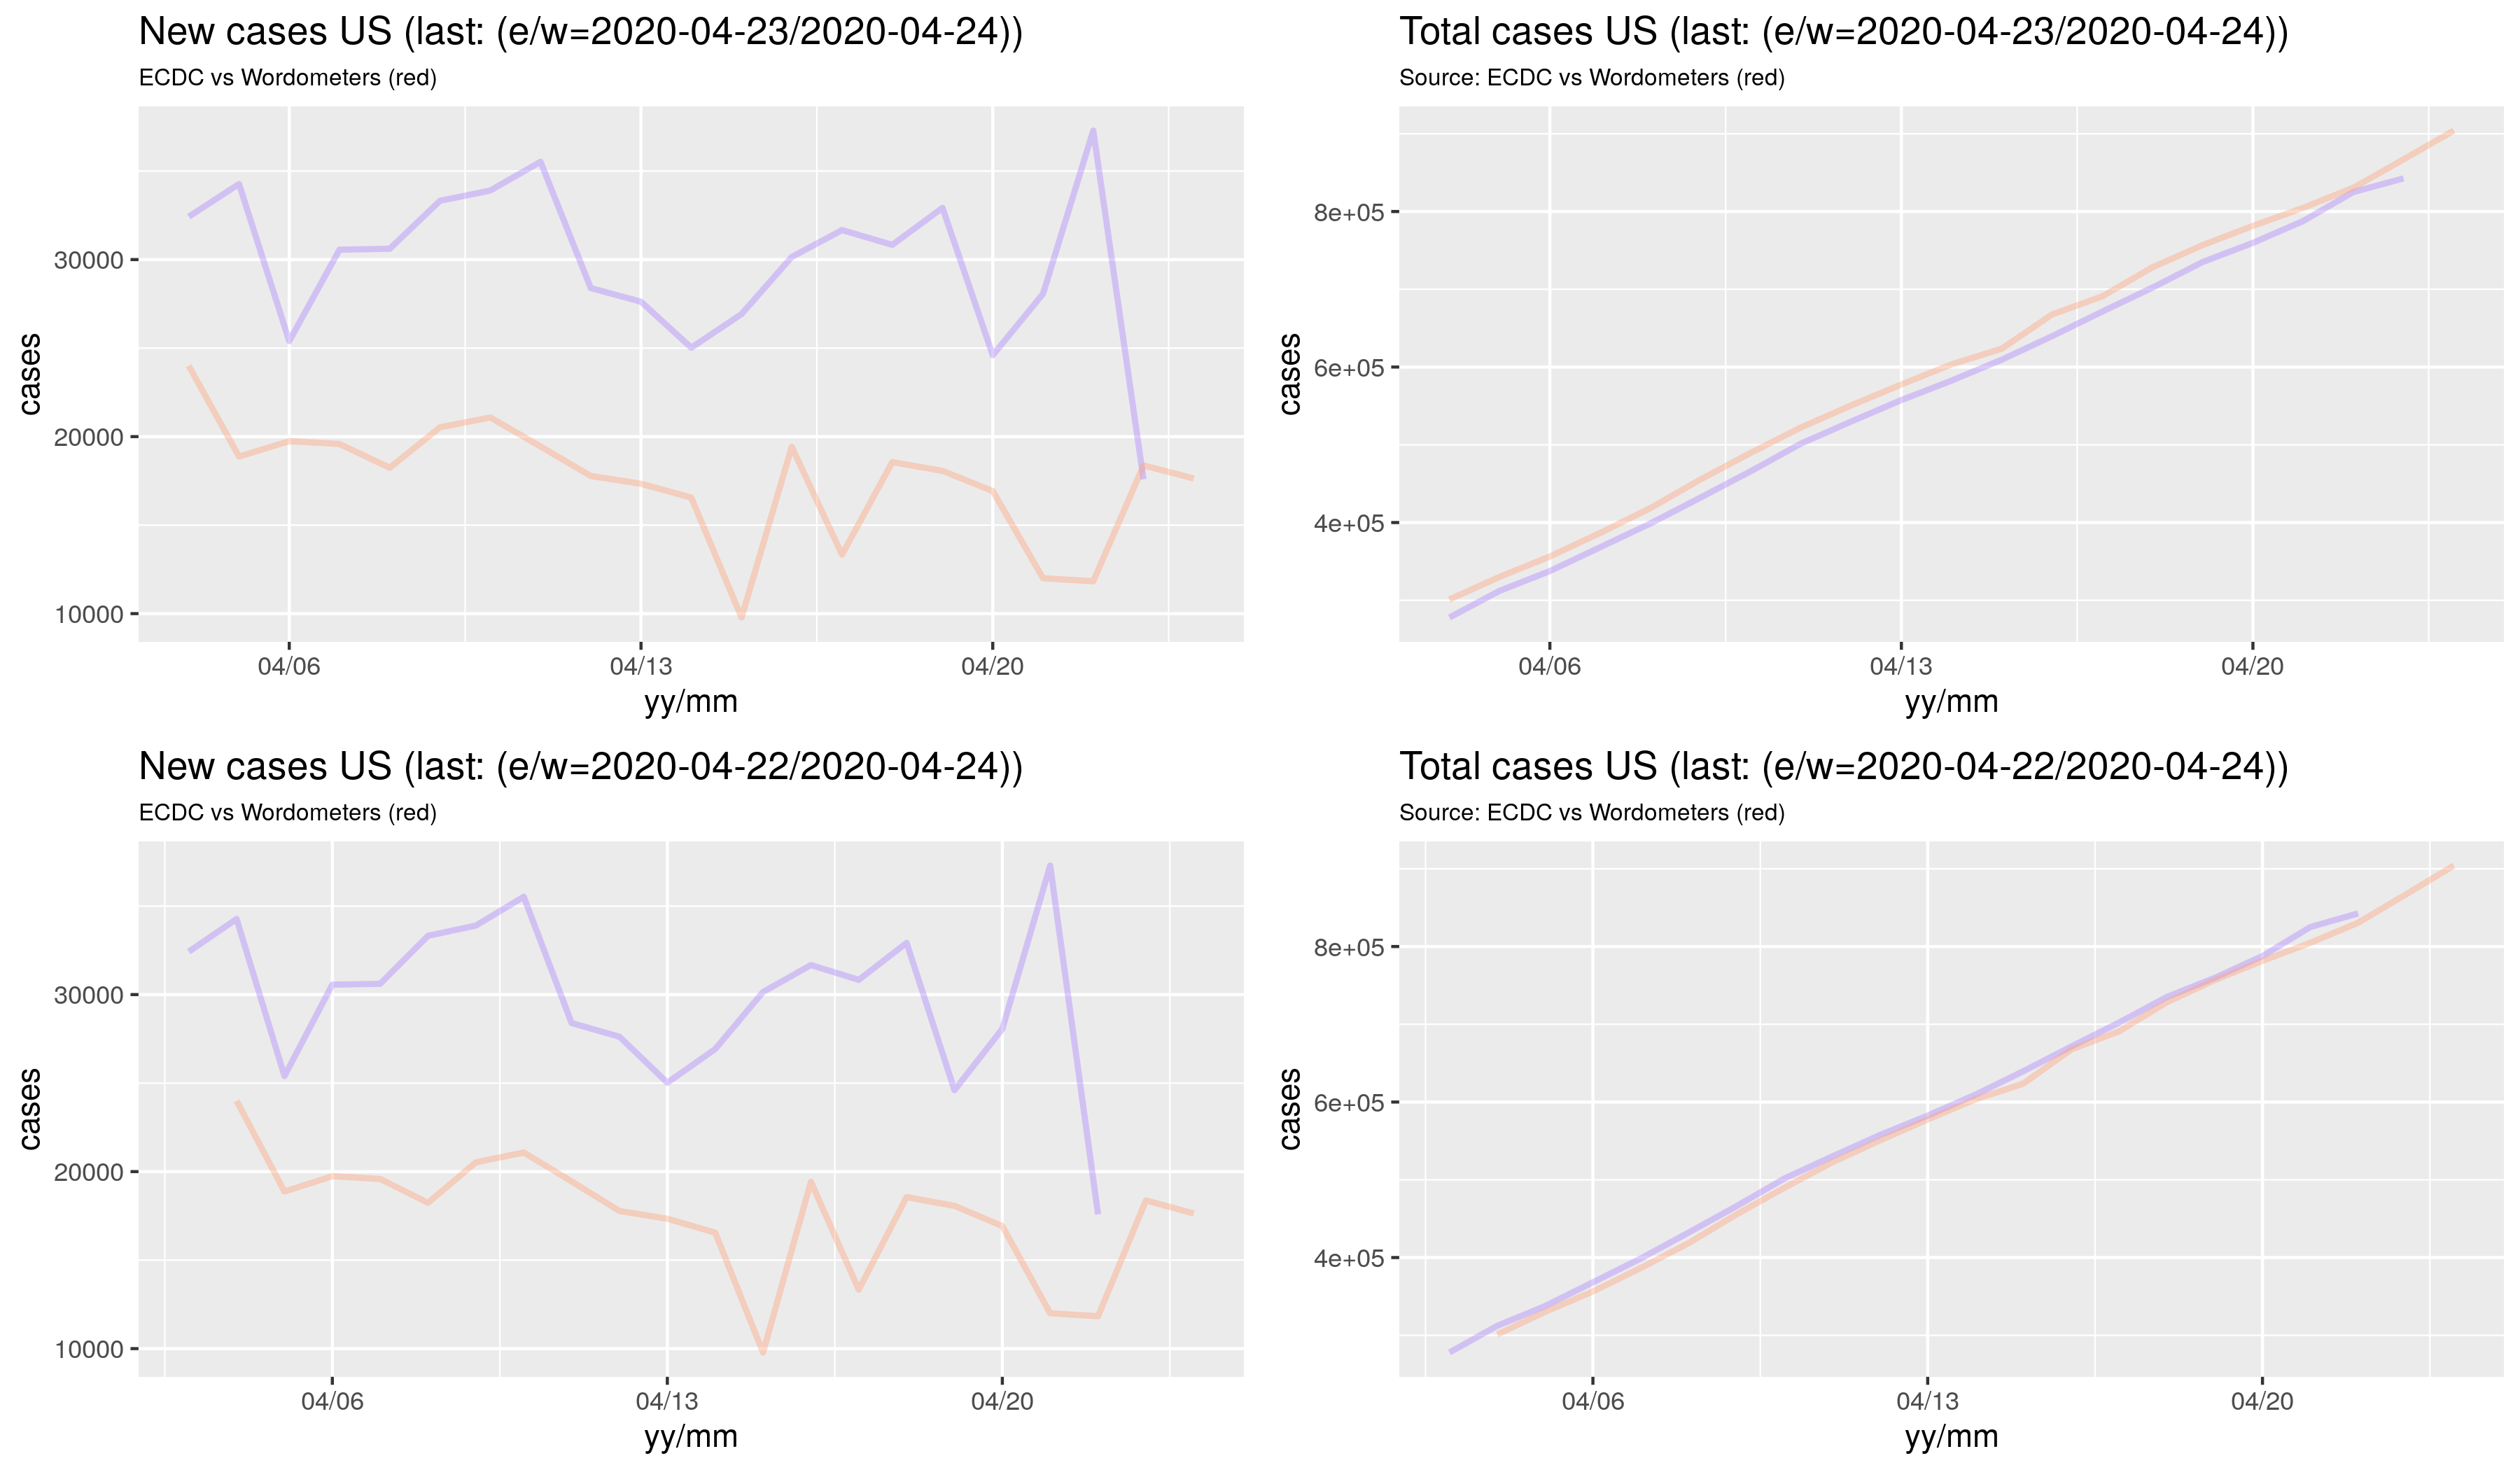
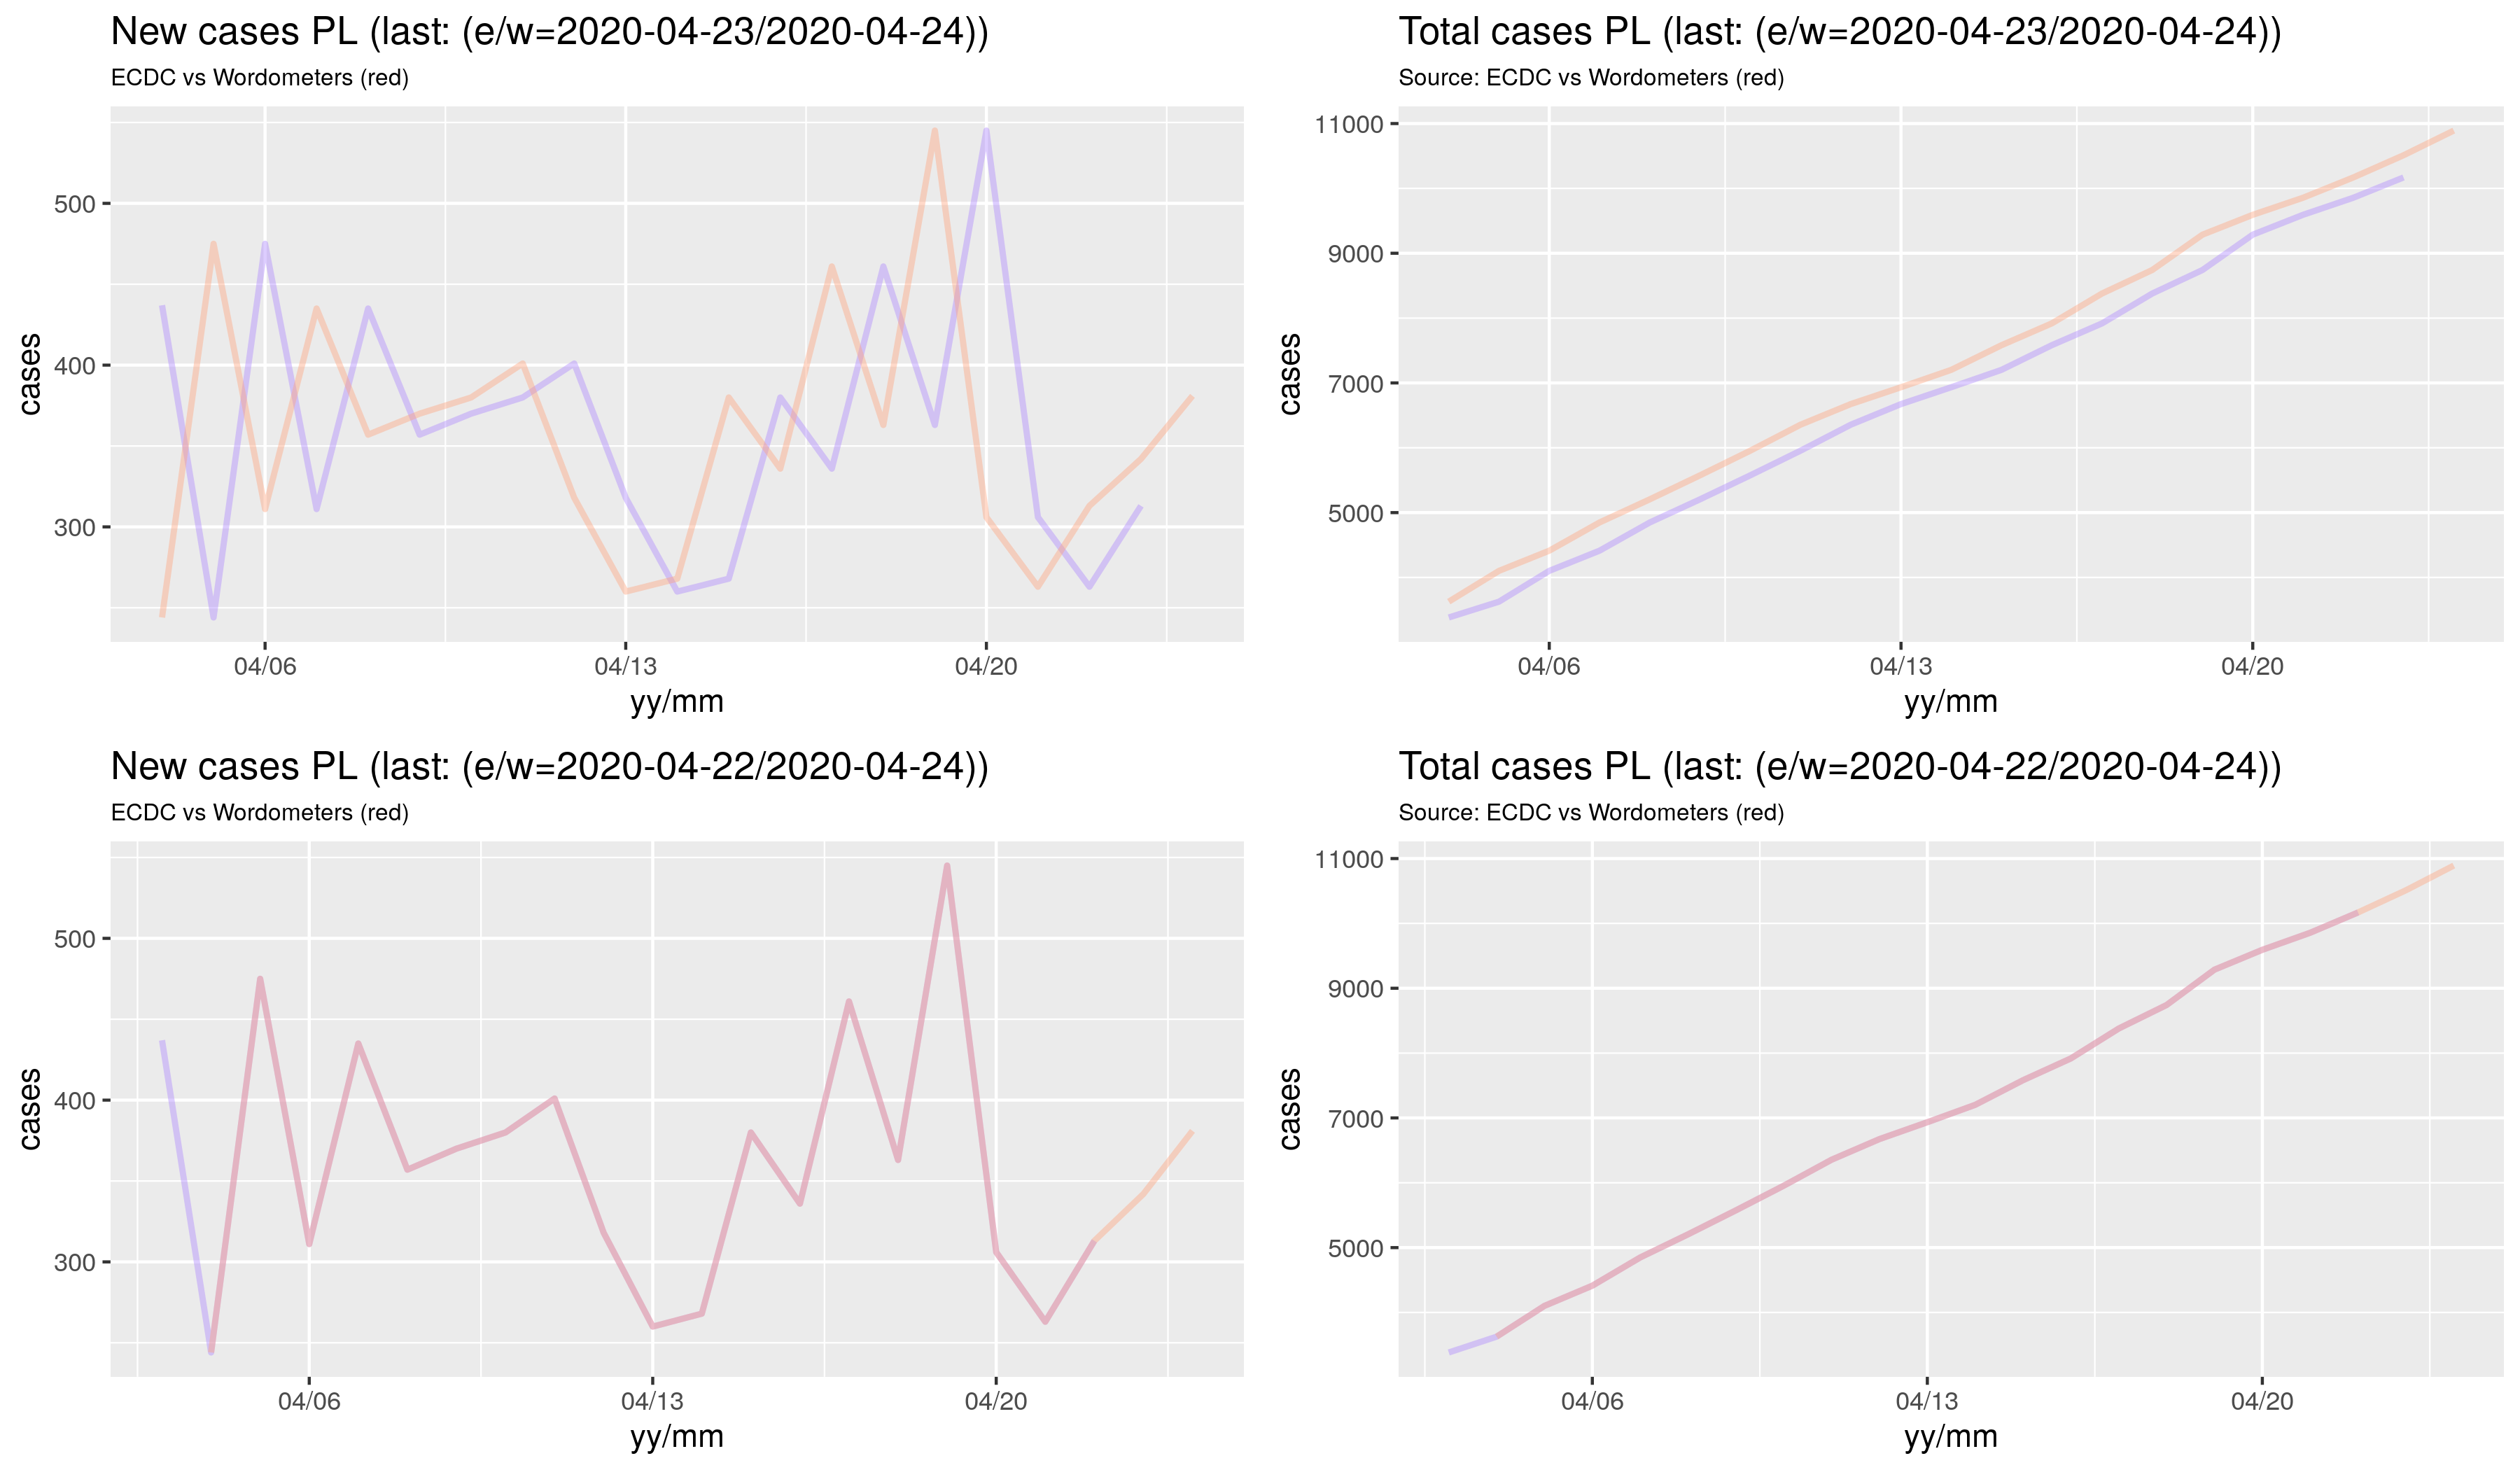
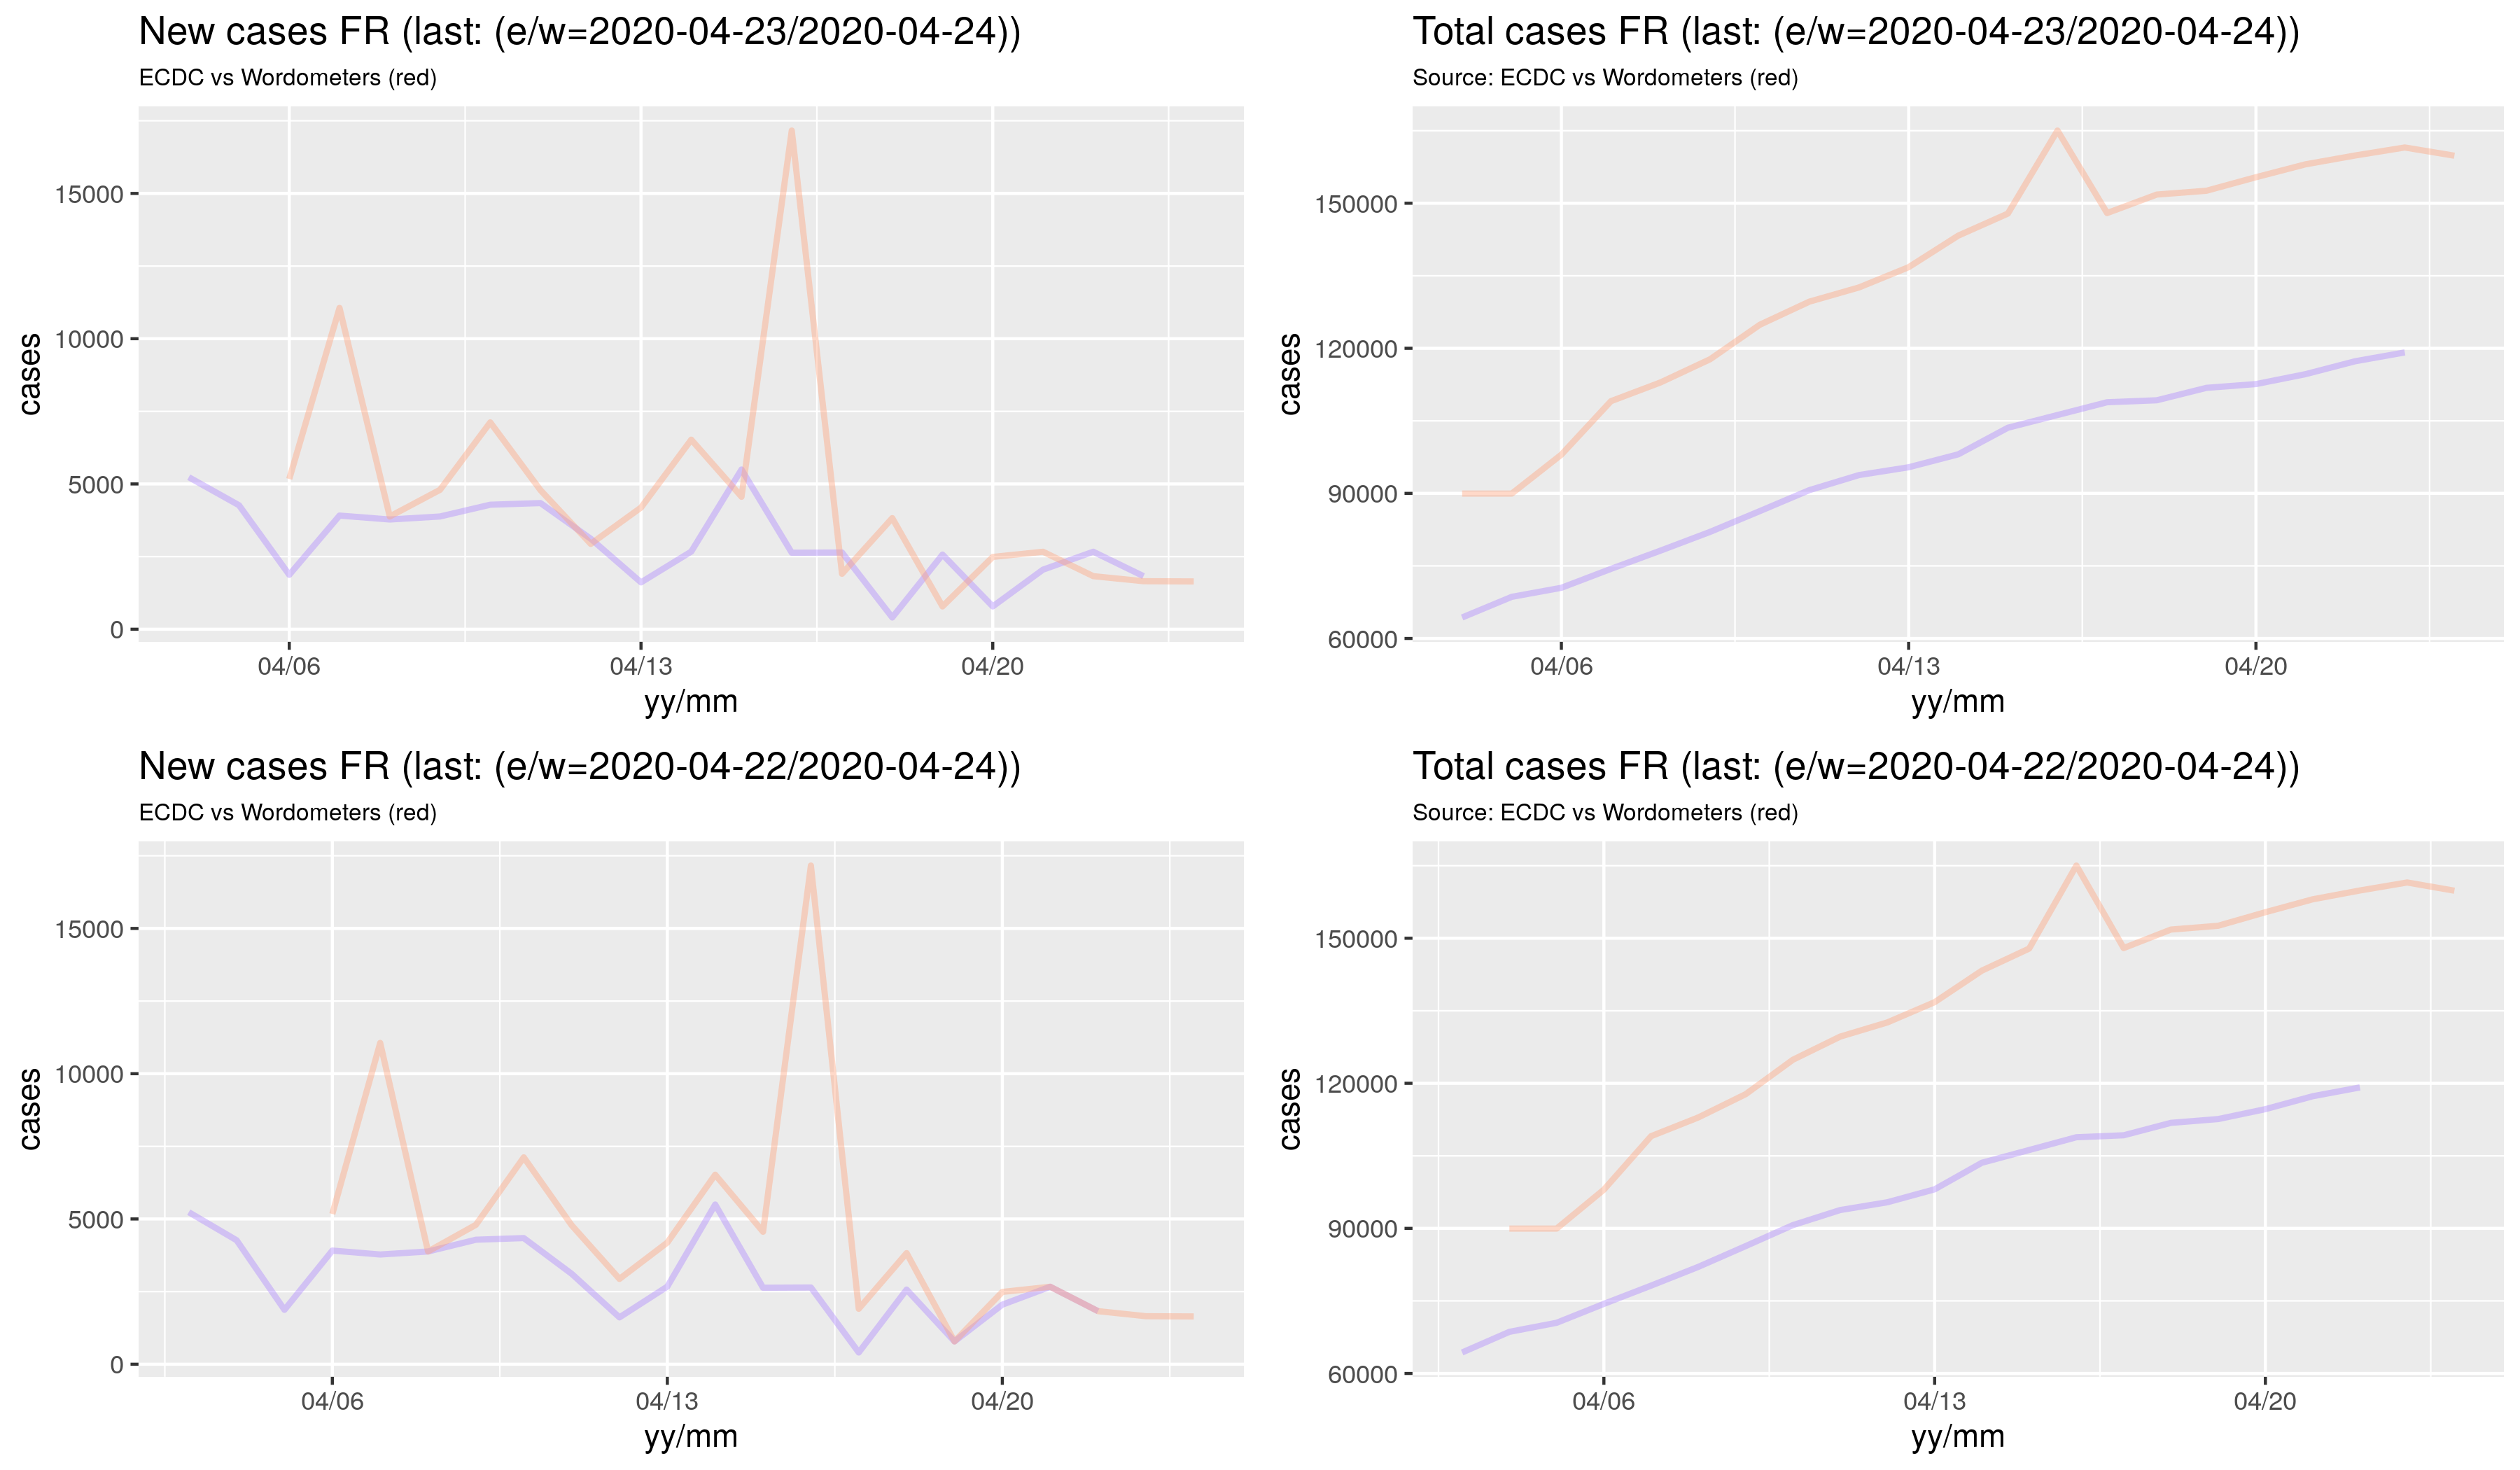
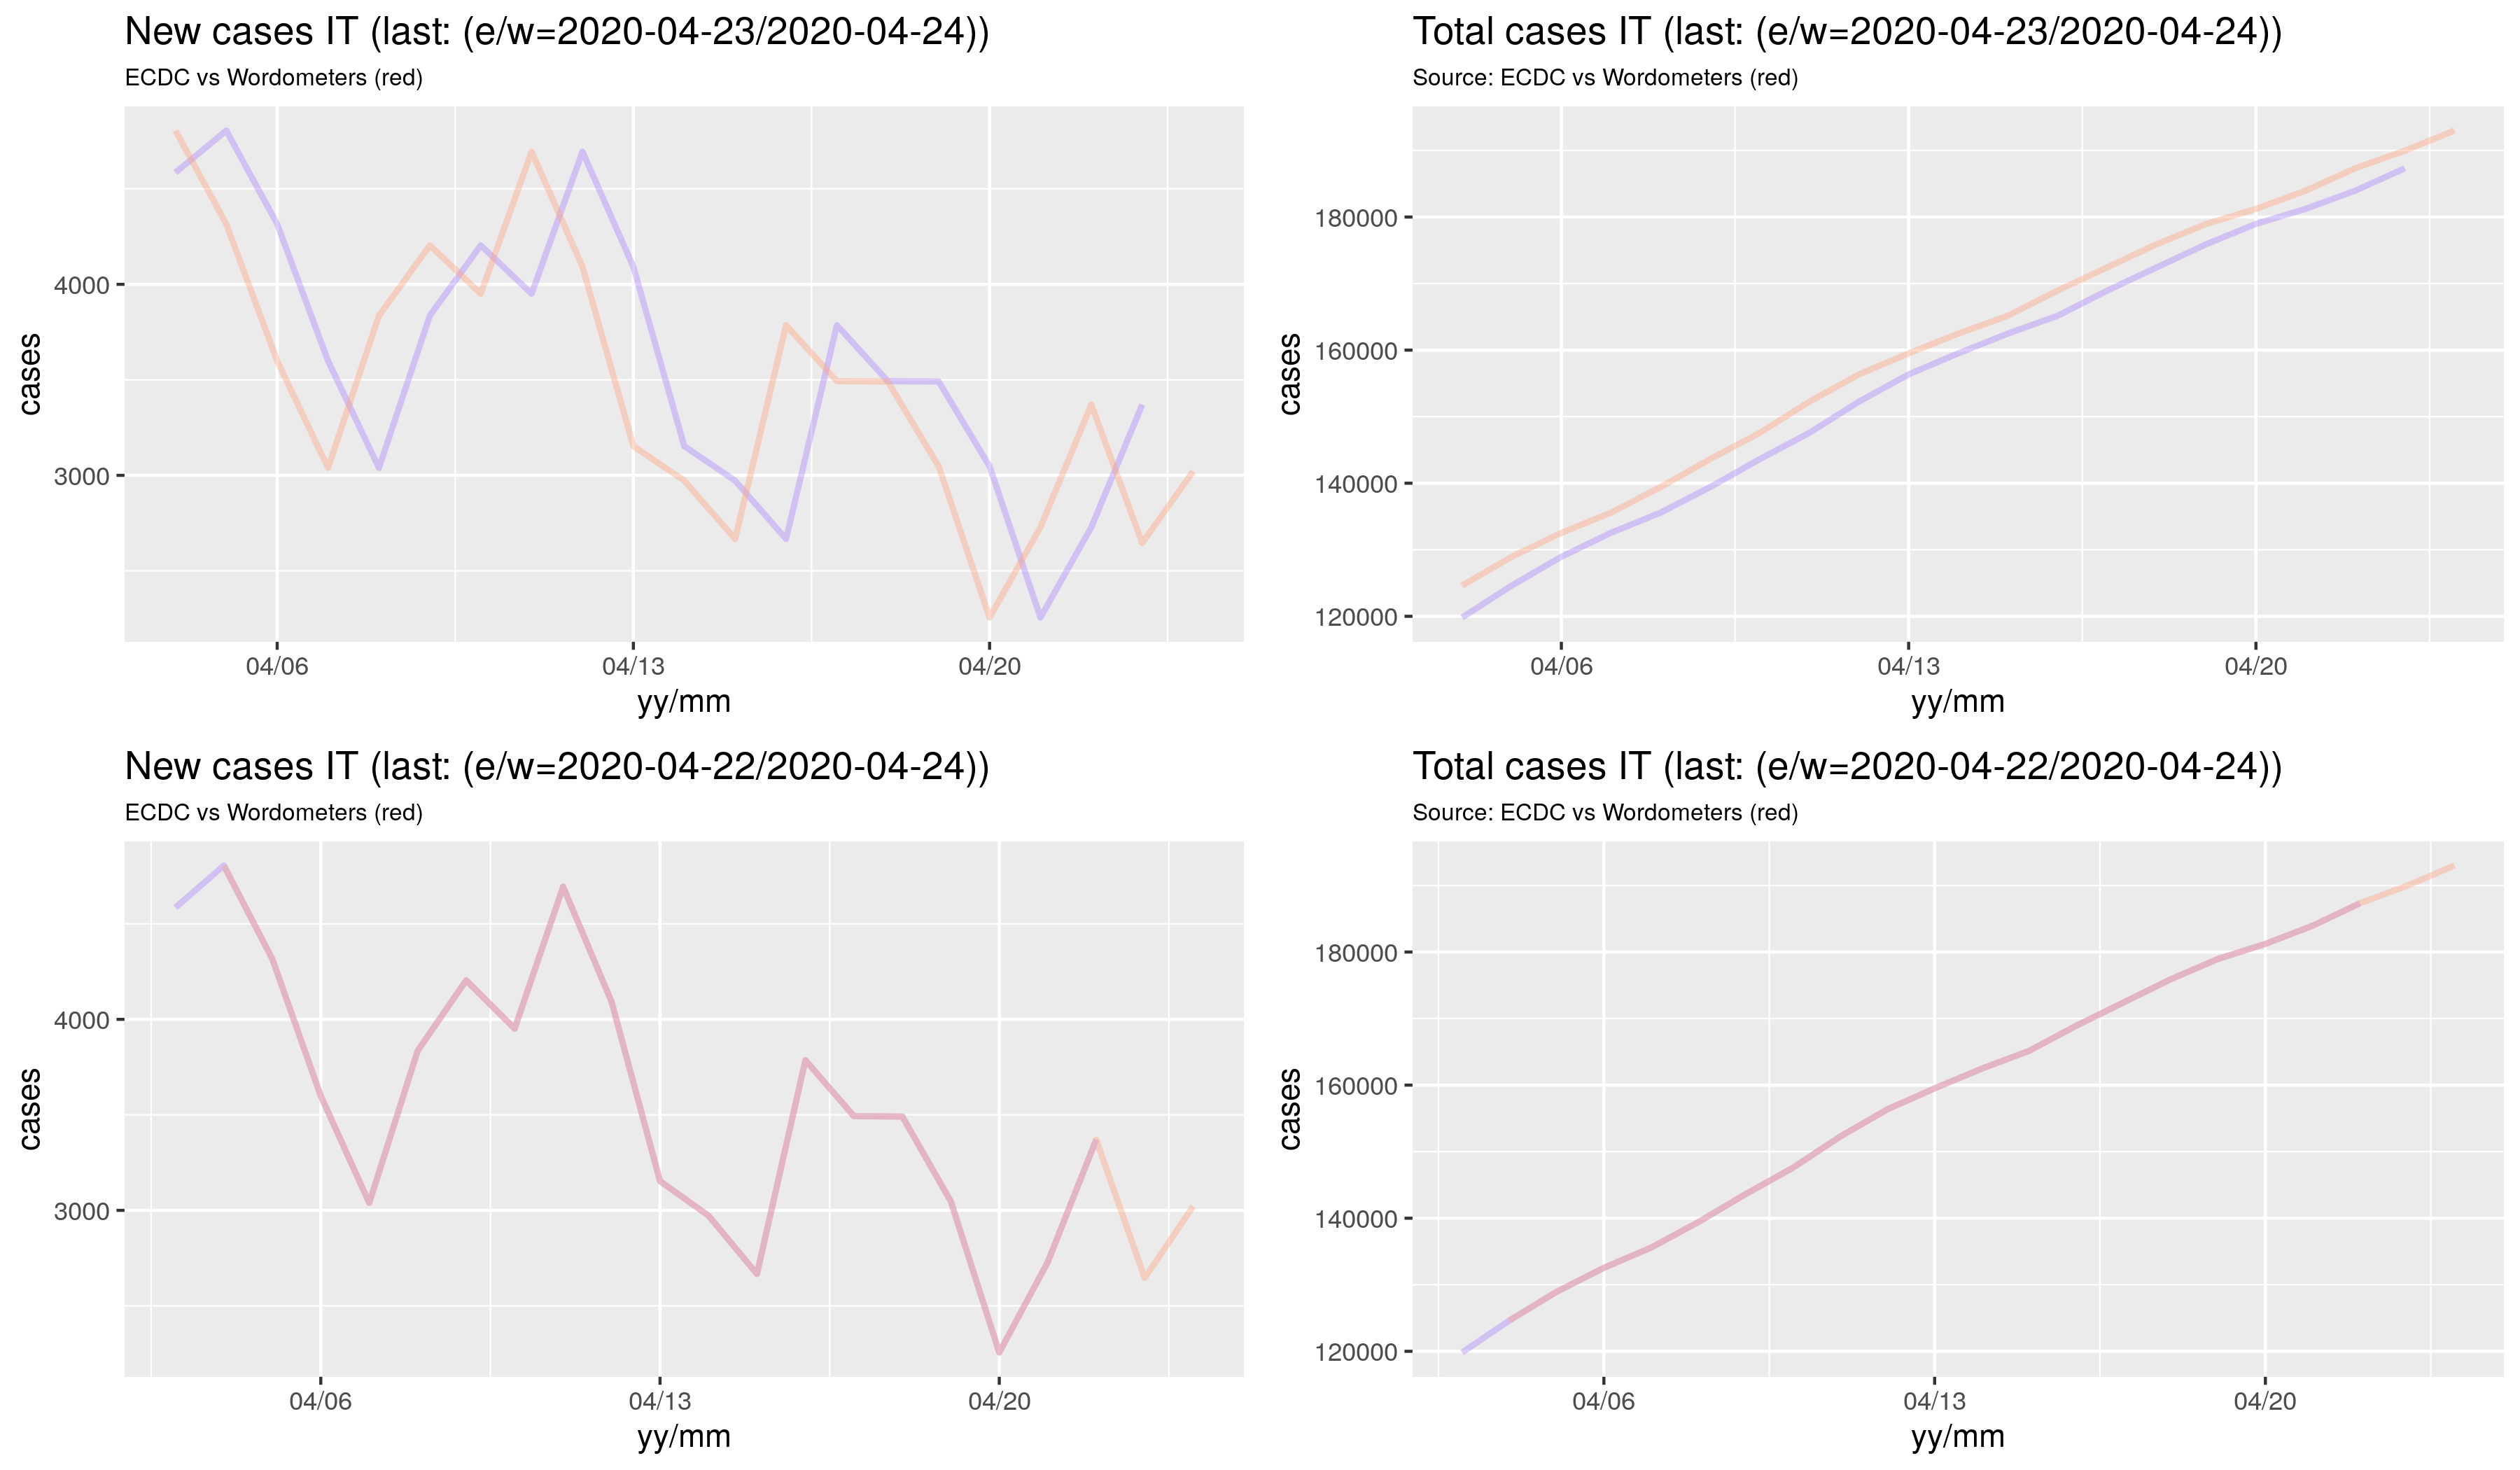
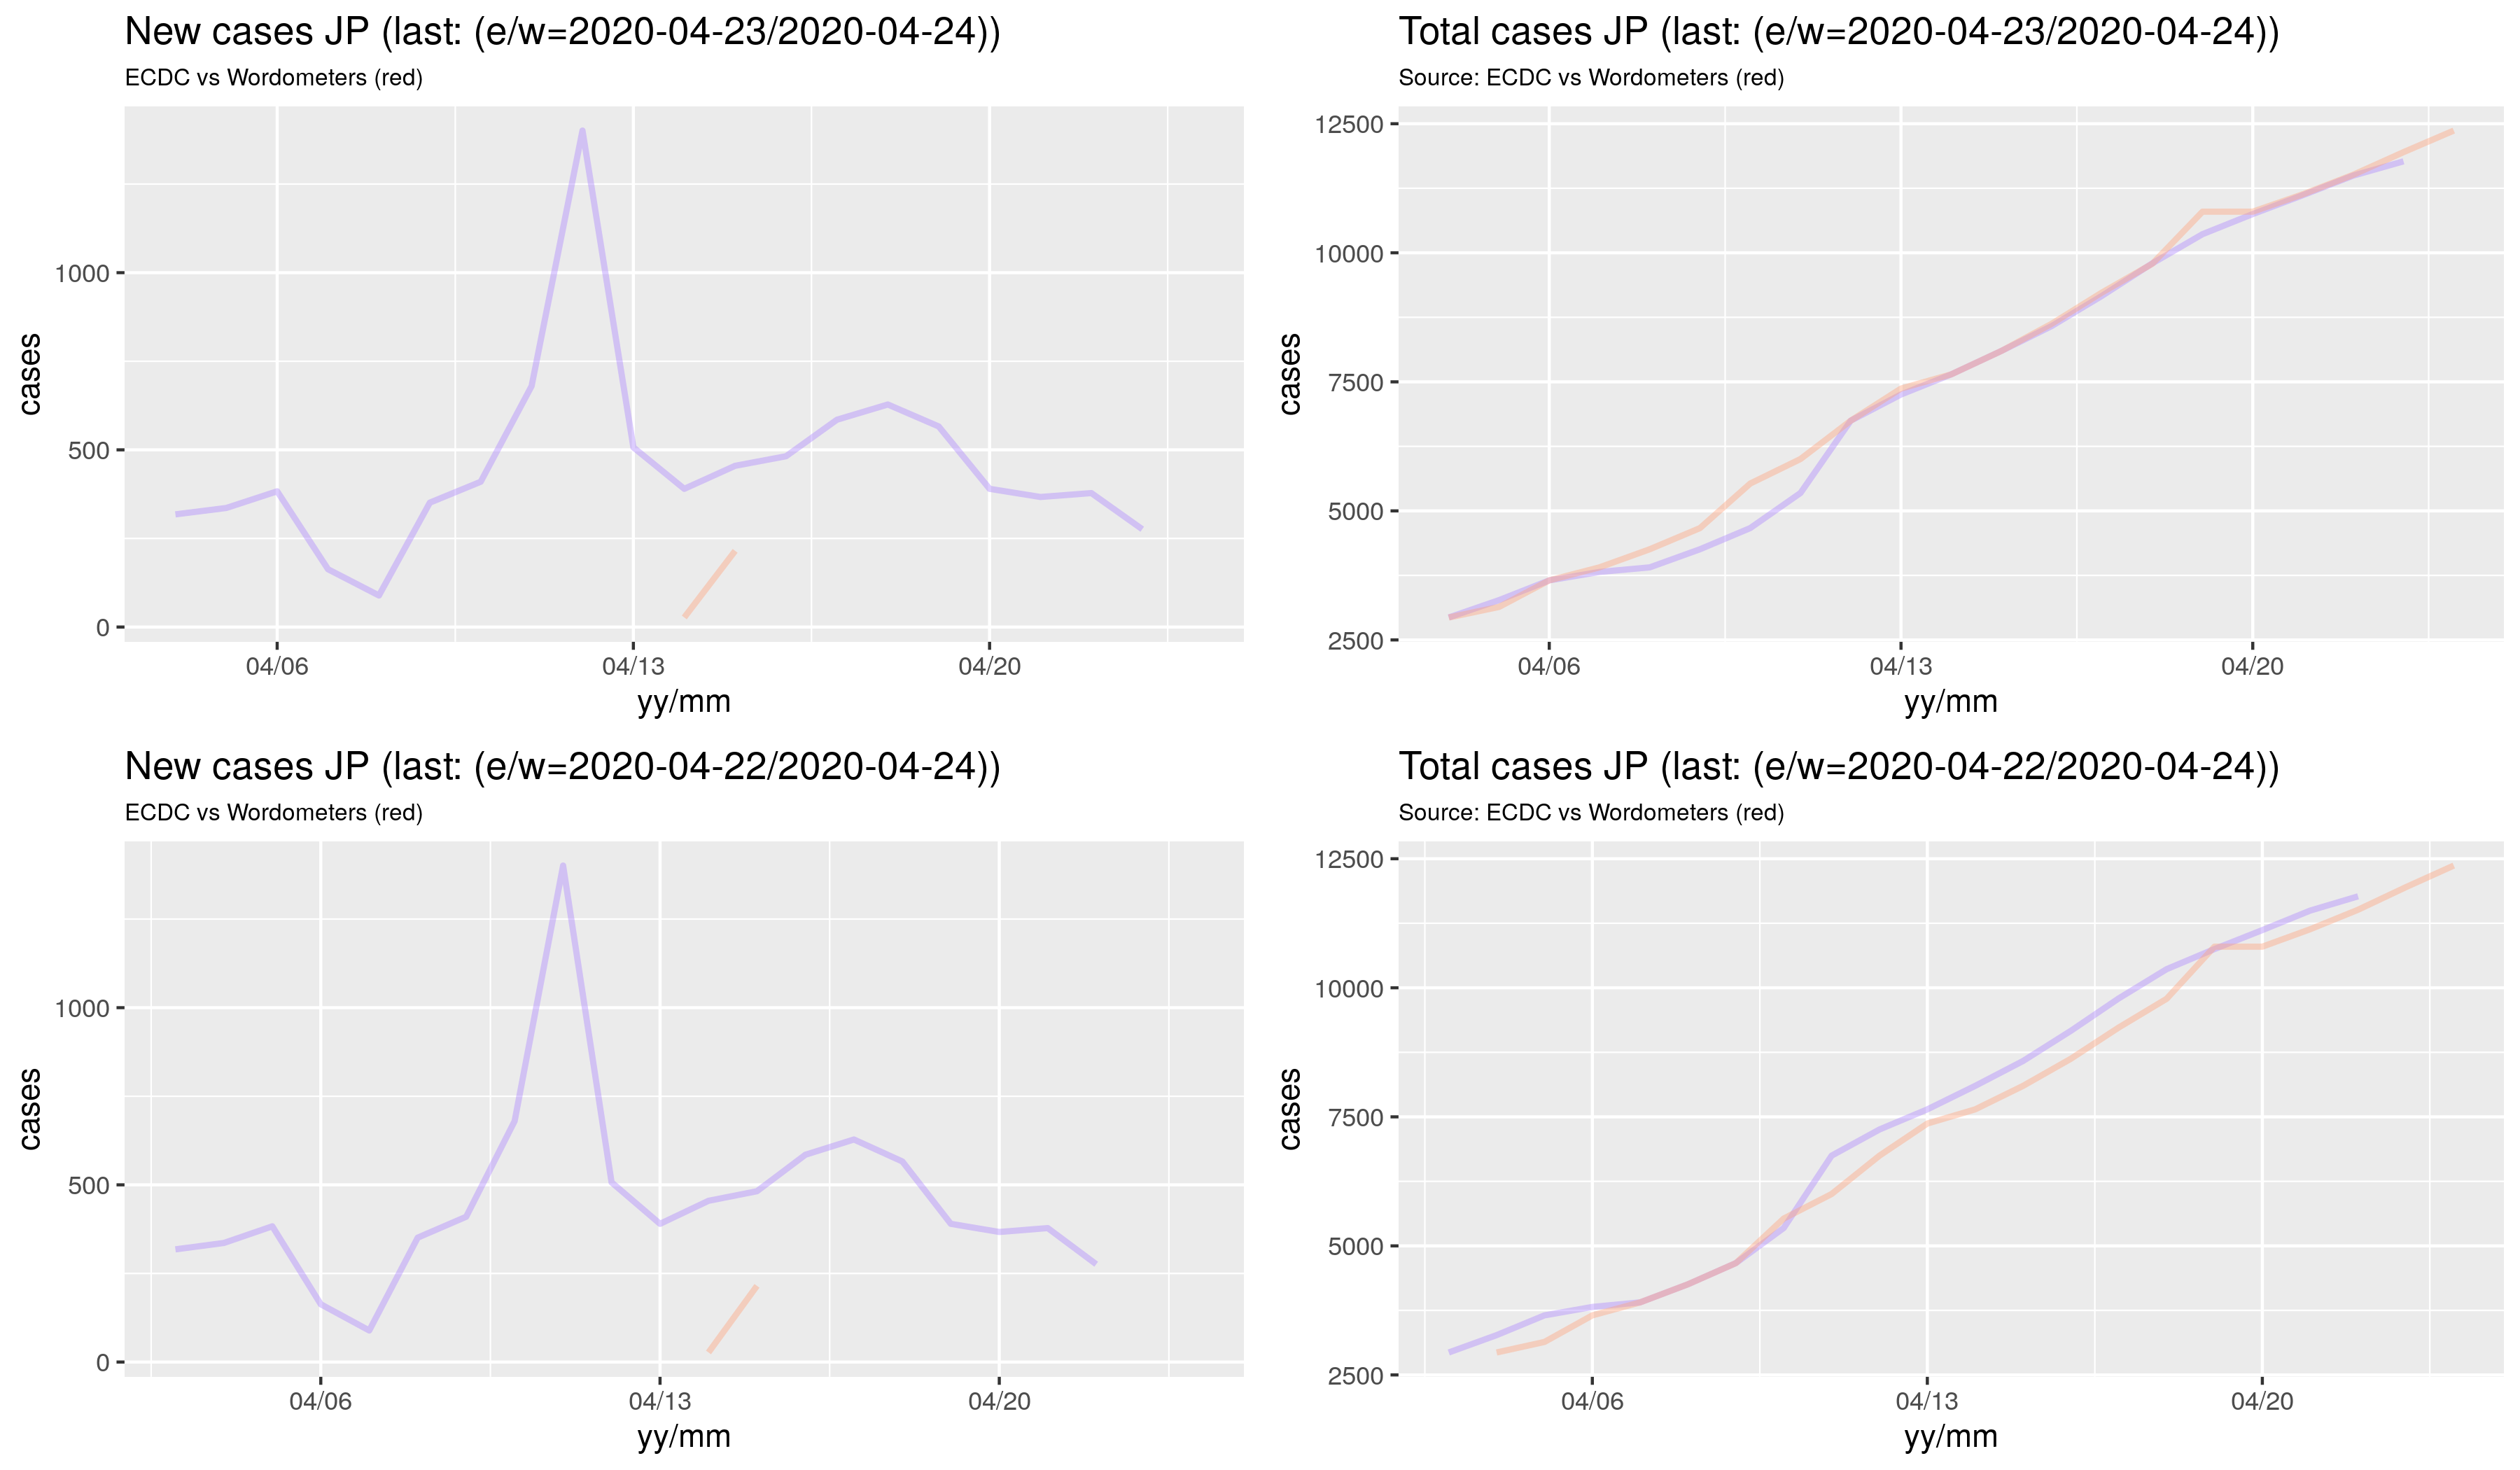
Uzbrojony o tę wiedzę dla wybranych 24 krajów wykreśliłem dane (z kwietnia) w wersji WMs oraz ECDC, w dwóch wariantach: z oryginalnymi stemplami czasowymi (górny wiersz) oraz ze stemplem skorygowanym przy założeniu że dane ECDC są 24H opóźnione (czyli dzień 23/04 tak naprawdę to dzień 22/04 itd). Te ,,skorygowane dane'' to dolny wiersz. Dla 90% krajów dane łącznie nakładają się czyli dane są identyczne (są wyjątki--ciekawe czemu). Dane dzienne to misz-masz, każda baza ma własną wersję, nie wiadomo która jest prawdziwa, tyle, że ECDC ma zawsze dane dzienne a WMs niekoniecznie (dla Japonii prawie zawsze ta kolumna była pusta)

Dane i komplet wykresów jest tutaj

Poniżej kilka wybranych krajów:

poniedziałek, 13 kwietnia 2020

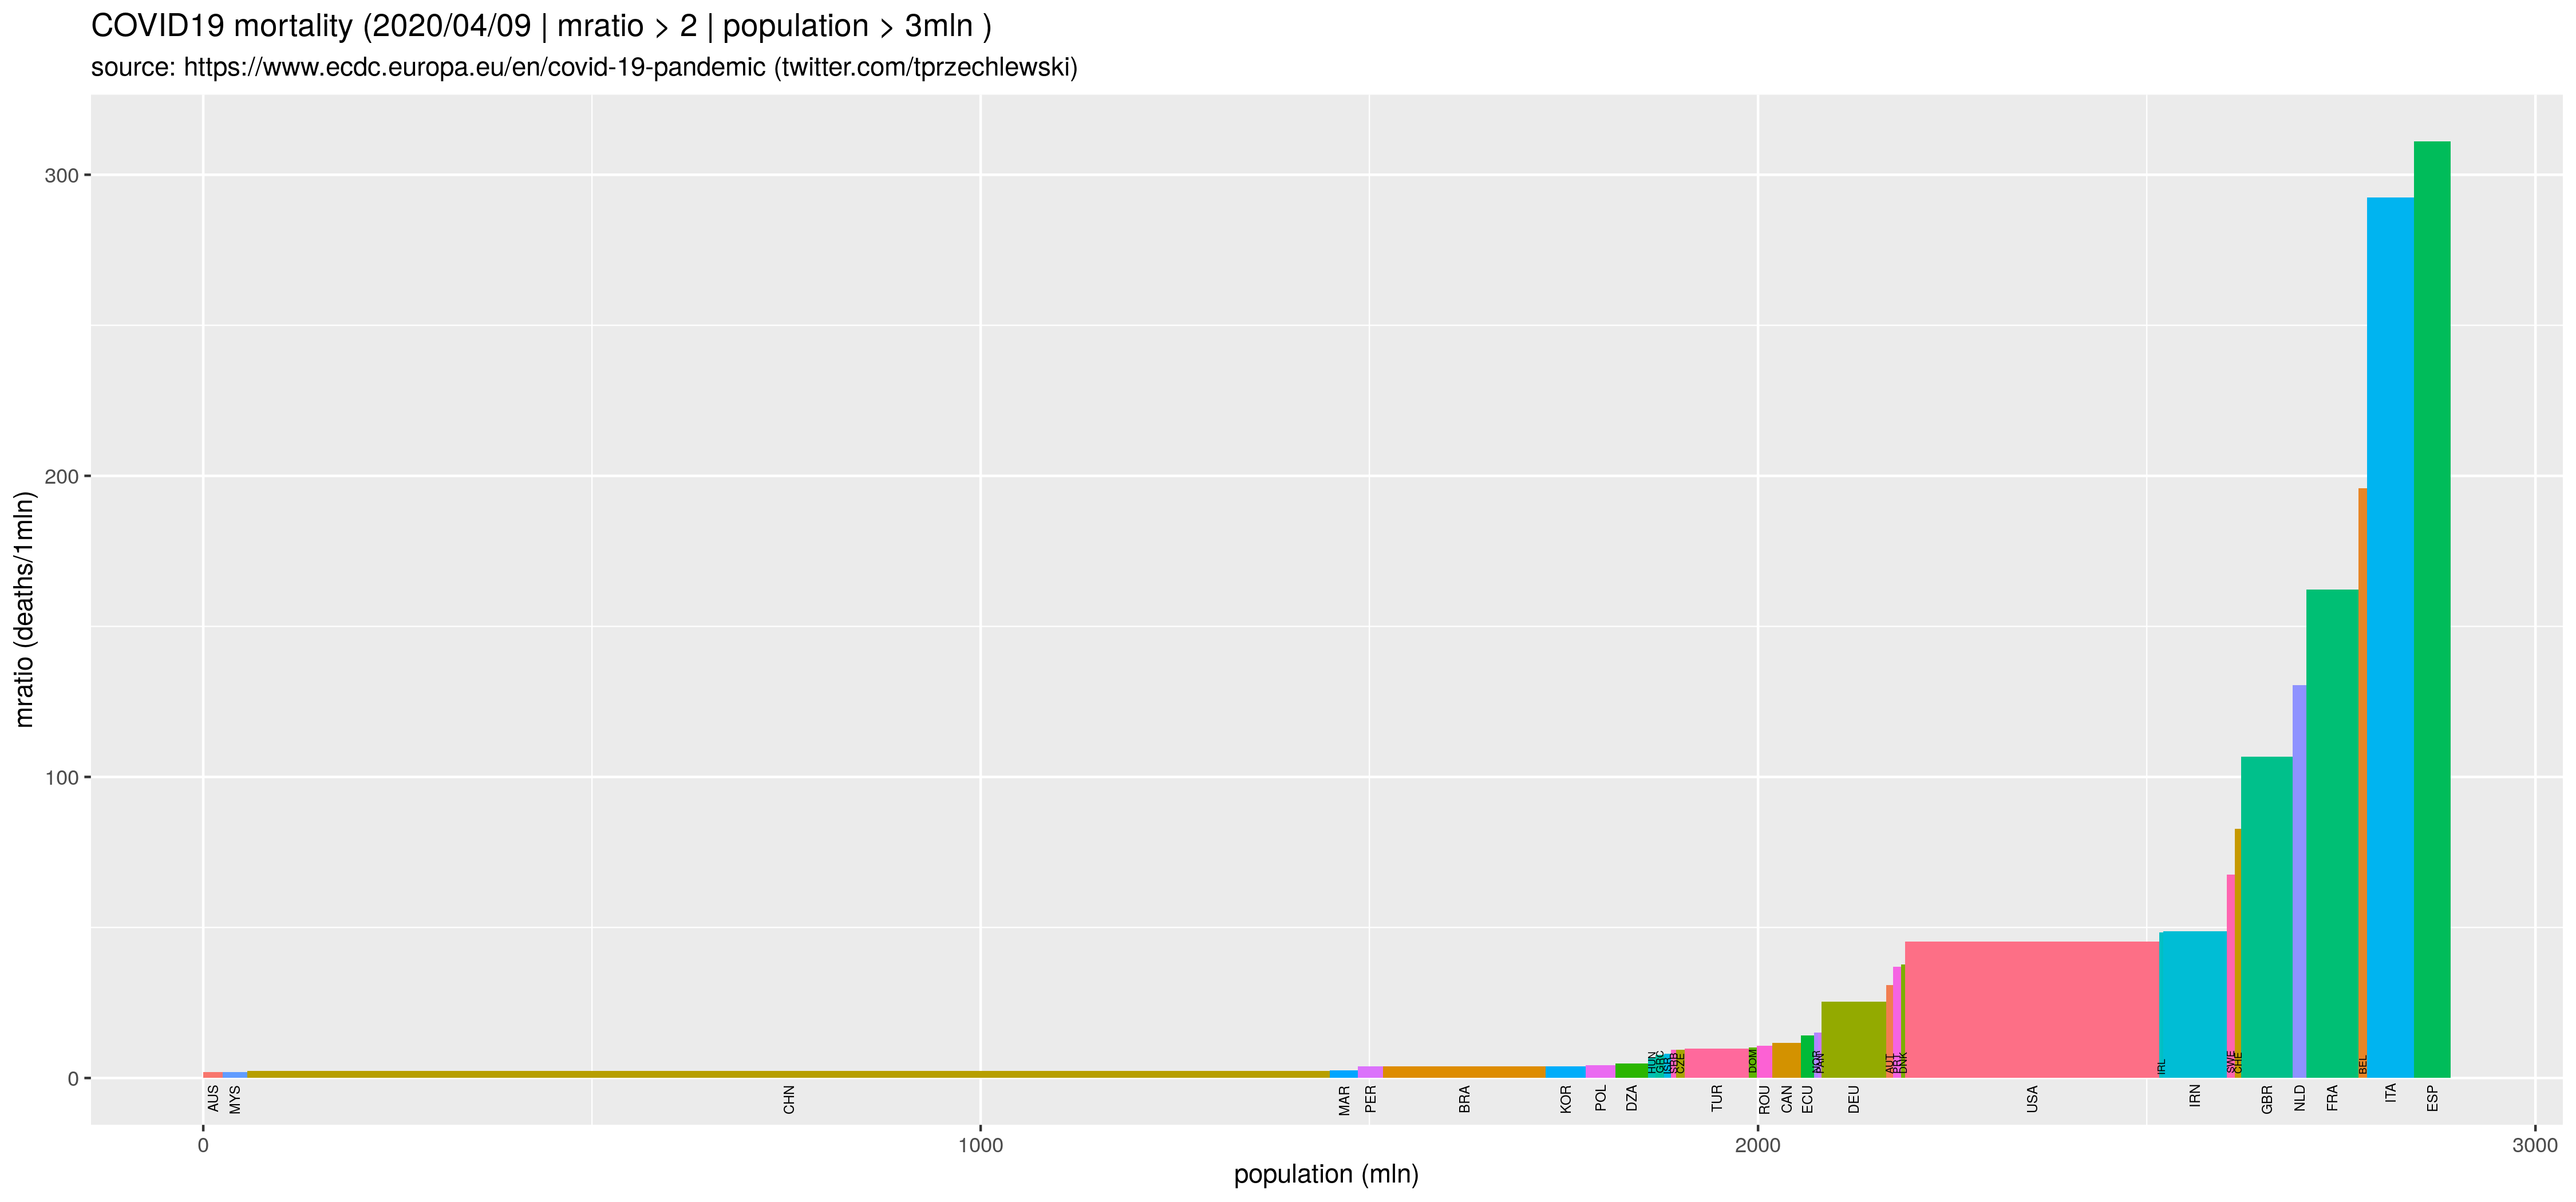
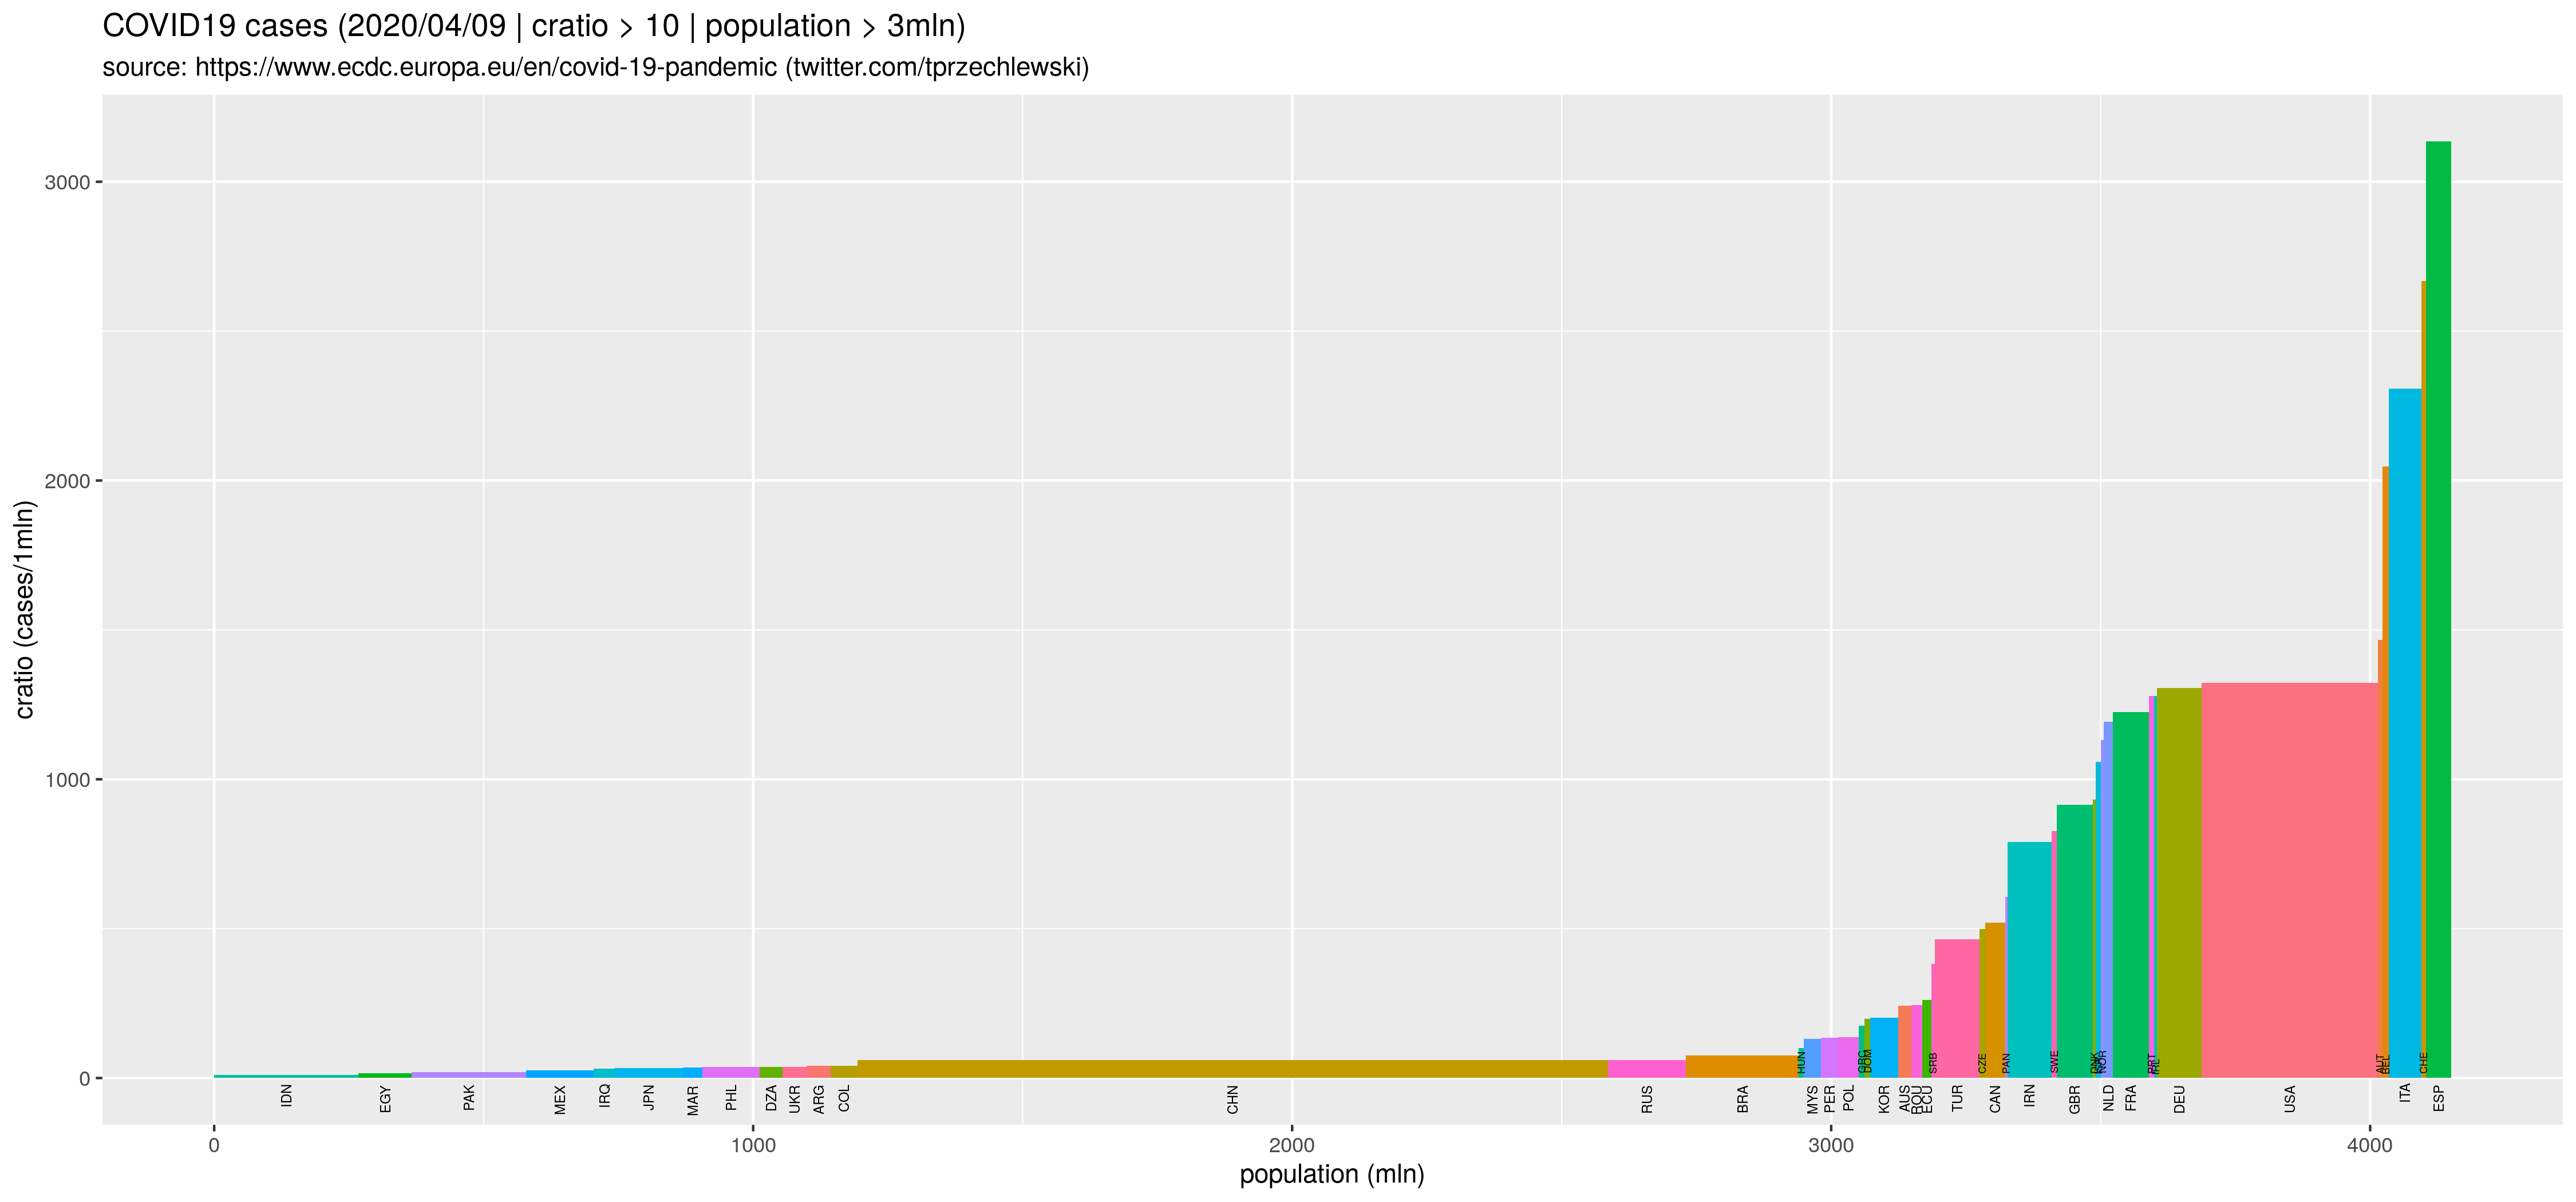
Wykresy typu Marimekko na przykładzie COVID19

Marimekko to zestawiony do 100% wykres słupkowy, gdzie szerokość słupka jest proporcjonalna do jego udziału w liczebności. (https://predictivesolutions.pl/wykres-marimekko-czyli-analityczny-patchwork)

Nie wiem o co chodzi, ale patrząc na przykłady, to jest to wykres pokazujący strukturę dwóch zmiennych na raz. Coś jak skumulowany wykres słupkowy (stacked barchart), tyle że słupki mają zmienną szerokość, odpowiadającą udziałom/liczebnościom wartości jednej cechy. Dla każdego słupka z kolei poszczególne segmenty mają wysokości proporcjonalne do udziałów/liczebności wartości drugiej cechy (w tym słupku). Alternatywną nazwą jest wykres mozaikowy.

Ale jest też trochę inny wariant takich wykresów, dla przypadku kiedy dla każdej jednostki w populacji generalnej jest Wi = Ci/Ni. Jeżeli wysokość słupka jest proporcjonalna do wartości Wi, szerokość jest proporcjonalna do Ni, to pola są oczywiście w proporcji Ci. Przykładowo jeżeli populacją generalną są kraje świata, wartością cechy Ni jest liczba mieszkańców w kraju i, wartością cechy Ci wielkość emisja CO2 w kraju i, to Wi jest oczywiście emisją per capita.

Moim zdaniem użyteczne, bo pokazuje na raz dwa natężenia: łączne, w skali całej populacji oraz szczegółowe, w skali jednostki. Kontynuując przykład: ile emituje przeciętny mieszkaniec kraju i oraz jaki jest udział emisji kraju i w całości emisji.

W przypadku epidemii COVID19 podstawową zmienną jest liczba zarażonych/zmarłych w kraju i. Ale jeżeli chcemy porównać kraj i z krajem j to oczywiście należy uwzględnić liczbę mieszkańców w obu krajach. Czyli wysokości słupków powinny odpowiadać liczbie zarażonych/zmarłych na jednostkę (np. na 1mln) a szerokości liczbie mieszkańców:

library(ggplot2)
library(dplyr)

dat <- "2020/04/09"

d <- read.csv("indcs.csv", sep = ';',  header=T, na.string="NA");
## liczba ludności w milionach (szerokość):
d$popm <- d$pop / million

## Oblicz współczynniki na 1mln
d$casesr <- d$cases/d$popm
### Wysokość:
d$deathsr <- d$deaths/d$popm

## Ograniczamy liczbę krajów żeby zwiększyć czytelność wykresu
## Tylko kraje wykazujące zmarłych
d <- d %>% filter(deaths > 0) %>% as.data.frame
## Tylko kraje z min 2/1mln i populacji > 1mln
d9 <- d %>% filter(deathsr > 2 & popm > 3 & deaths > 49) %>% droplevels() %>%
 arrange (deathsr) %>% as.data.frame

d9$w <- cumsum(d9$popm)
d9$wm <- d9$w - d9$popm
d9$wt <- with(d9, wm + (w - wm)/2)

d8$w <- cumsum(d8$popm)
d8$wm <- d8$w - d8$popm
d8$wt <- with(d8, wm + (w - wm)/2)

## Dzielimy etykiety na dwie grupy
## (inaczej wiele etykiet zachodzi na siebie)
d9$iso3h <- d9$iso3
d9$iso3l <- d9$iso3
## Kraje o niskich  wartościach bez etykiet
d9$iso3h[ (d9$popm < 15 ) ] <- ""
## Kraje o wysokich  wartościach bez etykiet
d9$iso3l[ (d9$popm >= 15 ) ] <- ""

p9  <- ggplot(d9, aes(ymin = 0)) +
  ylab(label="mratio (deaths/1mln)") +
  xlab(label="population (mln)") +
  ggtitle(sprintf("COVID19 mortality (%s | mratio > 2 | population > 3mln )", dat), 
      subtitle="source: https://www.ecdc.europa.eu/en/covid-19-pandemic (twitter.com/tprzechlewski)") +
  geom_rect(aes(xmin = wm, xmax = w, ymax = deathsr, fill = iso3)) +
  geom_text(aes(x = wt, y = 0, label = iso3h), vjust=+0.5, hjust=+1.25, size=2.0, angle = 90) +
  geom_text(aes(x = wt, y = 0, label = iso3l), vjust=+0.5, hjust=-0.20, size=1.5, angle = 90) +
  theme(legend.position = "none") 
  ## ... podobnie dla zmiennej casesr

Wynik w postaci rysunków:

Powyższe jest dostępne tutaj

niedziela, 12 kwietnia 2020

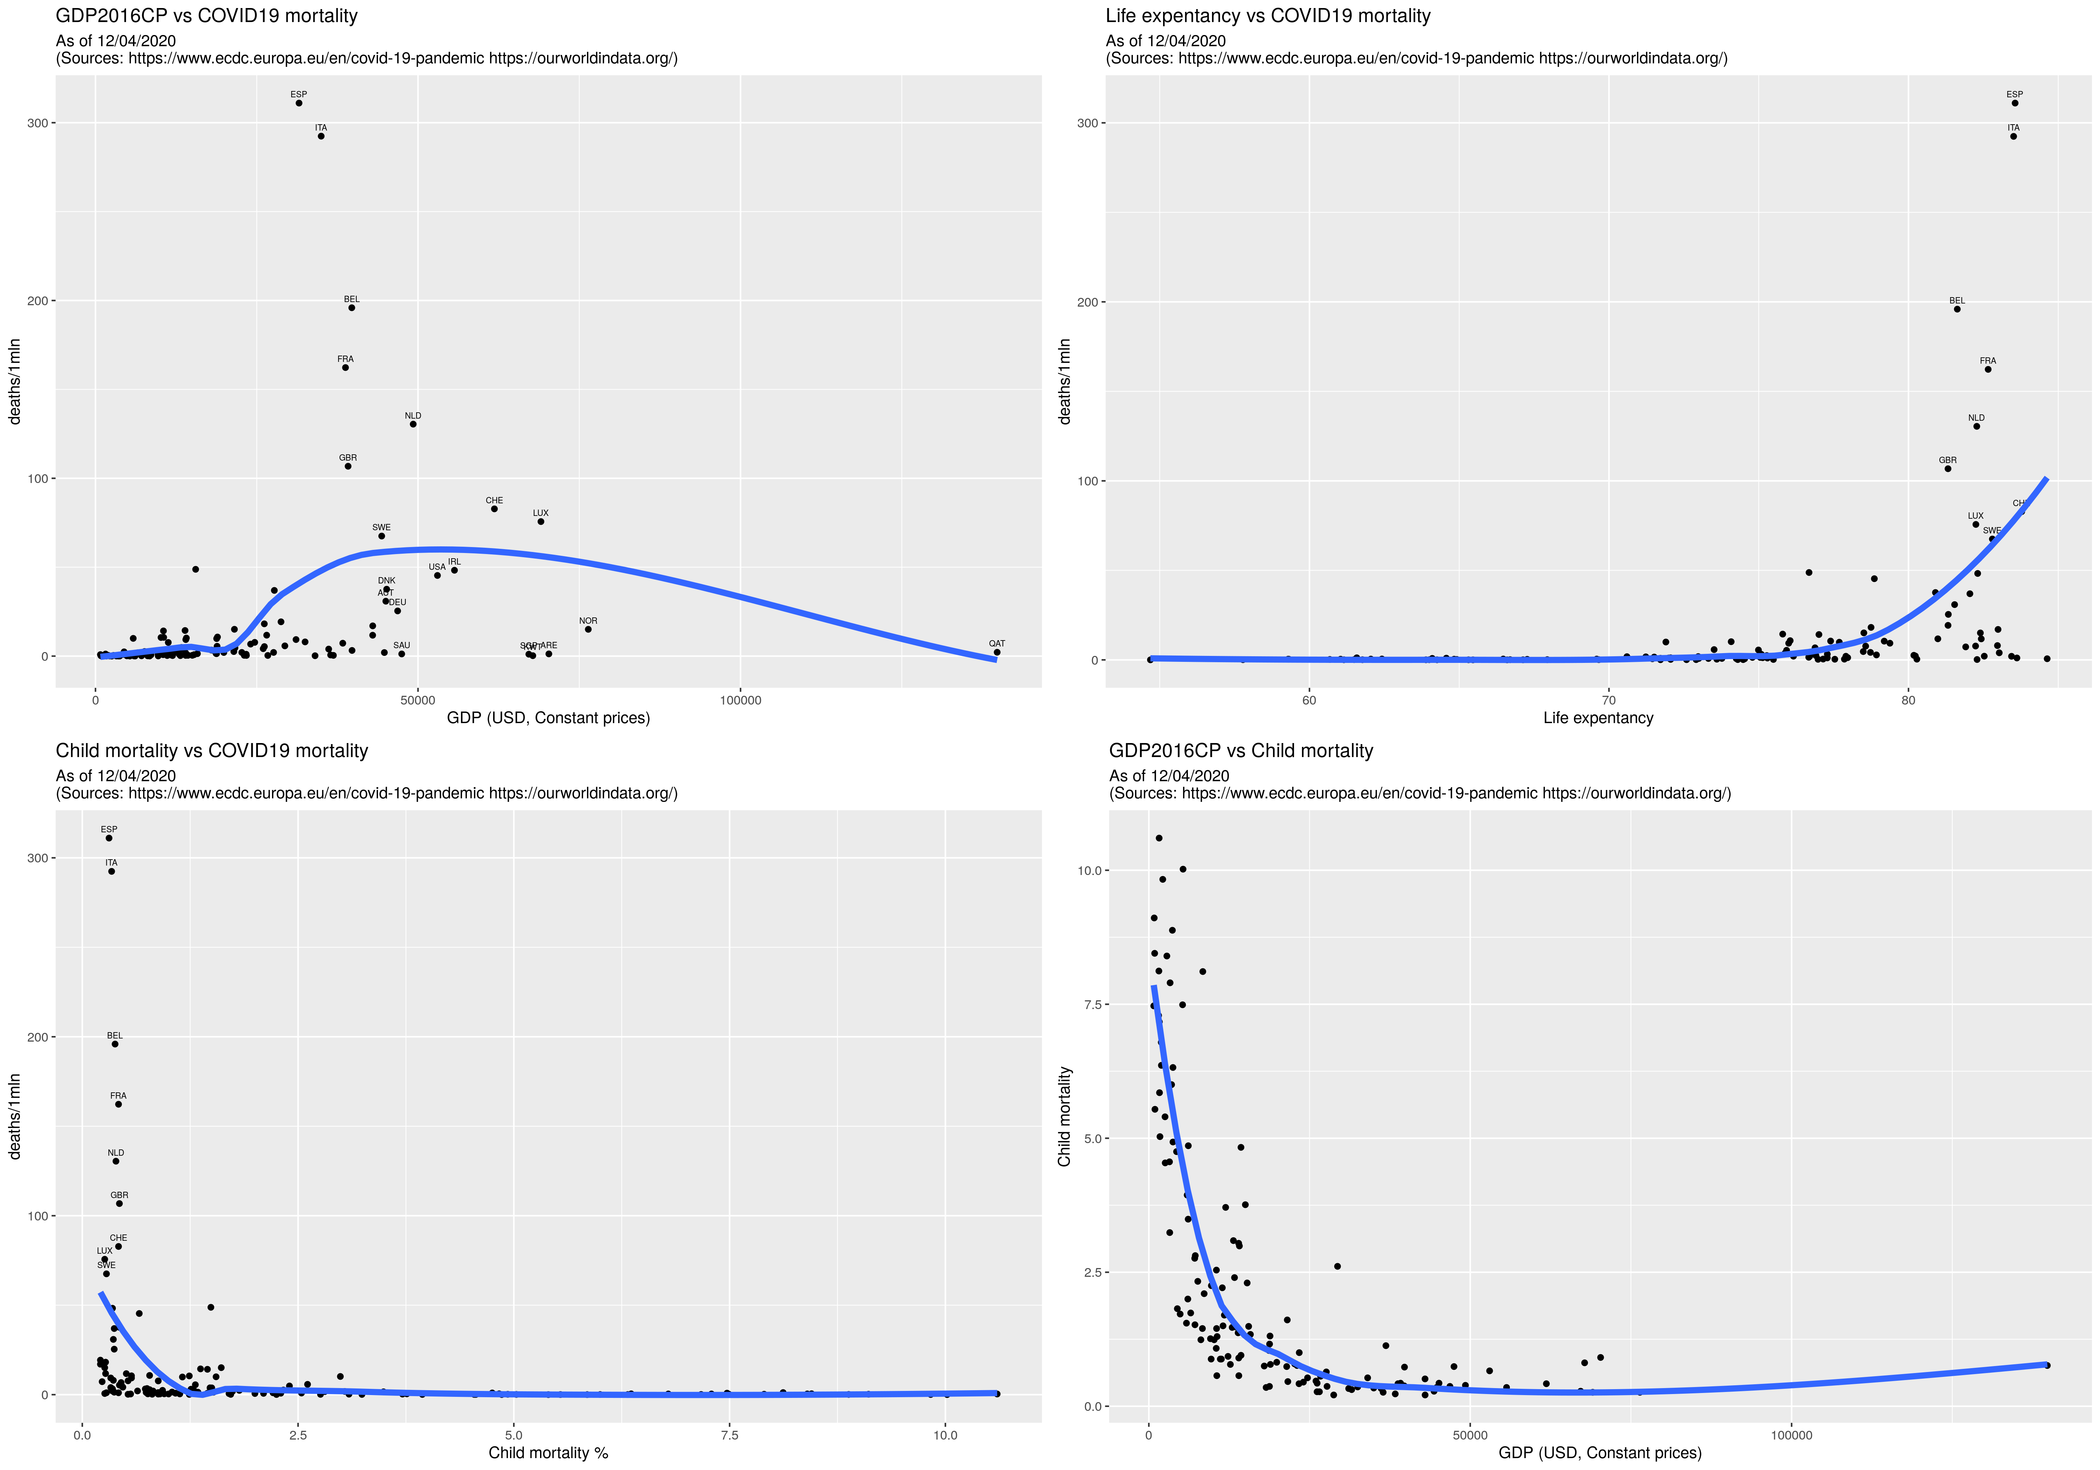
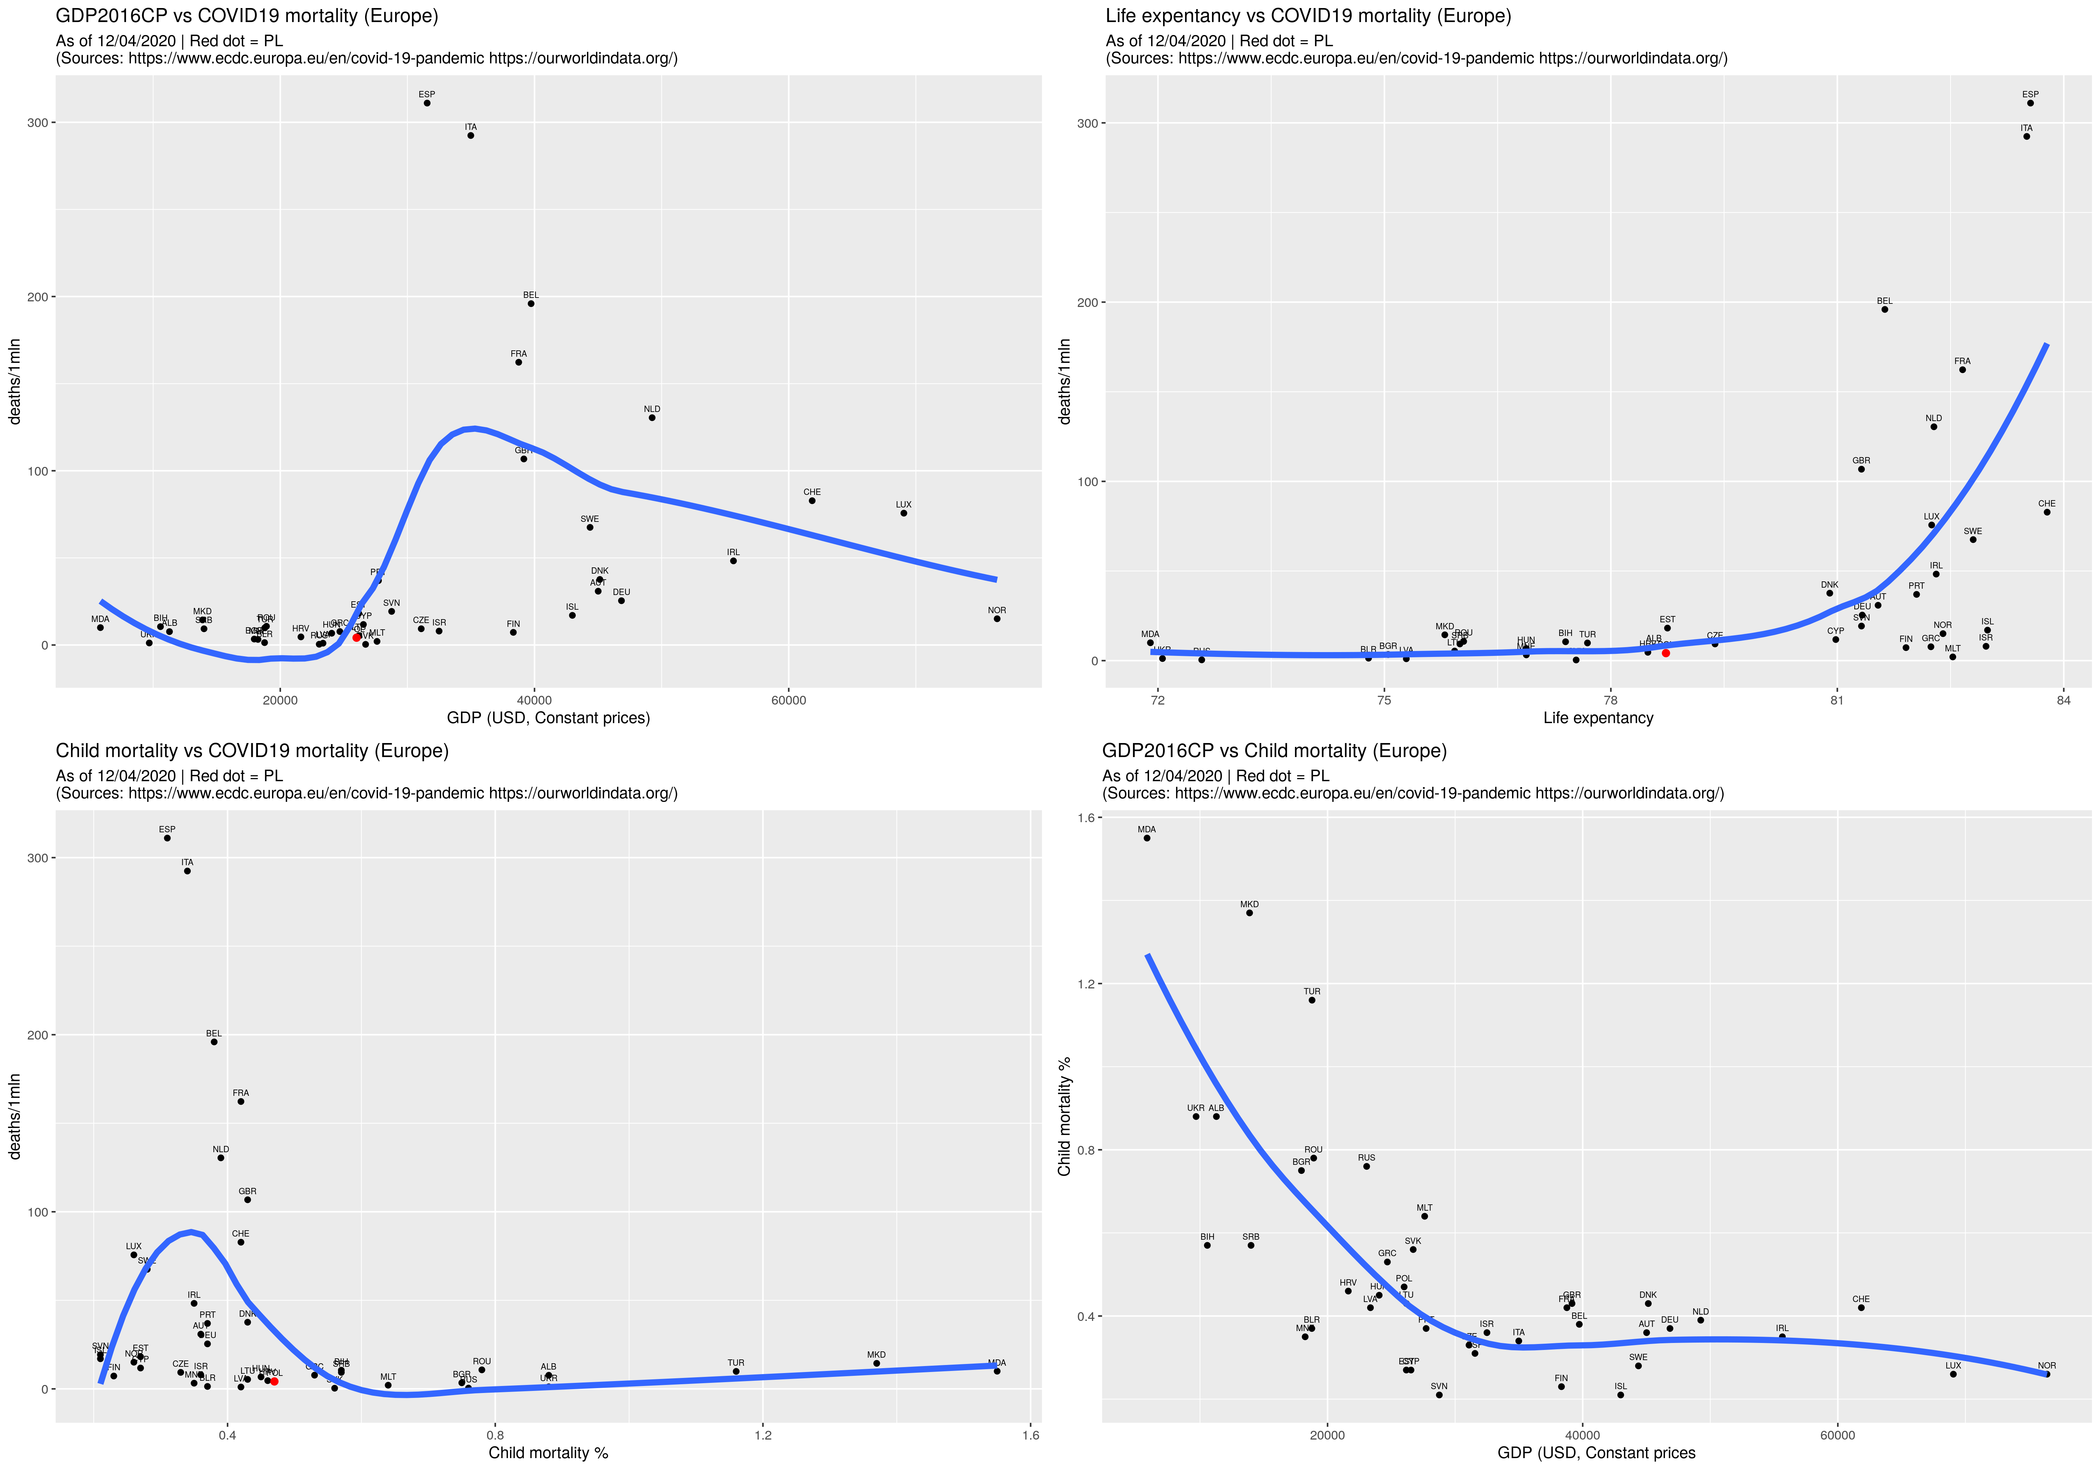
Więcej wykresów nt COVID19

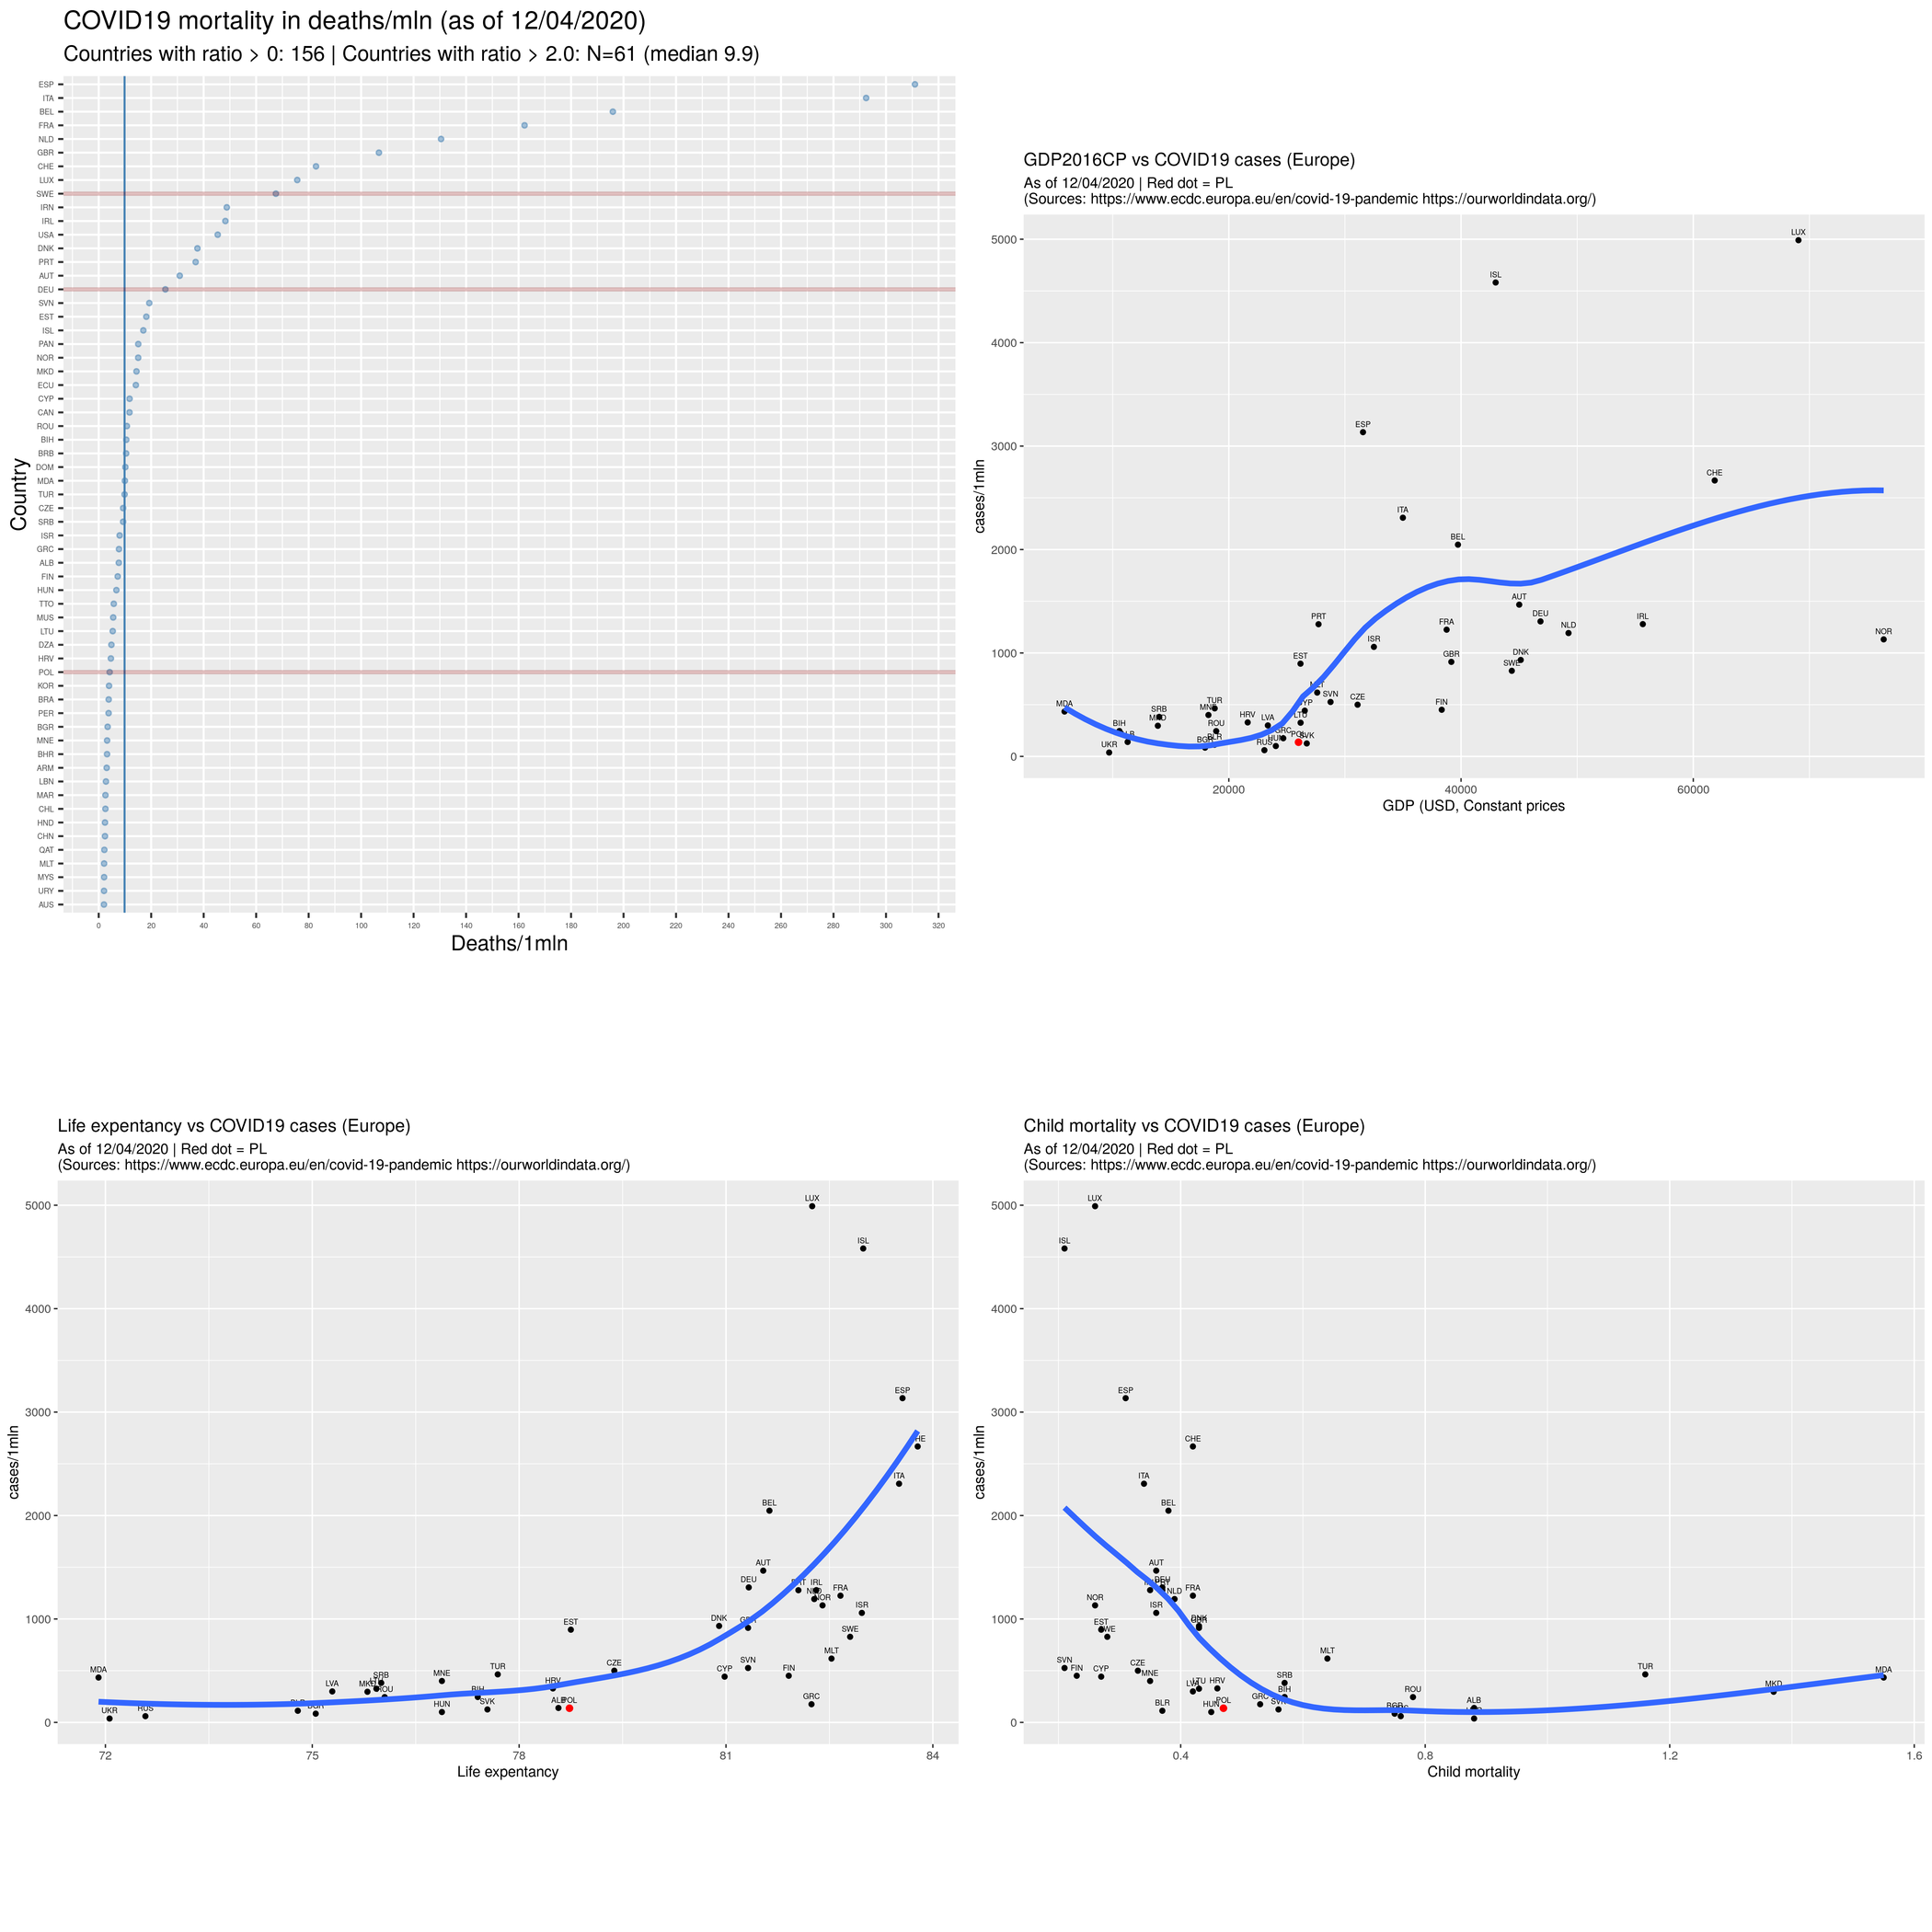
Wymyśliłem sobie wykreślić wykresy pokazujące zależność pomiędzy liczbą zarażonych/zmarłych, a wybranymi wskaźnikami: GDP (zamożność), oczekiwana długość życia (poziom służby zdrowia) oraz śmiertelność dzieci (zamożność/poziom rozwoju). Większość danych pobrałem z portalu OWiD:

  • GDP (https://ourworldindata.org/economic-growth maddison-data-gdp-per-capita-in-2011us.csv)
  • LE (https://ourworldindata.org/life-expectancy life-expectancy.csv)
  • CM (https://ourworldindata.org/child-mortality child-mortality-igme.csv).

Dane dotyczące liczby ludności są z bazy Banku Światowego (https://data.worldbank.org/indicator/sp.pop.totl.) Dane dotyczące zarażonych/zmarłych ze strony ECDC (www.ecdc.europa.eu/en/covid-19/data-collection) Scaliłem wszystko do kupy skryptem Perlowym. NB pojawił się tzw. small problem, bo bazy OWiD oraz WorldBank używają ISO-kodów 3-literowych krajów, a ECDC dwuliterowych (PL vs POL). Trzeba było znaleźć wspólny mianownik. Szczęśliwie Perl ma gotowy moduł. Oprócz tego ECDC stosuje EU-standard w przypadku Grecji (EL zamiast GR) oraz Wielkiej Brytanii (UK/GB).

#!/usr/bin/perl
use Locale::Codes::Country;
...
while (<COVID>) { chomp();
($date, $iso2, $country, $newc, $newd, $totalc, $totald) = split /;/, $_;

   $iso3 = uc ( country_code2code($iso2, 'alpha-2', 'alpha-3'));
}

Rezultat jest zapisywany do pliku o następującej zawartości:

iso3;country;lex2019;gdp2016;cm2017;pop2018;cases;deaths
ABW;Aruba;76.29;NA;NA;105845;77;0
AFG;Afghanistan;64.83;1929;6.79;37172386;423;14
...

Wierszy jest 204, przy czym niektórym krajom brakuje wartości. Ponieważ dotyczy to krajów egzotycznych, zwykle małych, to pominę je (nie teraz później, na etapie przetwarzania R-em). Takich wybrakowanych krajów jest 49 (można grep-em sprawdzić). Jedynym większym w tej grupie jest Syria, ale ona odpada z innych powodów.

Do wizualizacji wykorzystam wykres punktowy (dot-plot) oraz wykresy rozrzutu (dot-plot).

library("dplyr")
library("ggplot2")
library("ggpubr")
## 
options(scipen=1000000)
## https://www.r-bloggers.com/the-notin-operator/
`%notin%` <- Negate(`%in%`)
##
today <- Sys.Date()
tt<- format(today, "%d/%m/%Y")
million <- 1000000
## Lista krajów Europejskich + Izrael
## (pomijamy kraje-liliputy)
ee <- c(
'BEL', 'GRC', 'LTU', 'PRT', 'BGR', 'ESP', 'LUX', 'ROU', 'CZE', 'FRA', 'HUN',
'SVN', 'DNK', 'HRV', 'MLT', 'SVK', 'DEU', 'ITA', 'NLD', 'FIN', 'EST', 'CYP',
'AUT', 'SWE', 'IRL', 'LVA', 'POL', 'ISL', 'NOR', 'LIE', 'CHE', 'MNE', 'MKD',
'ALB', 'SRB', 'TUR', 'BIH', 'BLR', 'MDA', 'UKR', 'ISR', 'RUS', 'GBR' );
ee.ee <- c('POL')

d <- read.csv("indcs.csv", sep = ';',  header=T, na.string="NA");
## Liczba krajów
N1 <- nrow(d)
## liczba ludności w milionach
d$popm <- d$pop / million

## Oblicz współczynniki na 1mln 
d$casesr <- d$cases/d$popm 
d$deathsr <- d$deaths/d$popm 

## Tylko kraje wykazujące zmarłych
d <- d %>% filter(deaths > 0) %>% as.data.frame
## Liczba krajów wykazujących zmarłych
N1d <- nrow(d)

## Tylko kraje z kompletem wskaźników (pomijamy te z brakami)
d <- d[complete.cases(d), ]

nrow(d)

##  UWAGA: pomijamy kraje o wsp. <= 2
##  droplevels() usuwa `nieużywane' czynniki
##  mutate zmienia kolejność na kolejność wg dearhsr:
d9 <- d %>% filter(deathsr > 2 ) %>% droplevels() %>% 
 mutate (iso3 = reorder(iso3, deathsr)) %>% as.data.frame

N1d2 <- nrow(d9)
M1d2 <- median(d9$deathsr, na.rm=T)

## https://stackoverflow.com/questions/11093248/geom-vline-with-character-xintercept
## Wykres punktowy
rys99 <- ggplot(d9, aes(x =iso3, y = deathsr )) +
  geom_point(size=1, colour = 'steelblue', alpha=.5) +
  xlab(label="Country") +
  ylab(label="Deaths/1mln") +
  ggtitle(sprintf("COVID19 mortality in deaths/mln (as of %s)", tt), 
   subtitle=sprintf("Countries with ratio > 0: %i | Countries with ratio > 2.0: N=%i (median %.1f)", 
       N1d, N1d2, M1d2)) +
  theme(axis.text = element_text(size = 4)) +
  ##theme(plot.title = element_text(hjust = 0.5)) +
  scale_y_continuous(breaks=c(0,20,40,60,80,100,120,140,160,180,200,220,240,260,280,300,320,340,360)) +
  geom_hline(yintercept=M1d2, linetype="solid", color = "steelblue") +
  geom_vline(aes(xintercept = which(levels(iso3) == 'POL')), size=1, color="#8A0303", alpha=.25) +
  geom_vline(aes(xintercept = which(levels(iso3) == 'DEU')), size=1, color="#8A0303", alpha=.25) +
  geom_vline(aes(xintercept = which(levels(iso3) == 'SWE')), size=1, color="#8A0303", alpha=.25) +
  coord_flip()

Uwaga: oś OX to skala porządkowa. Czynniki powinny być uporządkowane wg. wartości zmiennej z osi OY, czyli według deathsr. Do tego służy funkcja mutate (iso3 = reorder(iso3, deathsr). Można też uporządkować je ,,w locie'' aes(x =iso3, y = deathsr ), ale wtedy niepoprawnie będą kreślone (za pomocą geom_vline) linie pionowe. Linie pionowe służą do wyróżnienia pewnych krajów. Linia pozioma to linia mediany.

sources <- sprintf ("As of %s\n(Sources: %s %s)", tt,
  "https://www.ecdc.europa.eu/en/covid-19-pandemic",
  "https://ourworldindata.org/")

## Żeby etykiety nie zachodziły na siebie tylko dla wybranych krajów
## Add empty factor level! Istotne inaczej będzie błąd
# https://rpubs.com/Mentors_Ubiqum/Add_Levels
d$iso3 <- factor(d$iso3, levels = c(levels(d$iso3), ""))

d$iso3xgdp <- d$iso3
d$iso3xlex <- d$iso3
d$iso3xcm <- d$iso3

## Kraje o niskich  wartościach bez etykiet
## Bez etykiet jeżeli GDP<=45 tys oraz wskaźnik < 50:
d$iso3xgdp[ (d$gdp2016 < 45000) & (d$deathsr < 50 ) ] <- ""
## Inne podobnie
d$iso3xlex[ ( (d$lex2019 < 80) | (d$deathsr < 50 ) ) ] <- ""
d$iso3xcm[ ((d$cm2017 > 1.2) | (d$deathsr < 50 ) ) ] <- ""

## GDP vs współczynnik zgonów/1mln
rys1 <- ggplot(d, aes(x=gdp2016, y=deathsr)) + 
  geom_point() +
  geom_text(data=d, aes(label=sprintf("%s", iso3xgdp), x=gdp2016, y= deathsr), vjust=-0.9, size=2 ) +
  xlab("GDP (USD, Constant prices)") + 
  ylab("deaths/1mln") + 
  geom_smooth(method="loess", se=F, size=2) +
  ggtitle("GDP2016CP vs COVID19 mortality", subtitle=sources)

## Life ex vs współczynnik zgonów/1mln
rys2 <- ggplot(d, aes(x=lex2019, y=deathsr)) + 
  geom_point() +
  geom_text(data=d, aes(label=sprintf("%s", iso3xlex), x=lex2019, y= deathsr), vjust=-0.9, size=2 ) +
  xlab("Life expentancy") + 
  ylab("deaths/1mln") + 
  geom_smooth(method="loess", se=F, size=2) +
  ggtitle("Life expentancy vs COVID19 mortality", subtitle=sources)

## Child mortality vs współczynnik zgonów/1mln
rys3 <- ggplot(d, aes(x=cm2017, y=deathsr)) + 
  geom_point() +
  geom_text(data=d, aes(label=sprintf("%s", iso3xcm), x=cm2017, y= deathsr), vjust=-0.9, size=2 ) +
  xlab("Child mortality %") +
  ylab("deaths/1mln") + 
  geom_smooth(method="loess", se=F, size=2) +
  ggtitle("Child mortality vs COVID19 mortality", subtitle=sources)

## GDP vs Child mortality 
rys0 <- ggplot(d, aes(x=gdp2016, y=cm2017)) + 
  geom_point() +
  xlab("GDP (USD, Constant prices)") + 
  ylab("Child mortality") +
  geom_smooth(method="loess", se=F, size=2) +
  ggtitle("GDP2016CP vs Child mortality", subtitle=sources)

Jeszcze raz dla krajów Europejskich:

## Tylko kraje Europejskie:
d <- d %>% filter (iso3 %in% ee) %>% as.data.frame

d$iso3xgdp <- d$gdp2016
d$iso3xlex <- d$lex2019
d$iso3xcm <- d$cm2017
d$iso3xgdp[ d$iso3 %notin% ee.ee ] <- NA
d$iso3xlex[ d$iso3 %notin% ee.ee ] <- NA
d$iso3xcm[ d$iso3 %notin% ee.ee ] <- NA

rys1ec <- ggplot(d, aes(x=gdp2016, y=casesr)) + 
  geom_point() +
  geom_text(data=d, aes(label=sprintf("%s", iso3), x=gdp2016, y= casesr), vjust=-0.9, size=2 ) +
  geom_point(data=d, aes(x=iso3xgdp, y= casesr), size=2, color="red" ) +
  xlab("GDP (USD, Constant prices") + 
  ylab("cases/1mln") +
  geom_smooth(method="loess", se=F, size=2) +
  ggtitle("GDP2016CP vs COVID19 cases (Europe)", subtitle=sources)
  ... itd...

Wynik w postaci rysunków:

Powyższe jest dostępne tutaj