Ostatni wyścig z cyklu Skandia Maraton LangTeam będzie w Kwidzynie, w następną niedzielę 4. 10. 2009. Profil trasy i więcej informacji jest tutaj.
piątek, 25 września 2009

piątek, 18 września 2009
Manipulowanie plikami bibtexa
Konwencję sobie przyjąłem, że pole tp:keywords zawiera moje słowa kluczowe. Czemu tak? Ano temu, że moja baza bibtexa zawiera wpisy skopiowane z różnych repozytoriów; wpisy te zawierają pole keywords, tyle że nie ma żadnych reguł odnośnie tego co jest zawartością tego pola. Zawartość pola tp:keywords jest (przynajmniej w założeniu) słownikiem ustalonym (controlled vocabulary) pojęć. Podobnie pole tp:comment zawiera mój, krótki opis zawartości pozycji bibliograficznej. W szczególności pola te pomagają posortować/wyciągnąć pozycje bibliograficzne, relewantne z punktu widzenia określonej dziedziny zastosowań. Używam do tego narzędzia bibtool:
bibtool -- 'select {tp:keywords "OSS" }' tph.bib
Powyższe oznacza: wypisz wszystkie rekordy z pliku tph.bib, które zawierają napis OSS w polu tp:keywords. Napis "OSS" jest traktowany jako wyrażenie regularne (regex 0.12):
bibtool -- 'select {tp:keywords "OSS\|UTAUT" }' tph.bib
Powyższe oznacza: wypisz wszystkie rekordy z pliku tph.bib, które zawierają napis OSS lub napis UTAUT w polu tp:keywords. Wyrażenie regularne może zawierać inne metaznaki: ., +, *, itd. Jest znak sumy (a lub b) ale nie ma iloczynu (a i b). Jeżeli chcemy wyciągnąć rekordy zawierająca łącznie pewne napisy, to można wykorzystać mechanizm potoku:
bibtool -- 'select {tp:keywords "#Prio" }' tph.bib |\
   bibtool -- 'select {tp:keywords "OSS" }' | \
   bibtool -- 'select {tp:keywords "SEM" }'
Powyższe oznacza: wypisz wszystkie rekordy z pliku tph.bib, które zawierają napisy OSS, SEM oraz #Prio (w dowolnym porządku) w polu tp:keywords. Słowo kluczowe #Prio to moja konwencja na oznaczenie ważnych wpisów. Innymi słowy powyższe oznacza: wypisz ważne pozycje literatury dotyczące (łącznie) OSS i SEM.
Do zamiany plików bibtexa na xhtml używam narzędzia bib2xhtml. Ten pakiet jest niestandardowy -- z tego co pamiętam -- trzeba go ściągnąć i zainstalować samodzielnie...
Moja baza bibtexa zawiera kilkaset wpisów, dotyczących różnych dziedzin i o różnym stopniu ważności (od merytorycznie istotnych do słabych; słabe też trzeba gromadzić--np. jako przykłady). Stąd powyższe pomysły, żeby trochę nad tym wszystkim zapanować...
Modyfikując bib2xhtml, który jest programem napisanym w Perlu, zmarnowałem trochę czasu usiłując dodać konwersję (brakujących) polskich znaków diakrytycznych. Otóż bib2xhtml zakłada iż plik jest kodowany w notacji LaTeXa (7 bitowe ASCII), przy czym nie są zaimplementowane znaki zawierające ogonek. Proste wpisanie:
s/\\k\{a\}/ą/g;
Nie chciało zadziałać. Po bliższym obejrzeniu skryptu się okazało, że każdy wiersz pliku jest wstępnie zamieniany poprzez wykonanie następującego polecenia:
  ## fragment jest wykonywany wew. pętli, `iterującej' po wszystkich wierszach pliku:
   {  local ($c, $l, $z) = (0, 0, ());
   s/([\{\}])/join("","\001",($1 eq "\{" ? $z[$l++]=$c++ : $z[--$l]),$1)/ge;
   ## ge oznacza, globalnie+extended mode, dzięki czemu powyższe ma charakter pętli
   ## wykonywanej dla każdego znaku { oraz }
   }
W rezultacie każda sekwencja {...} zostanie zamieniona na \nnn{...\nnn}, gdzie \nnn jest znakiem o kodzie nnn. Przykładowo jeżeli wiersz zawiera:
{abc} {def} {ghi} jkl... => \001{abc\001} \002{def\002} \003{ghi\003} jkl...
Dzięki czemu każda para { ... } jest teraz jednoznacznie identyfikowana. Dokładnie nie wiem po co jest taka sztuczka robiona. Ale teraz zamiana przykładowo \k{a}, tj.~polskiego ą w notacji LaTeXa, wymaga zapisu:
s/\\k(\001\d+)\{a\1\}/ą/g;
piątek, 11 września 2009
Dyskretyzacja w R
Jeżeli plik data1.dat zawiera liczby rzeczywiste, to poniższy skrypt wykona następujacą transformację:
# zamień macierz liczb rzeczywistych z pliku data1.dat na
# odpowiednie wartości na skali porządkowej...
categories <- 5;
df <- read.table("data1.dat", header=T);
dl <- lapply(df, function(x){ cut(x, breaks=categories, labels=FALSE)} );
write.table(data.frame(dl), "data1.txt", sep="\t", na="", row.names=F)
Dla każdej kolumny wyznaczy categories przedziałów o jednakowej szerokości, przyporządkuje każdą liczbę do określonego przedziału, przypisze tej liczbie numer tego przedziału. Polecenie write.table wypisze wyznaczone numery do pliku data1.txt.
niedziela, 6 września 2009
Wycieczka rowerowe do diabelskiego kamienia

Jedna z atrakcji doliny Radości w Gdańsku. Dojście/dojazd jest bardzo prosty -- asfaltem w górę aż do stawów rybnych, tutaj jest parking i szlaban. Za szlabanem to już blisko -- jedziemy dalej, a w momencie kiedy alfalt skręca w lewo (na zakręcie, po lewej znajdują się zabudowania leśniczówki), zjeżdżamy/schodzimy z asfaltu i dalej kawałek prosto. Po jakiś 50--100 metrach w prawo (a nie dalej prosto). Tą drogą lekko pod górę jakieś 500 metrów i dojeżdżamy/dochodzimy do kamienia, który znajduje się na wzgórzu, przy drodze. Dodatkowo jest tabliczka, więc trudno to miejsce przeoczyć... Trzeba podejść jakieś 100 metrów po zboczu. Współrzędne kamienia to 54.392956/18.510197. Wygląda zaś jak na rysunku obok.
Po obejrzeniu kamienia wróciliśmy na drogę asfaltową i pojechaliśmy dalej w górę... Ta droga prowadzi do ul. Słowackiego; można też nią dojechać do Matemblewa. My dojechaliśmy tylko do skrzyżowania (ca miejsca o współrzędnych 54.385589/18.532811) z drogą, którą można wrócić z powrotem do Oliwy. Droga jest praktycznie równoległa do alfaltowej którą przyjechaliśmy, tyle że w lesie. No i ciągle w dół, bo do tego miejsca było głównie pod górę... Wyjeżdżamy jakieś 500 metrów, przed Kuźnią Wodną, który to budynek znajduje się jak wiadomo na początku Doliny Radości.
Trasa w postaci śladu GPS jest tutaj. Albo w wersji kml (Googleearth). GPSowi ,,puściły zawory'' w okolicach zdjęcia dscf7124 (ca miejsca o współrzędnych 54.397747/18.545939). Odtąd trasa zupełnie odbiega od tej, którą jechaliśmy, aż do Spacerowej, na której urządzanie złapało z nowu poprawne namiary. Dodatkowo GPS pogubił na samym końcu, jak pojechałem -- już sam -- w okolice jez. Nowowiejskiego w Sopocie zrobić zdjęcia sromotnikom, których cała kolonia idąca w co najmniej kilkadziesiąt owocników właśnie tam się znajduje.
piątek, 28 sierpnia 2009
Nowy laptop: Dell Vostro 1320


Kupiłem nowego laptopa decydując się ostatecznie na Dell Vostro 1320, który bez systemu kosztował 2800 PLN. Matryca 13,3 cala, procesor Intel Core 2 Duo T6570, 4 Gb pamięci (z czego system widzi 3 Gb) Niestety od razy skucha -- komputer reklamowany jako ważący 1,9kg po zważeniu okazał się być cięższym -- 2,2 kg. Zresztą taka waga jest w papierach od Della, więc sprzedający zwyczajnie oszukują. Akurat zależało mi na czymś lżejszym więc jestem trochę zły...
Poza tym w porównaniu do poprzedniego HP NX9020 wiatrak się włącza często i komputer hałasuje ale to chyba jest nieuchronne biorąc pod uwagę że w środku jest całkiem szybki procesor. Zresztą nie szumi głośno, raczej byłem do tej pory przyzwyczajony, że nic nie szumi wcale.
Podzieliłem dysk na dwa kawałki ca 180 Gb + ca 50 Gb -- jeden na Fedorę, który używam na co dzień drugi na Ubuntu żeby się z Ubuntu oswoić. Fedora 11/Ubuntu zainstalowały się bez większych problemów nie licząc WiFi (w obu nie działa). Na tym froncie totalna porażka. Komputer ma kartę Broadcom 4312 i sądząc z tego co jest dostępne via google powinna działać, a nie działa... Nie używałem tego komputera za dużo do tej pory, ale dwie rzeczy już mi podpadły w Fedorze 11: -- Thunderbird w wersji 3 beta ileś tam (najnowszy), do którego nie działa wykorzystywany przeze mnie plugin synckolab; -- Googleearth w wersji 5, zawiesza komputer raz na kilka uruchomień i znika mapa w dużych zbliżeniach. Wersja GE 4.3 wydaje się działać poprawnie... Z plusów jest Emacs 23, tyle że bez ładnego i domyślnego ekranu startowego -- komu to przeszkadzało?
Stary NX 9020 dziś oddałem Miśkowi...
Dopisane 31 sierpnia 2009: Jest kilka teorii jak uruchomić WiFi, zacząłem od Broadcom wireless on Fedora 11 again. Jest pewien progress, bo się dioda Wireless świeci, ale tak poza tym to nie działa. Do tego nie podoba mi się to dłubanie w jądrze, bo tę kwestię winien załatwić pakiet bez potrzeby uruchamiania insmod czy czegoś podobnego. W innym poradniku z kolei Configuring Broadcom BCM4312 Wireless card in Fedora 10, gość twierdzi jakoby wystarczy samo yum install broadcom-wl. Odkręciłem to co sugerował gość z wpisu Broadcom wireless... ale to nic nie dało.
Dwa dni temu wszakże zaktualizowałem system, przy czym wydaje się kluczowa była aktualizacja paczki kmod-wl. Teraz jest prawie dobrze, tzn. NetworkManager nie działa ale mogę uruchomić połączenie ,,z palca'', w następujący sposób:
ifconfig eth1 up
wlist eth1 scan
iwconfig eth1 essid ESSID
dhclient eth1
Albo po prostu:
system-config-network
odhaczam zarządzanie siecią WiFi przez NetworkManagera, który i tak nie działa i Klikam w aktywuj. Firefox jest ,,na dzień dobry'' w trybie offline więc trzeba wykonać jeszcze jeden klik żeby działał...
Zatem NetworkManager ma problem. Zapewne jest to problem opisany m.in. tutaj.
Dopisane 4 października 2009: W tzw. międzyczasie zainstalowałem F10 w wersji 64 bitowej, ale to nie był dobry pomysł. Ostatecznie z powrotem jest F11. Thunderbird w wersji z F10 (działa i nie ma żadnych komunikatów o naruszeniu zależności). WiFi wreszcie uruchomiłem -- wystarczyło dodać do /etc/modprobe.d/blacklist.conf wpis:
blacklist dell_laptop
Zaczęło też działać googleearth w wersji 5. Jedyny większy problem jaki pozostał to ciut za niski poziom dźwięku.
Dopisane 21 listopada 2009: Bateria trzyma około 3 godzin 15 minut (uruchomiony xine -- wyświetlanie filmu).
Wypadek w Oliwie

Jechałem sobie dziś rowerem Czyżewskiego. Od połowy był korek ale primo to normalne bo skrzyżowanie Opacka/Spacerowa jest mało przepustowe, secundo na rowerze pomykam środkiem i korki mnie nie ruszają. Koniec Czyżewskiego i się okazało, że korek spowodowało zawalone drzewo w okolicach skrzyżowania Czyżewskiego/Opacka. Przelazłem przez gałęzie -- drzewo leżało od kraja do kraja blokując oba pasy i oba chodniki. Na prawym pasie była jedna gablota na zicher dociśnięta gałęziami, na lewym druga... Ten z tej drugiej chyba wjechał w gałęzie już po, ale zwątpił czy przejedzie i już tak został w gałęziach. Ja się przedarłem lewym chodnikiem i pojechałem dalej...
Mam nadzieję, że temu z prawego pasa też nic się poważnego nie stało (mam na myśli ludzi w środku). Anyway w mieście Budynia nawet w bezwietrzny dzień drzewa się przewracają.... Strach i przerażenie, co to będzie dalej:-)
czwartek, 20 sierpnia 2009
Dziadowski uchwyt do roweru
Lubię uchwyty, w których rower jest mocowany za widelec (po zdjęciu przedniego koła). Tak transportowany rower jest zamocowany ,,na mur''--nic się nie kiwa. 100% pewności, że nie spadnie więc Elka ma mniej stresów. Wadą jest koło w bagażniku....
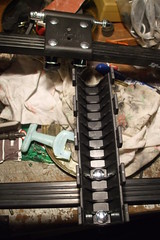
Opisywany uchwyt
Ponieważ w sklepie z bagażnikami nie mieli kupiłem przez internet. Konkretnie model pn. ,,Tour Professional -- uchwyt/bagażnik''. Fatalny i nie polecam (foto jak wygląda to cudo obok). Gdybym chwilę pomyślał to bym doszedł do wniosku, że sam pomysł tego uchwytu jest chybiony. Mianowicie zasada wykorzystania uchwytu tego typu jest taka, że rower jest mocowany za widelec oraz za tylne koło. ,,Normalny'' bagażnik wygląda w ten sposób, że składa się z szyny, z przodu której jest uchwyt na widelec. Z tyłu szyny jest z kolei rynienka, na której opiera się tylne koło (unieruchamiane paskiem). Rynienka jest regulowana -- może się ruszać w przód i w tył -- co pozwala dopasować odległość do długości roweru. Szyna jest mocowana na belkach bagażnika.
W tym konkretnym dziadowskim modelu, jakiś mundry zrezygnował z szyny. Uchwyt składa się z dwóch kawałków. Regulacja wymaga dopasowania odległości pomiędzy poprzecznymi belkami bagażnika -- przekichane. A jak rowery są dwa i różnią się wielkością? Ewidentnie ktoś nie pomyślał (oprócz mnie przed zakupem).
Po drugie, całość składa się z zyliona podkładek, blaszek, pokręteł, etc... Nie idzie tego skręcić tak, żeby rower nie kiwał się jak w pierwszym lepszym badziewnym uchwycie ,,za ramę''. Reasumując: stanowczo odradzam kupno. Lepiej wydać więcej i kupić normalny.
sobota, 15 sierpnia 2009
Patent #5787449, Word, Microsoft, i4i i XML
Smród pewien powstał wokół tzw. Giganta z Redmond a zwłaszcza jego sztandarowego produktu pn. Word. W skrócie ogromnym -- podobno -- sędzia Leonard Davis (Tyler/Texas) zakazał od 12. października 2009 sprzedaży ww. Worda, co jest efektem naruszenia patentu #5787449 firmy i4i.
Ustalić cóż takiego konkretnie wymyśliła ta firma i4i nie jest proste. Wniosek patentowy jest dość abstrakcyjny, no i na dokładkę trzeba wiedzieć co zaimplementowano w Wordzie, żeby ustalić na ile pozew i4i jest uzasadniony -- przynajmniej w aspekcie prawnym. Poszukując szczegółów via Google rozpocząłem od tekstu konsekwencje pozwu patentowego trolla, w którym twierdzi się, że patent sprowadza się do ,,możliwości definiowania danych w składni Schematu XML, a następnie wykorzystywania tych danych w dokumentach Office''. Dalej autor ocenia, że ,,trudno o coś równie ogólnego i trywialnego, a patent taki nigdy nie powinien zostać przyznany''.
Na moje wszak oko to nie jest podstawa pozwu i4i -- szczegóły wkrótce.
Dopisane 16 sierpnia 2009: przejrzałem patent i poniżej zamieszczam kluczowe fragmenty z komentarzem.
It is an object of the present invention to provide an improved method of encoding a document. [...] in sharp contrast to the prior art the present invention is based on the practice of separating encoding conventions from the content of a document [...] The invention does not use embedded metacoding to differentiate the content of the document, but rather, the metacodes of the document are separated from the content and held in distinct storage in a structure called a metacode map, whereas document content is held in a mapped content area.
Ostatnie zdanie wydaje się dotyczyć istoty patentu. Nie jest to wcale ,,możliwości definiowania danych w składni Schematu XML''. Bzdura. Chodzi o przetwarzanie dokumentu XML (i nie tylko XML -- przypuszczam, że każdego dokumentu elektronicznego przetwarzanego w sposób opisany we zastrzeżeniach wniosku patentowego) w taki sposób, że treść i formatowanie są zapisywane w oddzielnych miejscach (held in distinct storage). Jak to ma działać jest objaśnione dalej:
A metacode map is a multiplicity of metacodes and their addresses associated with mapped content. An address is the place in the content at which the metacode is to exert its effect.
Łopatologicznie można to przedstawić na przykładzie poniżej. Po lewej stronie dokument XML/SGML a po prawej ten sam dokument bez znaczników (nazwanych metacodes we wniosku patentowym) -- są one przechowywane w innym pliku/miejscu i wstawiane wtedy kiedy jest to potrzebne.
<p>Pod źdźbłem <strong>spał</strong>     Pod źdźbłem spał żółw śnięty
żółw śnięty </p>
BTW w ten sposób dokument może być oznakowany za pomocą różnych systemów znaczników (przynajmniej teoretycznie, bo w praktyce jakoś trudno mi wyobrazić redagowanie takiego dokumentu), podczas gdy w ,,klasycznym'' XMLu treść+oznakowanie stanowi jak wiemy monolit.
Nie chce mi się dalej czytać, ale całe to invention sprowadza się zatem do ,,sprytnego'' redagowania dokumentów (w tym dokumentów XML/SGML), w którym znacznik nie jest wstawiany bezpośrednio do treści dokumentu ale jest umieszczany osobno wraz ze wskaźnikiem gdzie ma być wstawiony (the patent describes separating markup from the content stream by means of an map indexing the content).
Reasumując: 1) rzecz cała sprowadza się w dużym stopniu do interfejsu; 2) widocznie Word korzysta z takiego rozwiązania; 3) patent jest dobitnym przykładem czegoś co należało do stanu techniki (aka prior art) i jako takie nie powinno w ogóle być patentowalne, bo cóż jest bardziej trywialnego niż zbiór wskaźników do czegokolwiek.
PS: sugestie głoszone przez ignorantów na różnych forach jakoby W3C albo Apache Fundation są zagrożone patentem i4i nie są prawdziwe, bo patent dotyczy tylko pewnego sposobu manipulowania dokumentem strukturalnym a nie XMLa/SGMLa jako takiego.
Ciekawa wizualizacja danych na BBC Sport
Na stronie BBC intrygująca mapa. Robi wrażenie--przynajmniej na mnie (geokodowanie, integracja danych, wizualizacja).
poniedziałek, 10 sierpnia 2009
wtorek, 28 lipca 2009
Najbardziej oblegane zdjecie na flickr.com
Moje najbardziej oblegane zdjęcie na flickr.com. niedługo będzie miało jubileusz 2000 oglądnięć (przeciętna dla całego mojego zbioru to ok. 10 odsłon). Ponad 50 użytkowników zaznaczyło je jako ulubione. Tylko hmm... upodobania tych użytkowników takie trochę...
Subskrybuj:
Posty (Atom)