wtorek, 20 marca 2018

MS SQL, Perl i DBI

Kolega L. mi zadanie zlecił, w którym wykorzystywaną bazą musi być MS SQL. Podchodziłem do tego jak do jeża, ale wreszcie się przełamałem, usiadłem i działa (aż dziwne). W skład zadania wchodzi też baza danych pn. GraphiPlus, która zawiera m.in. tabele o nazwach dbo.FACTURES oraz dbo.SOCIETES:

#!/usr/bin/perl
use strict;
use utf8;
use DBI; 
require DBD::ODBC;
my $serverN = 'E5410-KOMPUTER\\SQLEXPRESS';
my $baseN = 'GraphiPlus';
my $dsN = "GraphiPlus";
## Obie formy działają (pierwsza przez DSN = Data Source Name/Źródło danych)
## Definiowanie DSN: Panel_Sterowania→Wszystkie_Elementy→
##    Narzędzia_Administracyjne→Źródła_danych_(ODBC)
# my $dbh = DBI->connect("dbi:$dsN", '<UID>', '<PASSWD>',
#   { RaiseError => 1 } ) or die DBI->errstr;
# Albo
my $dbh = DBI->connect("dbi:ODBC:driver={SQL Server};Server=$serverN;database=$baseN;uid=<UID>;pwd=<PASSWD;",
   {RaiseError => 1, } ) or die DBI->errstr;

print "*** Połączono z $baseN ***\n";

## małe litery do.TABELA są istotne!
my $sth = $dbh->prepare("SELECT * FROM dbo.FACTURES ") || die "ERROR" . $dbh->errstr ;  
$sth ->execute();

print "**** Tabela FACTURES:\n";
while ( my @invoiceRecord = $sth->fetchrow_array() ) {
   print (join(";", @invoiceRecord) . "\n");
}

## musi być (w mySQL niekoniecznie)
$sth->finish();

print "**** Tabela SOCIETESS:\n";
my $sth = $dbh->prepare("SELECT * FROM dbo.SOCIETES ") || die "ERROR" . $dbh->errstr ;  
$sth ->execute();

while ( my @invoiceRecord = $sth->fetchrow_array() ) {
   print (join(";", @invoiceRecord) . "\n");
}

$sth->finish();

$dbh->disconnect();

###

Gdybym nie znał nazw tabel to można je ustalić albo za pomocą SQL Server Management Studio, albo wykonując polecenie SELECT na systemowej tabeli pn. sys.tables:

my $sts = $dbh->prepare("SELECT name FROM sys.tables ") || die "ERROR" . $dbh->errstr ;

poniedziałek, 19 marca 2018

Jak zacząłem pracę z TeXem

Przypadek wielokrotny zadecydował.

Studia skończyłem w roku 1987r. W tym czasie po studiach szło się do wojska na 1 rok. Mając do wyboru pobór we wrześniu 1987 albo w styczniu 1988 albo w maju 1988 zdecydowałem się na maj. Kombinowałem oczywiście żeby nie iść, ale słabo i się nie wykręciłem. Tym bardziej że tuż przed końcem PRLu przykręcono śrubę na odcinku obronności i brano bez litości wszystkich, nawet tych z kategorią C i papierami o depresji czy dyskopatii (z tymi to był kabaret zresztą na przykład na strzelnicę taki dyskopatyk jechał a nie szedł -- ciężarów nie mógł przecież dźwigać, a karabin jest ciężki). Wracając do TeXa -- wygrałem los po raz pierwszy: bym poszedł w styczniu/wrześniu (lub wcale) nie poznałbym TeXa (raczej)...

Wróciłem do pracy na Uniwersytecie w maju 1989 (dla przypomnienia w czerwcu 1989 był okrągły stół). Kompletna zmiana sytuacji, jeszcze w sierpniu 1988 jak rozpoczął się strajk w Stoczni (22 sierpnia), a ja udawałem Marine (aka niebieskiego bereta) w czymś co się nazywało 7 Pomorska Brygada Obrony Wybrzeża (35 pułk desantowy, Gdańsk-Wrzeszcz, ul. Słowackiego -- teraz osiedle Garnizon), to ktoś wpadł na pomysł wysyłania patroli wojskowych na miasto z bronią, ale bez amunicji, w składzie żołnierze służby zasadniczej + dowódca podchorąży (czyli m.in. ja). Oficer dyżurny: Tylko k#rwa podchorąży pamiętajcie, jak tylko coś się zacznie, to wy od razu macie spierdalać z powrotem do koszar... Wychodzi na to, że los po raz drugi się uśmiechnął, że to poszło w tą stronę co poszło, bo były obawy, że my w tym 35 pułku (desantowym) posiedzimy dłużej.

Jakoś tak po roku, czyli w 1990, ktoś mi powiedział, że dla pracowników Uniwersytetu organizuje kursy języka angielskiego firmowane przez British Council. No to się zapisałem.

Kursy to (dla wygody kursantów?) były tak organizowane, że grupy tworzono ,,według wydziałów'', tj. zapisywano wszystkich z wydziału do jednej grupy. Oczywiście ktoś tam zawsze był nadmiarowy. Ja trafiłem do grupy ,,nadmiarowej''. Wygrałem los po raz trzeci -- bym trafił do grupy ,,wydziałowej'', to bym się kisił w starym sosie, w towarzystwie znanym z wydziału (dlatego ten system tworzenia grup był moim zdaniem mało sensowny). Nb wygrałem też tam inny los: poznałem przyszłą małżonkę (z Akademii Muzycznej)

Oprócz małżonki poznałem też Tomasz Janowskiego (dalej TJ) z wydziału Mat-Fiz. Ja pracowałem w katedrze statystyki (tyle, że nie na matematyce tylko na zarządzaniu) a wspólnym problemem był skład wzorów matematycznych, do czego używało się wtedy edytora pn. Chi-Writer. Nie tylko Chi-Writera miał polskie znaczki, ale ktoś dorobił także w miarę obszerny zestaw symboli matematycznych. Wzory się tworzyło za pomocą prymitywnego bo prymitywnego ale edytora równań byśmy to dziś nazwali. Wynik niewiele się różnił od tego co dawała maszyna do pisania, tyle że przynajmniej nie trzeba było używać długopisu do dopisywania. A znasz taki program TeX? -- pyta TJ Pierwsze słyszę -- odpowiadam. Ten TeX to ma czcionki jak z drukarni (to było wtedy ważne) -- zareklamował go TJ.

Potem się okazało, że TJ poznał TeXa od Włodka Bzyla. Ale to było potem. Na razie dał mi TeXbooka, którego skserowałem. Szybko się okazało, że coś jest z tym TeXem nie-halo. Jak w nim składać polskie teksty? TJ -- no z tym jest problem, my tu używamy ogonek.sty (czy jakoś tak--zestaw makr doklejających grecką jotę pod `a' i `e'). Gdzieś w tych okolicach czasowych dowiedziałem się też co to jest LaTeX oraz zdobyłem kopię podręcznika Lamporta.

Jakiego pierwszego TeXa dostałem od TJ to już nie pamiętam. Była to o tyle niekompletna dystrybucja, że nie miała MetaFonta. Tylko TeX, program do drukowania/oglądania na ekranie i zestaw fontów na jakąś tam typową drukarkę. Używałem go dość krótko, bo szybko zmieniłem na emTeXa. EmTeX był o tyle lepszy, że był kompletny, -- miał MetaFonta. Można było w szczególności generować fonty bitmapowe na różne rozdzielczości, a nie tylko drukować tym co się dostało `z fabryki'. To wszystko działało na komputerze PC-AT (w pracy, swojego PC-TA jeszcze się nie dorobiłem) wyposażonym w DOSa w wersji 3.3 zapewne. To że w ogóle na wydziale był taki nowoczesny komputer było nawiasem mówiąc w dużym stopniu zasługą dr. Mirosława Gronickiego (późniejszego ministra finansów) a wtedy (i pewnie później) entuzjastę nowych rozwiązań, tak to nazwijmy. Z tego co mi się wydaje 3 komputery w katedrze statystyki z PC-AT na czele, to była cała flota PC-towa na wydziale (nie licząc czegoś tam co mieli w (,,specjalistycznej'') katedrze OPD (Organizacji Przetwarzania Danych jakby ktoś się pytał-- później przemianowanej na Katedrę Informatyki Ekonomicznej).) Inni liczyli na kalkulatorach albo w ostateczności korzystali z wątpliwej jakości usług Ośrodka Obliczeniowego (Odra coś-tam-coś tam). Oczywiście uruchomienie TeXa na nie swojej Odrze nie wchodziło w grę.

W tym czasie w prasie pojawiały się ogłoszenia firmy pn Polski TeX spółka z o.o. sprzedającej polskiego TeXa pn. MeX/LaMeX (polski LaTeX) za dość znaczną kwotę. Ten TeX miał mieć dobrej jakości polskie znaki. Kwota było jednak na tyle znacząca, że na kupno się nie zdecydowałem, ale też nie skopiowałem go nielegalnie (naprawdę). TJ przyznał się, że w instytucie matematyki mają licencjonowaną kopię tego `komercyjnego' TeXa. Doczytałem w TeXbooku o MetaFoncie, więc skserowałem MFbooka od TJ. Dorobiłem kulfoniaste ogonki sam, a nawet w ramach samorozwoju znaki do diagramów szachowych.

W końcu, jak już coś tam wiedziałem, no i miałem te diagramy, a dzięki temu nadzieję, że nie wyjdę na naciągacza-żebraka co to przyszedł dupę zawracać, to się odważyłem i poszedłem rozpoznawczo do tego Polskiego TeXa z o.o (Sopot, 3 Maja ileś tam -- w biurze Polskich Młynów, teraz są tam apartamenty). W firmie siedział Piotr Pianowski. Pogadaliśmy. Ja się pochwaliłem diagramami--Piotr wyraził zainteresowanie. Powiedział, że dałby mi tego TeXa, ale wkrótce go upublicznią więc radzi żebym się wstrzymał z bólami parę dni/tygodni. Potem przyszedł jeszcze Staszek Wawrykiewicz. Bogusława Jackowskiego -- chyba wtedy w firmie nie było. Poznałem go później...

Wizyta w Polskim TeXu musiała być jakoś tak jesienią 1991. Następnego roku w czerwcu odbyło się walne zebranie GUSTu w Warszawie, na które pojechałem. Nikogo tam prawie nie znałem i niewiele z tego zebrania pamiętam, oprócz tego że pierwszy i jedyny raz zobaczyłem Romana Tomaszewskiego (reklamowanego m.in. jako konsultant ds diakrytyków w projekcie Polski TeX/MeX). TeX mnie wciągnął, w roku 1993 pojechałem do Bachotka na pierwszą konferencję GUSTu, a już rok później z kolegą Bzylem współorganizowaliśmy konferencję Europejską w Gdańsku, a konkretnie na wyspie Sobieszewskiej. Ponieważ konferencja była za miastem tośmy wymyślili, że oznaczymy drogę do ośrodka Orle (istnieje do dziś) za pomocą kilku porządnie namalowanych na desce drogowskazów. I tu wpadka, bo się okazało że drogowskaz jest albo w prawo albo w lewo, a myśmy o tym nie pomyśleli. Nasze były tylko w prawo, więc wszystkie próby powieszenia go tak aby wskazywał skręt w lewo okazały się daremne. Ostatecznie powiesiliśmy go do góry nogami, żeby chociaż strzałka wskazywała prawidłowy kierunek. Expirience is the best teacher -- ten incydent pamiętam od dziś!

Nowy router

Wpis pro memoria, bo ruter (kultowy) WRT54GL, który został kupiony w listopadzie 2007r (za 215 PLN) się popsuł. Działała bezawaryjnie aż do zeszłego piątku (tj. 9 marca 2018). Dziesięć lat.

Więc router się popsuł w piątek późnym wieczorem (o czym nie wiedziałem, bo poszedłem wcześnie spać) a w sobotę od rana walka z Internetem, którego nie było. Oczywiście podejrzenia dlaczego nie ma obracały się wokół dostawcy to znaczy wokół UPC. Kilka resetów modemu nic nie dało, do tego objawy były mocno dziwne. Ping z PCta 100% loss, ping z routera 0% loss. Ping na router 0% loss. Coś mi nie pasuje (cache? ale kto catchuje pinga? tyle, że ja się nie znam na tym za bardzo/prawie wcale)

Dzwonię do pomocy technicznej 3x813 (potem 1 -- klient, 2 -- zgłoszenie awarii, 2 -- internet, 9 -- konsultant).

Pani inżynier z poziomu #2 wsparcia (poziom #1 mnie połączył po usłyszeniu historii o pingach) chce mi wcisnąć ConnectBoksa z montażem w poniedziałek, bo pan ma taki stary modem i dlatego nie działa. -- To państwo zmieniają parametry sieci z piątku na sobotę? Pani inżynier się rozłącza abruptly. Poza tym nie chcę tego ConnectBoksa, bo to urządzenie bardziej prymitywne niż modem + dedykowany router. Oczywiście tańsze, bo router już w zestawie, a ja musiałem sobie router dokupić -- no ale jak kupiłem, to jakby mi zwisa ta konkretna/jedyna zaleta. Niefajnie jest, że oni mogą manipulować tym ConnectBoxem zdalnie a modemem jakby nie w szczególności.

Ten 1-szy telefon do UPC zżera mi wszystkie pieniądze z karty prepaidowej. Teraz nie mam ani Internetu ani telefonu. Do tego dzwonią z roboty czemu mnie nie ma? Kurcze pokićkało mi się -- miałem mieć zajęcia. Na szczęście nie robią wielkich problemów, ale stress większy...

Robię reset routera. Teraz przynajmniej zawsze ping nie łączy tj. 100% loss... Coś się klaruje, wygląda na modem

Jadę na miasto do 2 różnych serwisów na konsultacje -- oba closed (sobota).

Wracam (rowerem) a pod bramą mijam o milimetry otwierane bez upewnienia się drzwi taksówki -- sąsiadka. No punkt dla mnie--tym razem nie zaliczyłem drzwi, zagajam o Internet. Dobra moja -- w tej sytuacji (że przed chwilą mnie nie trzepła drzwiami) pani będzie trudno odmówić a jest zaa ściany. Daje swoje hasło... No to już coś. Mogę działać z jej ConnectBoxem.

Doładowuję telefon (Nju). Dzwonię 2x do UPC. Teraz jakby ich wina. (Inny) Facet mówi, że wyśle technika jeszcze dziś. OK, umawiamy się na 18:00. Problem solved.

Coś mnie jednak tknęło. Robię reset jeszcze raz. Router przestał się świecić. Popsuł się na amen. Szukam godzinę drugiego--jest wprawdzie inny niż ten którego szukałem ale jak ktoś jest 200% bałaganiarzem to i tak się cieszy:-) Zresztą to jest dobry router -- Asus RT-N66U aka #MrocznyRycerz (lubię takie nazwy -- Dark Night w oryginale, kupiony na OLX jakiś czas temu)

Działa.

Kolejne 2x telefony do UPC żeby odwołać technika (50 pln za nieuzasadnione wezwanie--niby nie majątek, ale nie chcę też tracić czasu). Jest 17:00. Dokładną konfigurację/odtworzenie tego co było na tym co się zepsuł zostawiam na jutro. O tyle jest to nietrywialne, że ten router ma inny firmware oczywiście...

Jutro

Się okazało, że w zasadzie nie ma wiele do konfigurowania za wyjątkiem DDNS. W starym to działało ciut inaczej niż w nowym. Oczywiście mam świadomość że można tę usługę uruchomić na komputerze ale ja wolę na routerze.

Wybieram zatem www.dyndns.org(custom), wpisują swoje serwery (oddzielona przecinkami lista). No i tu klops (mały). Okienko na nazwę hosta ma znaczne ograniczenie na liczbę znaków. Nie mogę wpisać wszystkich trzech, bo się nie mieszczą. O tyle ten klops jest mały, że ten trzeci serwer to taki testowo-tymczasowy jest więc po prostu zmieniam mu nazwę na krótszą i gitara.

Teraz trzeba wypełnić tabelkę definiującą przekierowanie portów, co jest w miarę oczywiste. I wszystko -- odtworzyłem stan sprzed awarii...

piątek, 16 marca 2018

Krój Chiller

Plakat studentka do koncertu małżonki zrobiła wykorzystując do tego font pn Chiller. Font typu pisanka, wyróżnia się oryginalnym kształtem `I', do pobrania z fontzone.net (legalności nie badałem). Font nie ma polskich znaków co skutkowało m.in że w literze `ł' na przecięciu `l' oraz dostawionej kreski ukośnej się zrobiło czarno (być może da się zrobić w PhotoShopie `ł' lepiej, bo tak jak zostało zrobione, to ewidentnie wygląda, że jak dwa razy machniesz na brązowo, to masz bardziej brązowo niż jak machniesz raz). No a inne diakrytki a zwłaszcza `ą' czy `ę', to już w ogóle słabo... chociaż ogonek w zestawie gotowy jest.

No więc dorobiłem polskie diakrytyki (bo to pisanka to się odważyłem), a nawet kilkadziesiąt innych diakrytyków oraz cyfry nautyczne (bo je lubię używać). Polskie i litewskie są zrobione szczególnie starannie w tym sensie że nie nakładałem krzywych, tylko usunąłem nachodzące na siebie obszary, tworząc jedną obwiednię.

Wszystko to za pomocą fontforge. Super program muszę przyznać. ChillerPL jest tutaj.

poniedziałek, 5 marca 2018

Królowa Polski

Kto z kim przestaje takim się staje (ludowe). Wydawało się parę lat temu że Ann Applebaum to mądra babka (kiedyś Pulitzer), która wprawdzie popełniła mezalias, zauroczona tym swoim Radkiem, no ale takie rzeczy się przecież zdarzają a miłość potrafi być ślepa (znowu ludowe). No niestety do czasu:

Polacy nie rozumieją, jak wielką frustrację w Brukseli budzi Polska -- mówi Anne Applebaum w programie 'Świat, którym żyjemy'. Dodaje, że był moment, kiedy wydawało się, że Warszawa będzie jednym z liderów Unii, a teraz jest poczucie, że to była gra i że może PiS jest autentyczną twarzą Polski. Publicystka Washington Post uważa, że pozycja Polski w strukturach międzynarodowych będzie w dużej mierze zależała od wyniku następnych wyborów. 'Nie wiem, jak długo Polska będzie w Unii Europejskiej i w NATO; jeżeli Polacy w kolejnych wyborach znów zagłosują na PiS, to Zachód zapyta, czy w Europie jest nadal miejsce dla Polski' -- przewiduje laureatka nagrody Pulitzera.

Problemem "Polaków" wszakże nie jest PiS, ale co zamiast PiSu. Tzn. żeby nie wygrał PiS musi być alternatywa, a partia pana Schetyny jest taka sprawna/wiarygodna/ jak jest sprawny/wiarygodny inaczej jej przewodniczący. A to jest zdecydowanie największa partia opozycyjna i jedyny teoretyczny kandydat na odebranie władzy w demokratycznych wyborach PiSowi.

Zatem jeżeli p. Applebaum chce ocalić Polskę, to musi postąpić jak Bolec-Legenda-Wałęsa: nie chcem ale muszę.

Co muszę to jest w tytule...

wtorek, 27 lutego 2018

Wybory parlamentarne z 2015 w woj pomorskim

Po latach wykonałem analizę (z rozpędu, zmotywowany analizowaniem wyników Danuty Hojarskiej). W województwie pomorskim są dwa okręgi wyborcze: 25 (Gdańsk) oraz 26 Gdynia. Zbiorcze wyniki z protokołów, które w swoim czasie pobrałem ze strony PKW są następujące:

  Komisje obwodowe wg ROZKŁADU głosów ważnych
  ** Okręg 26 126707 ważne głosy **
Kandydat    Komitet    Głosy Komisje Max      %  Średnia   Me 
-------------------------------------------------------------
Gromadzki   Stonoga     1521  795     12   1.20    1,9    1.0
Furgo       Petru      14239  795    224  11.23   17,9  10.00
Zwiercan    Kukiz      11801  795     65   9.31   14.8   13.0
Miller      Zlew       11524  795     72   9.09   14.5   10.0
Lewna       Psl         4644  795    213   3.66    5.8    2.0
Wysocki     Korwin      9491  795     54   7.49   11.9   10.0
Biernacki   Po         42535  795    312  33.56   53.5   38.0
Szczypińska PiS        30952  795    150  24.42   38.9   35.0

** Okręg 25 130348 ważne głosy **
Kandydat    Komitet    Głosy Komisje Max      %  Średnia   Me
-------------------------------------------------------------
Hojarska    Stonoga     1668  656    152   1.27    2.5    1.0
Lieder      Petru      23155  656    256  35.76   35.3   22.0
Błeńska     Kukiz       9410  656     45   7.21   14.3   14.0
Senyszyn    Zlew       13143  656     75  10.08   20.3   17.0
Sarnowski   Psl         3457  656    134   2.65    5.3    2.0
Rabenda     Korwin      8903  656     65   6.83   13.6   11.0
Krotowska   Razem       6995  656     45   5.36   10.7    9.0
Korol       PiS        28657  656    252  21.98   43.7   30.0
Sellin      PiS        34960  656    213  26.82   53.3   40.0

Te wyniki mogą (ale nie muszą) się ciut-niewiele różnić od oficjalnych--nie porównywałem

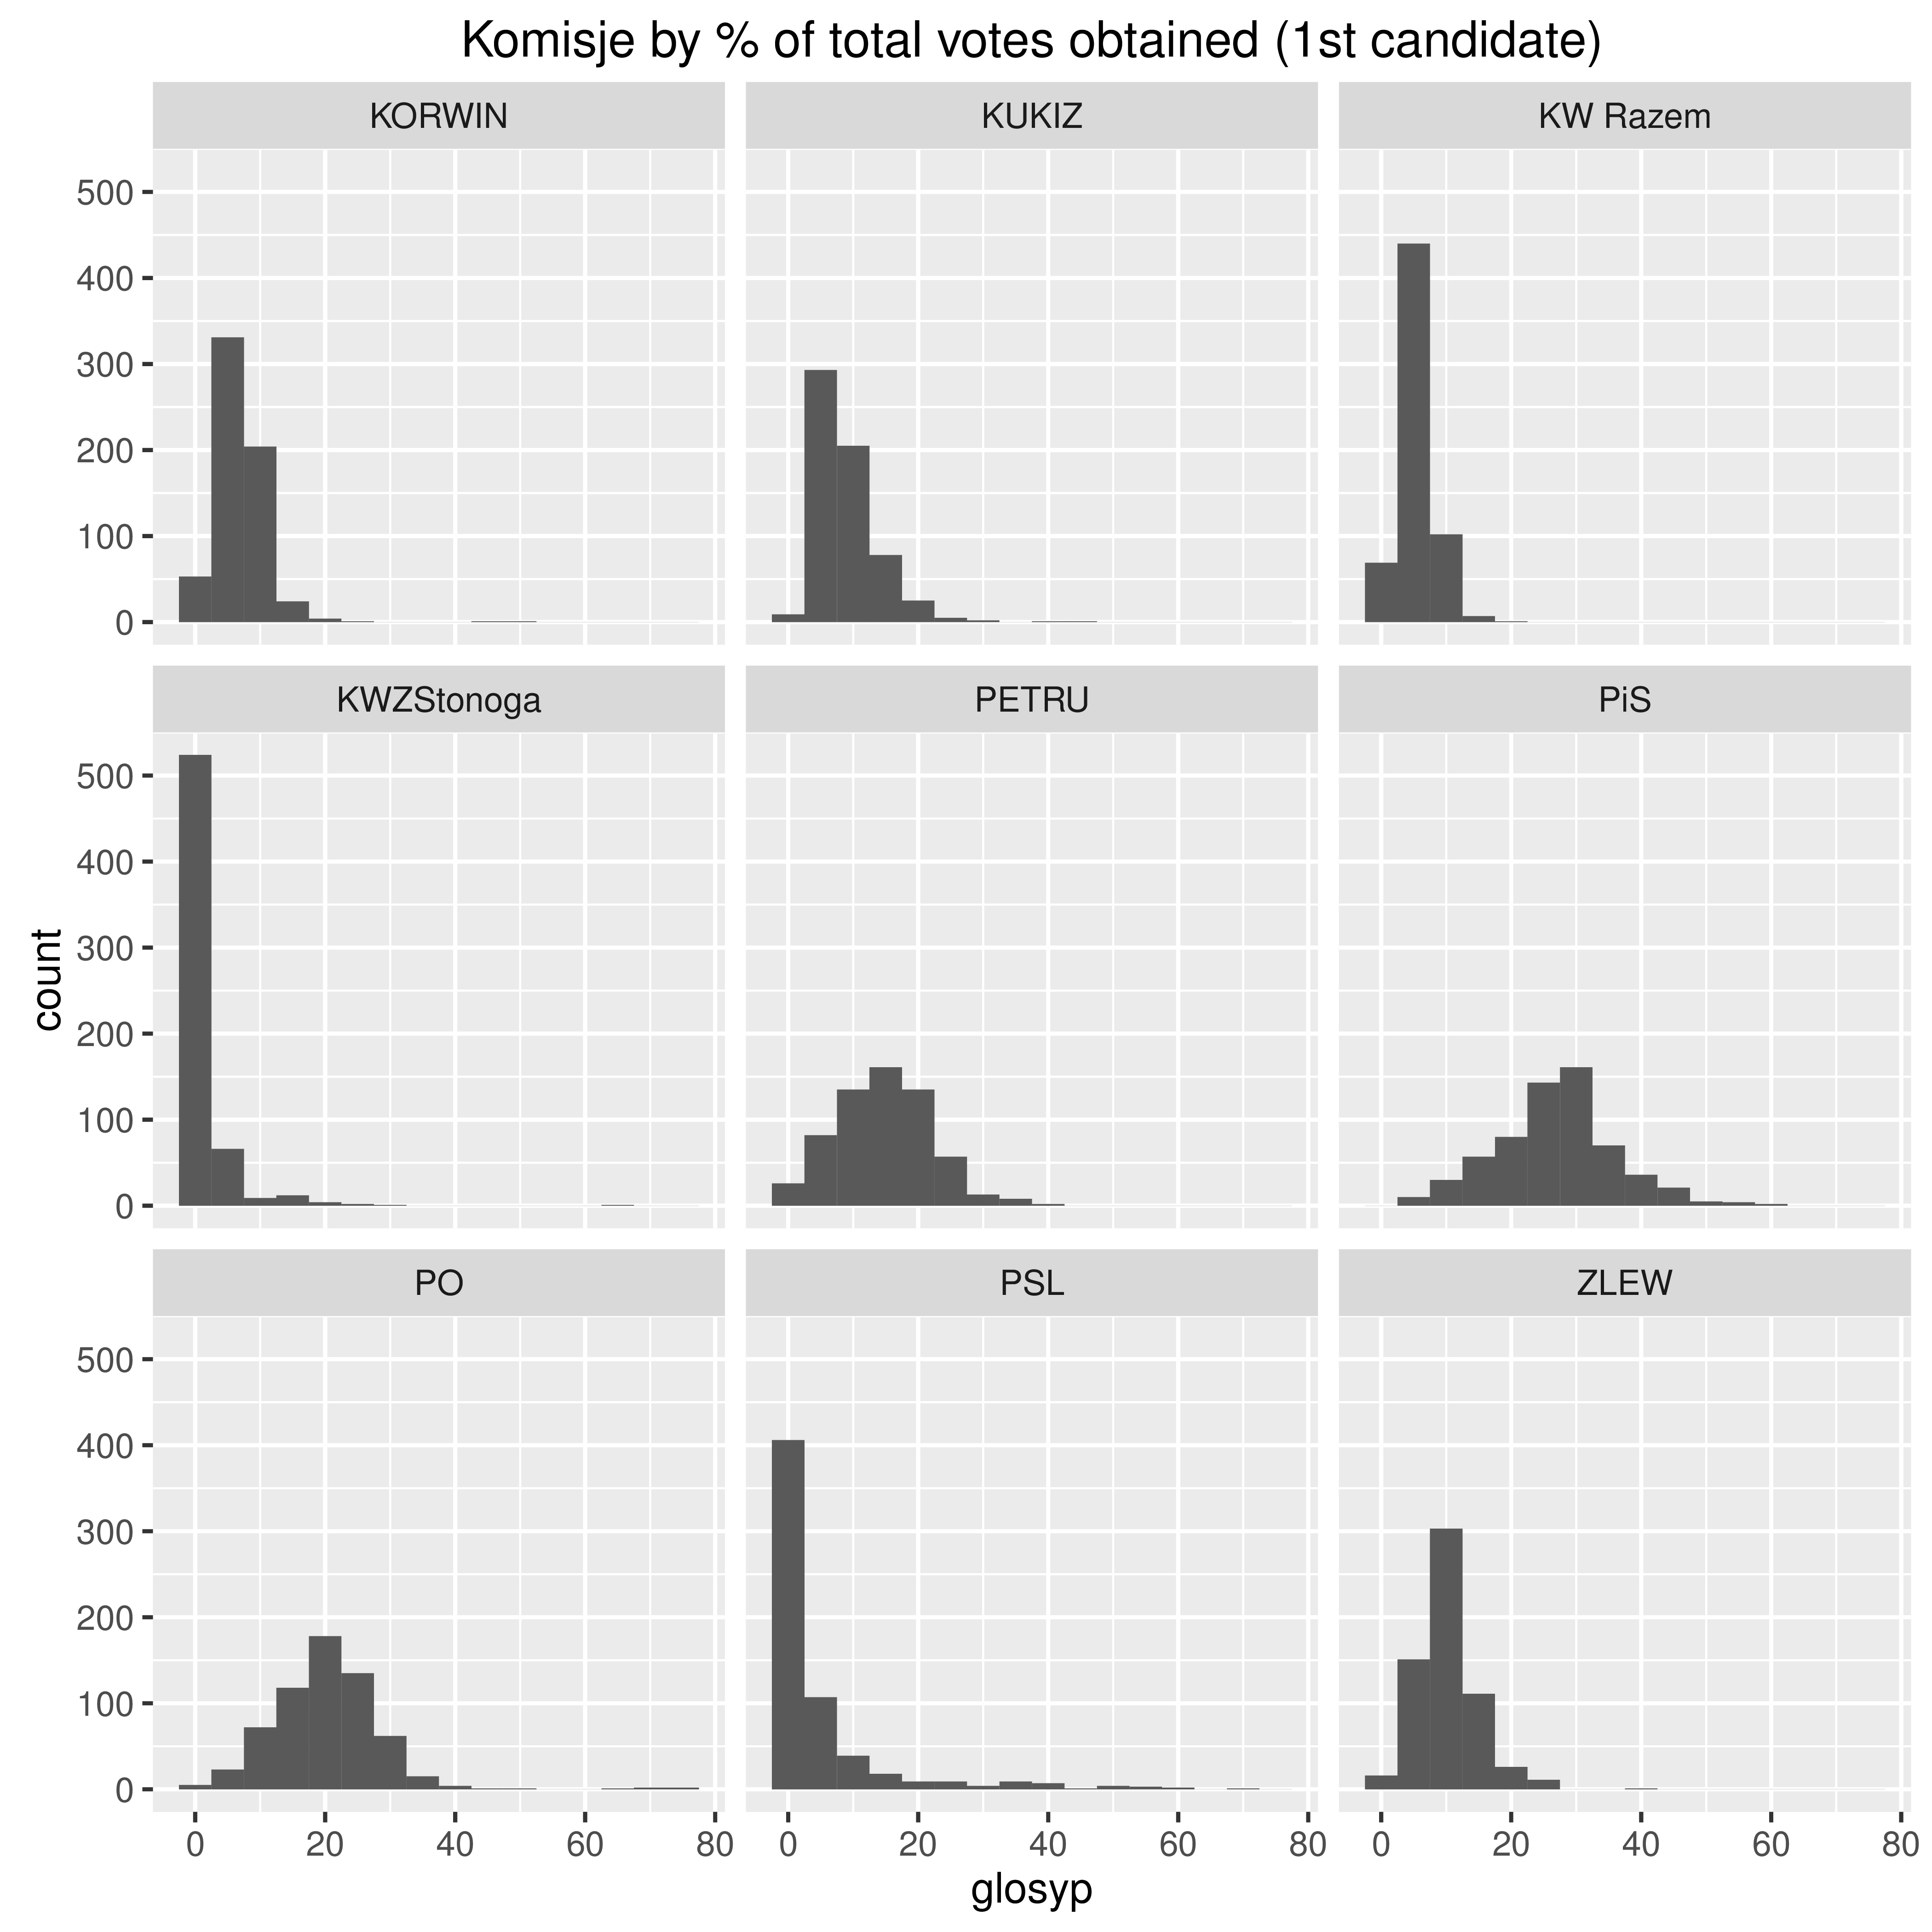
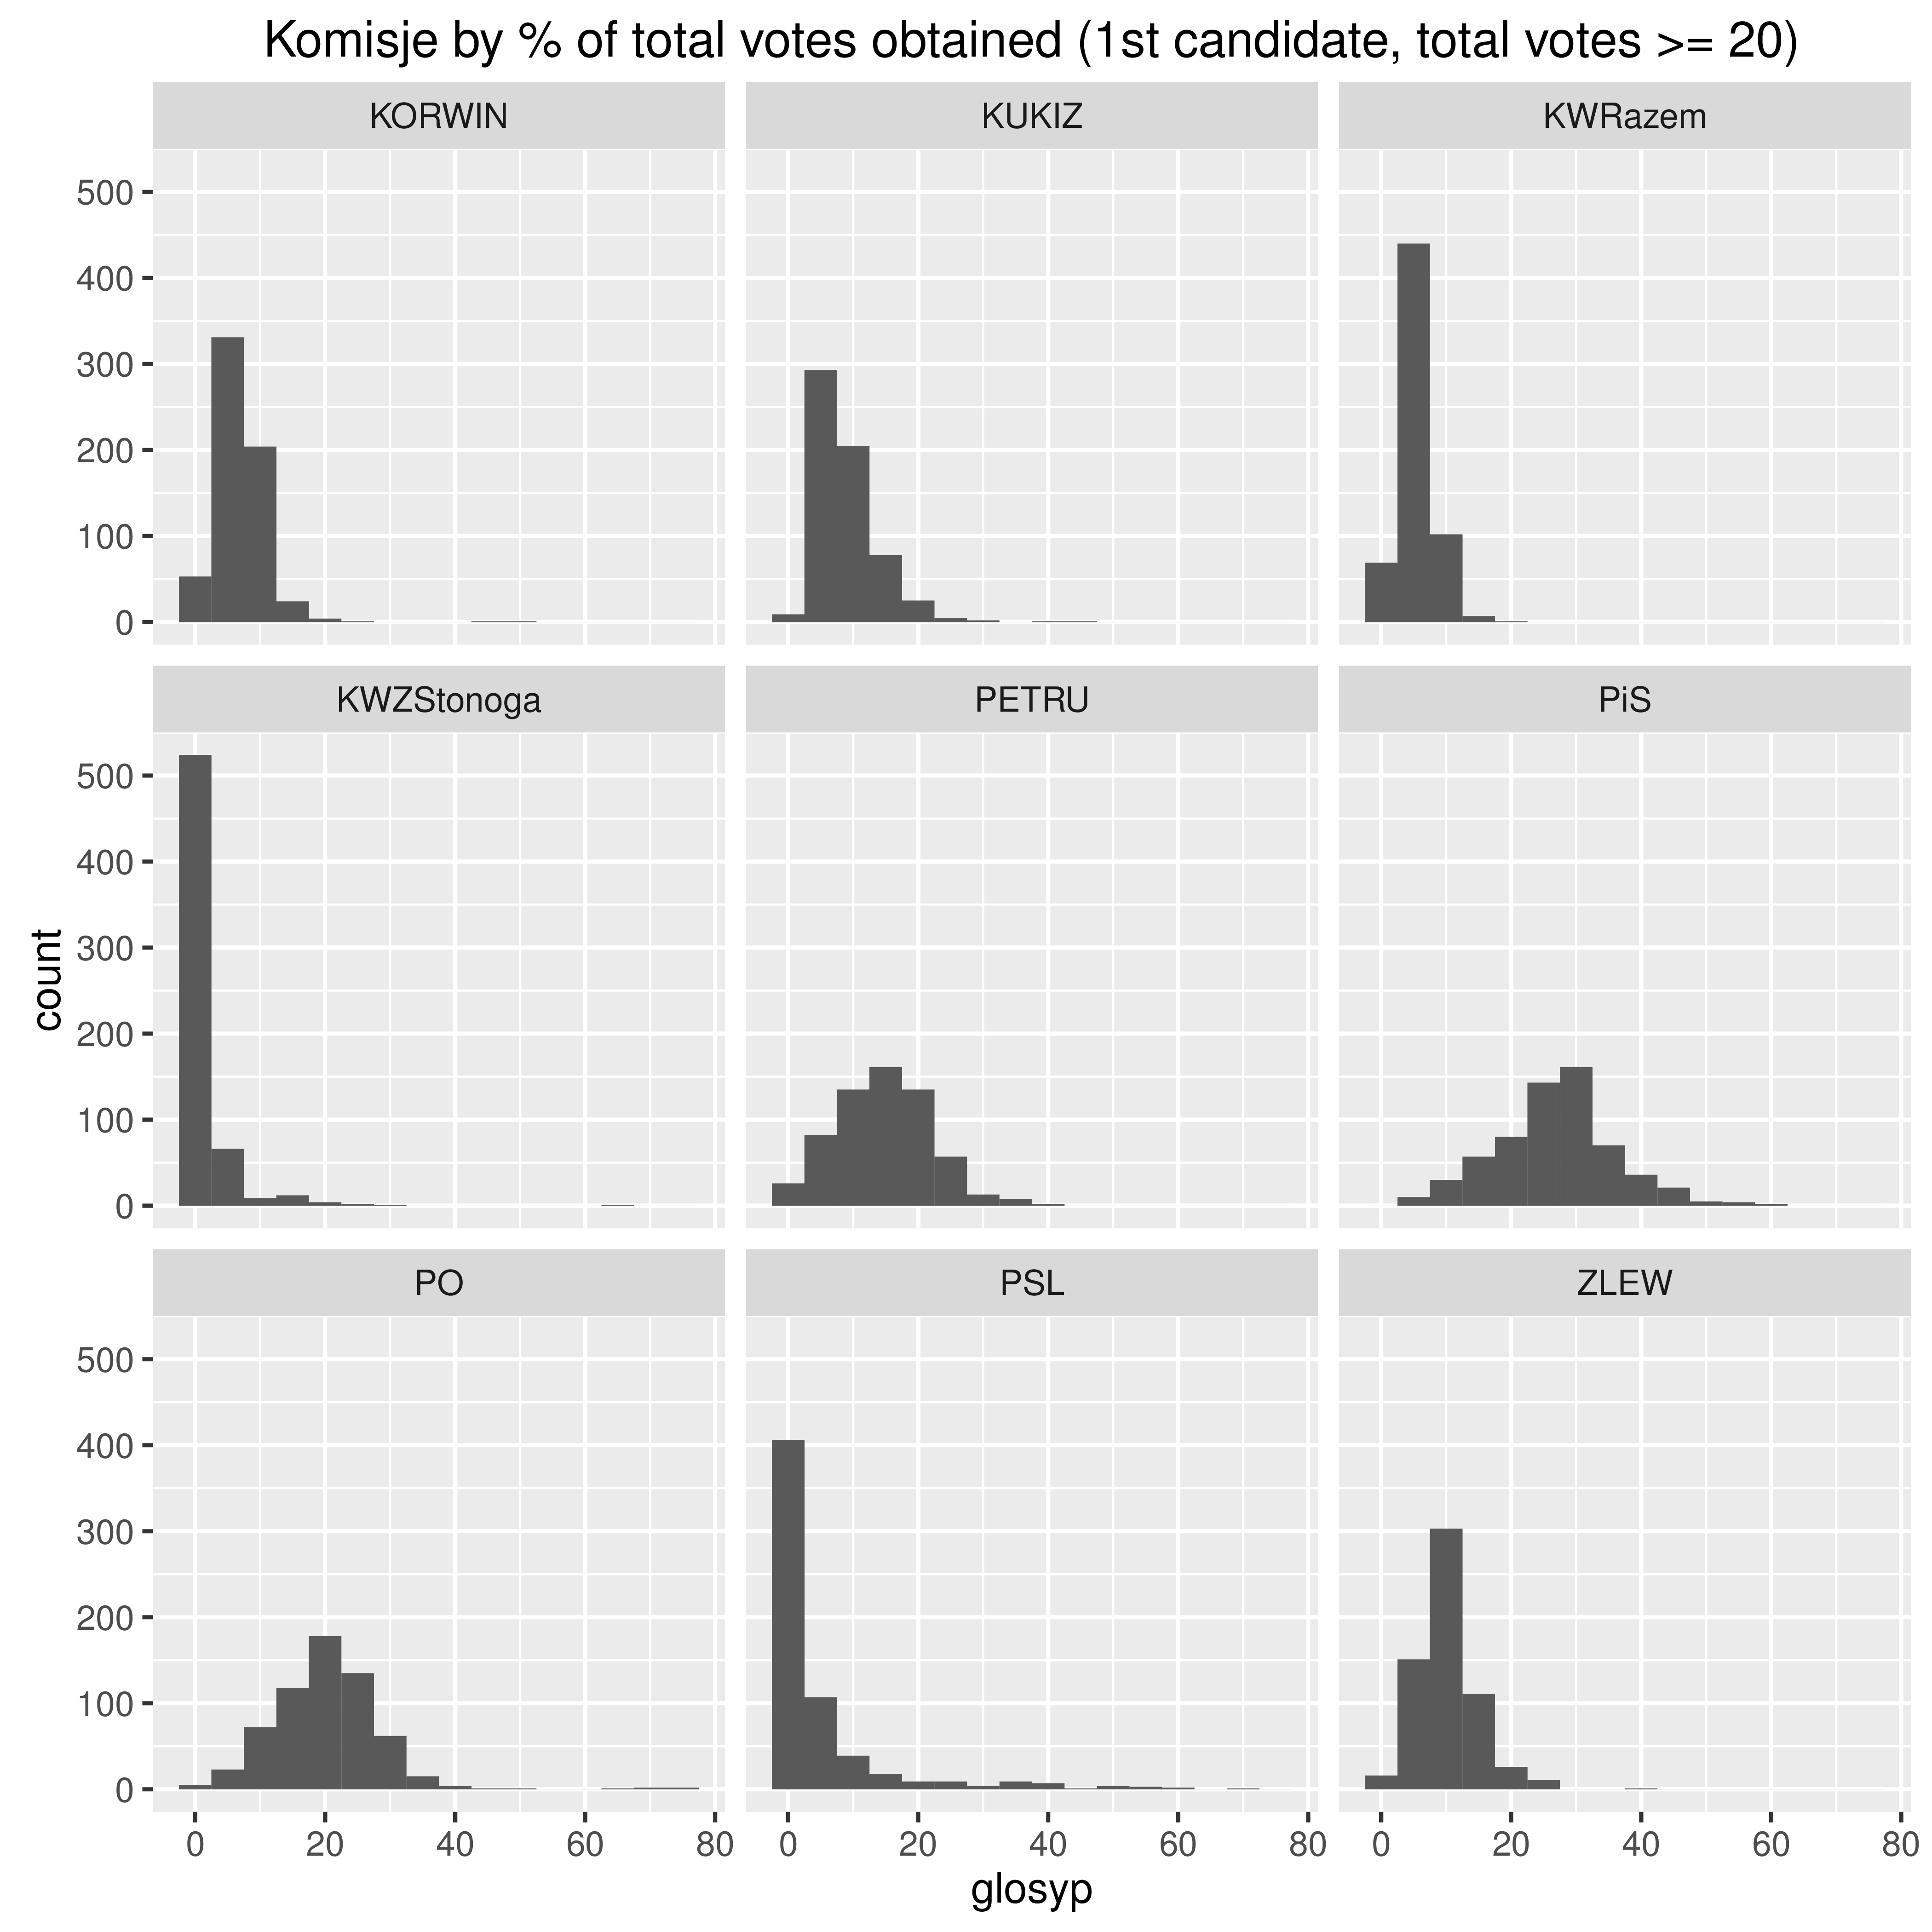
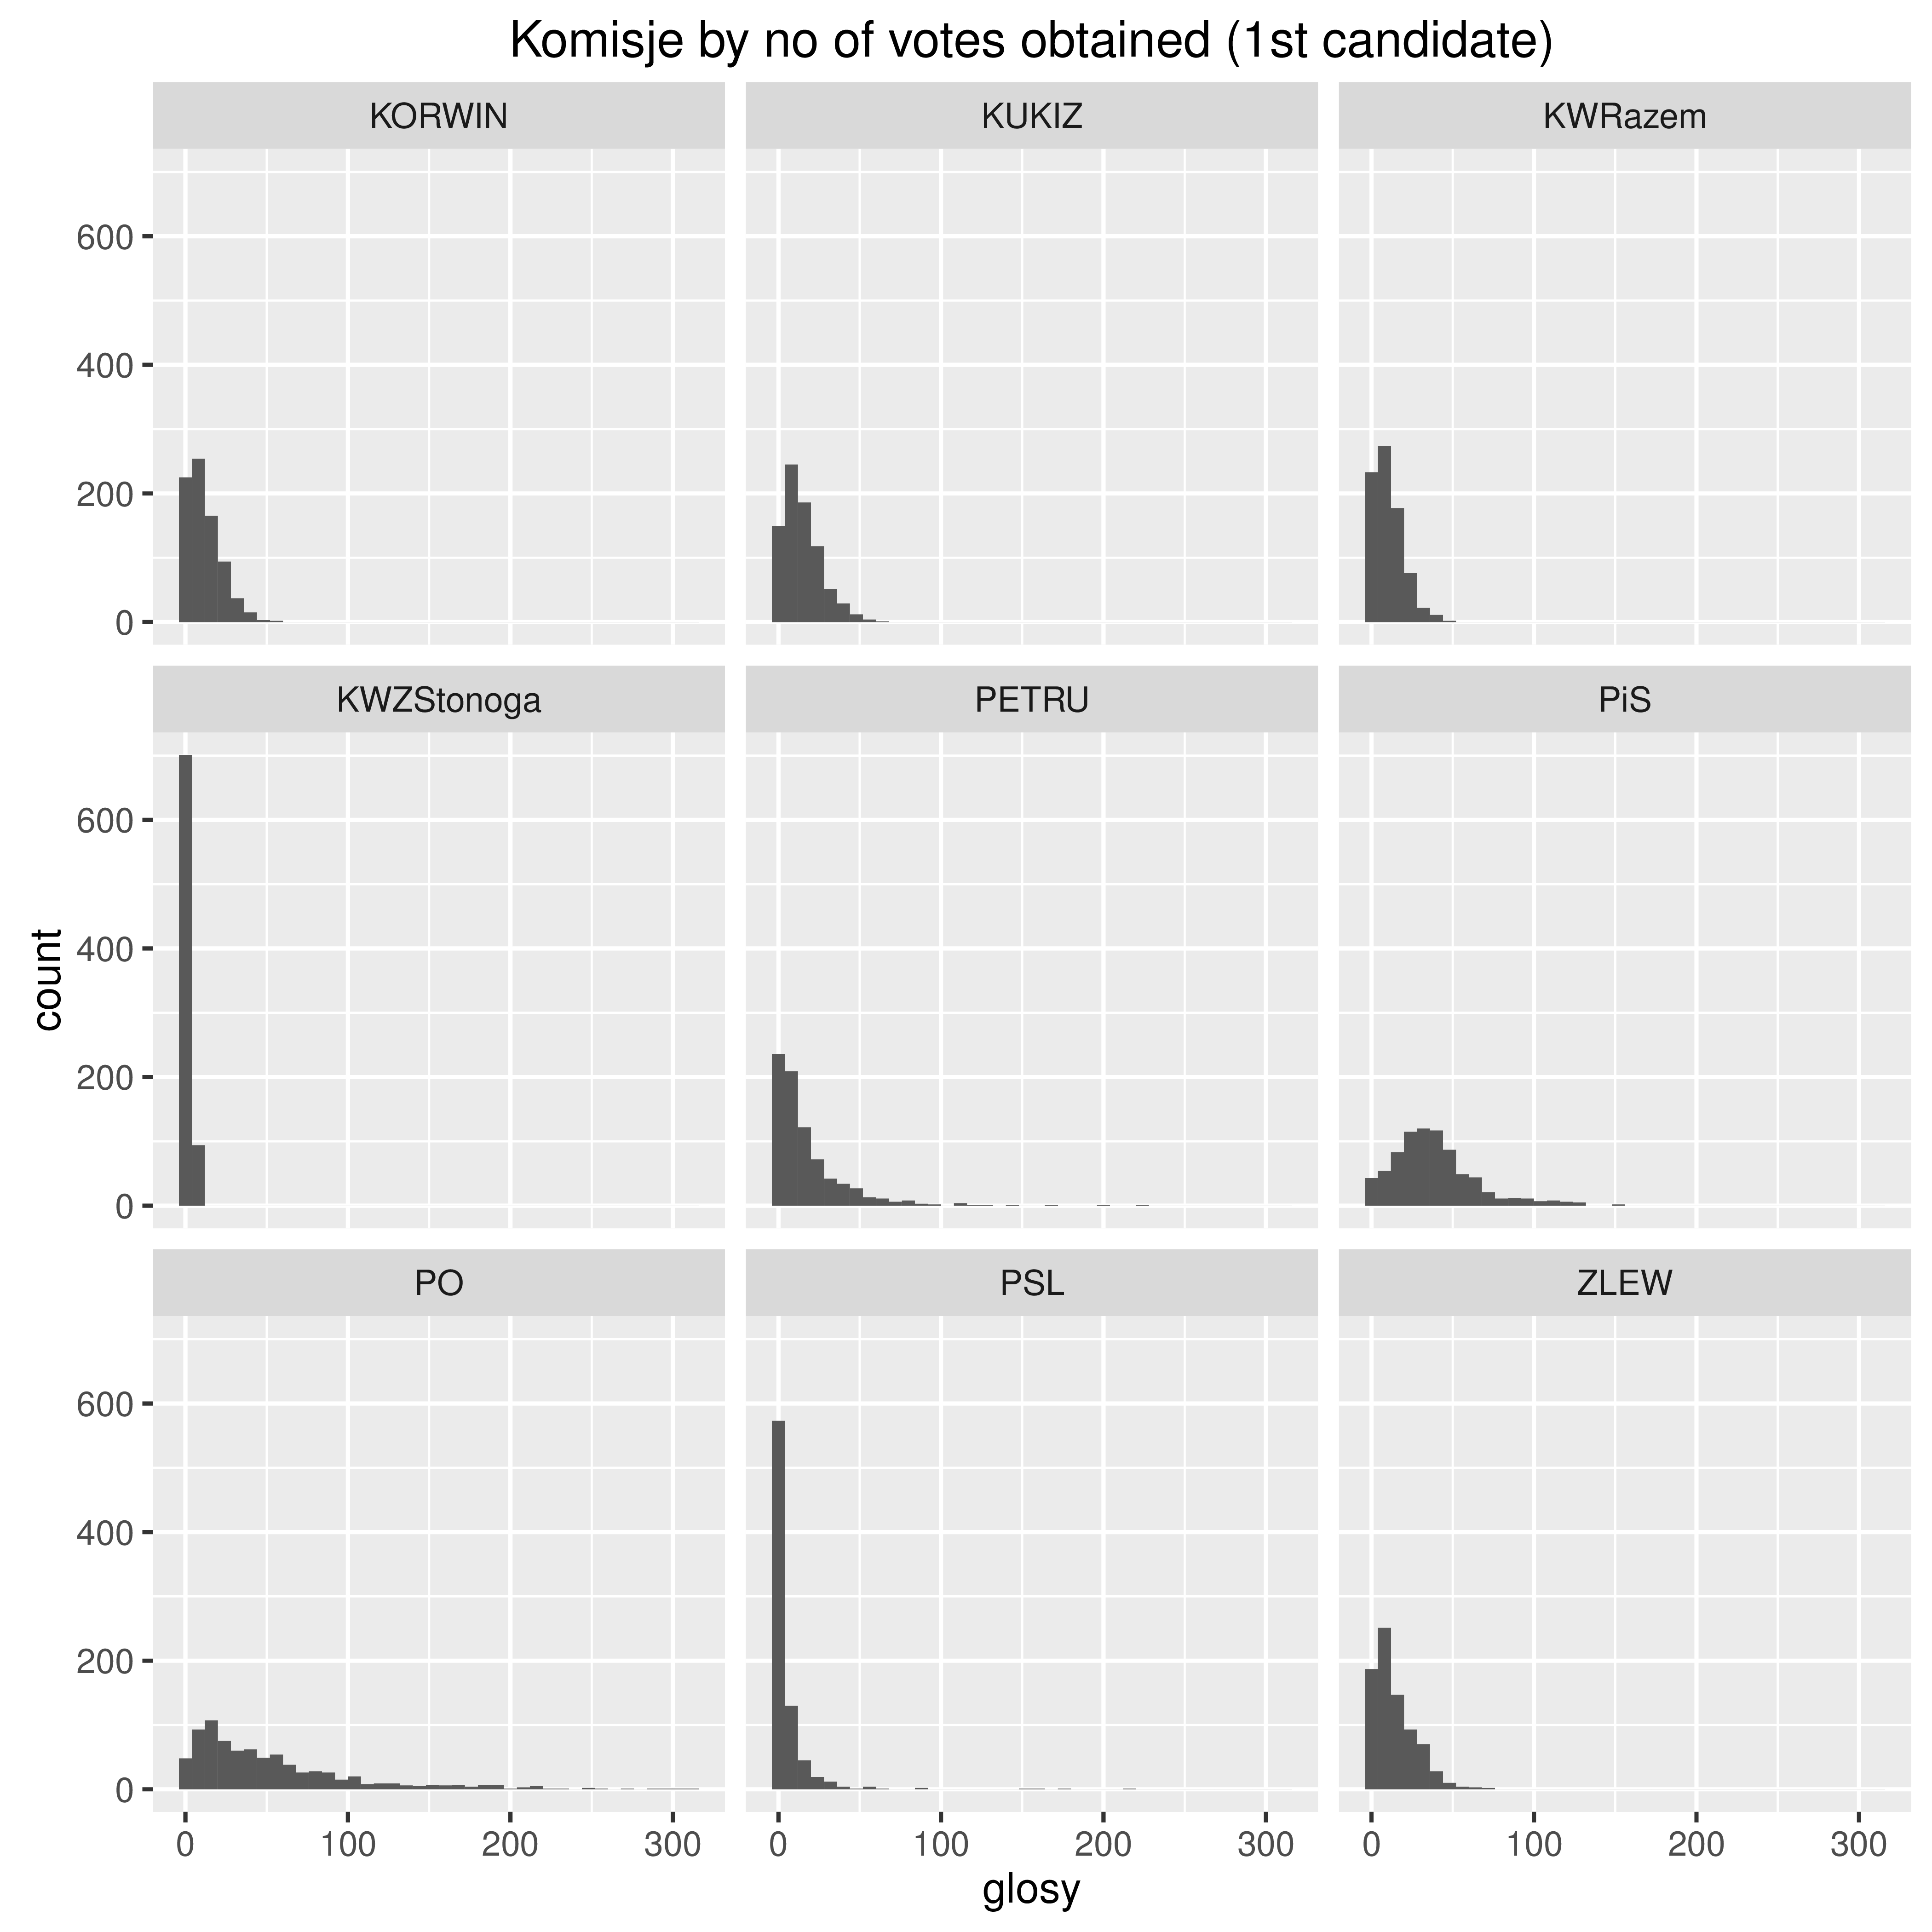
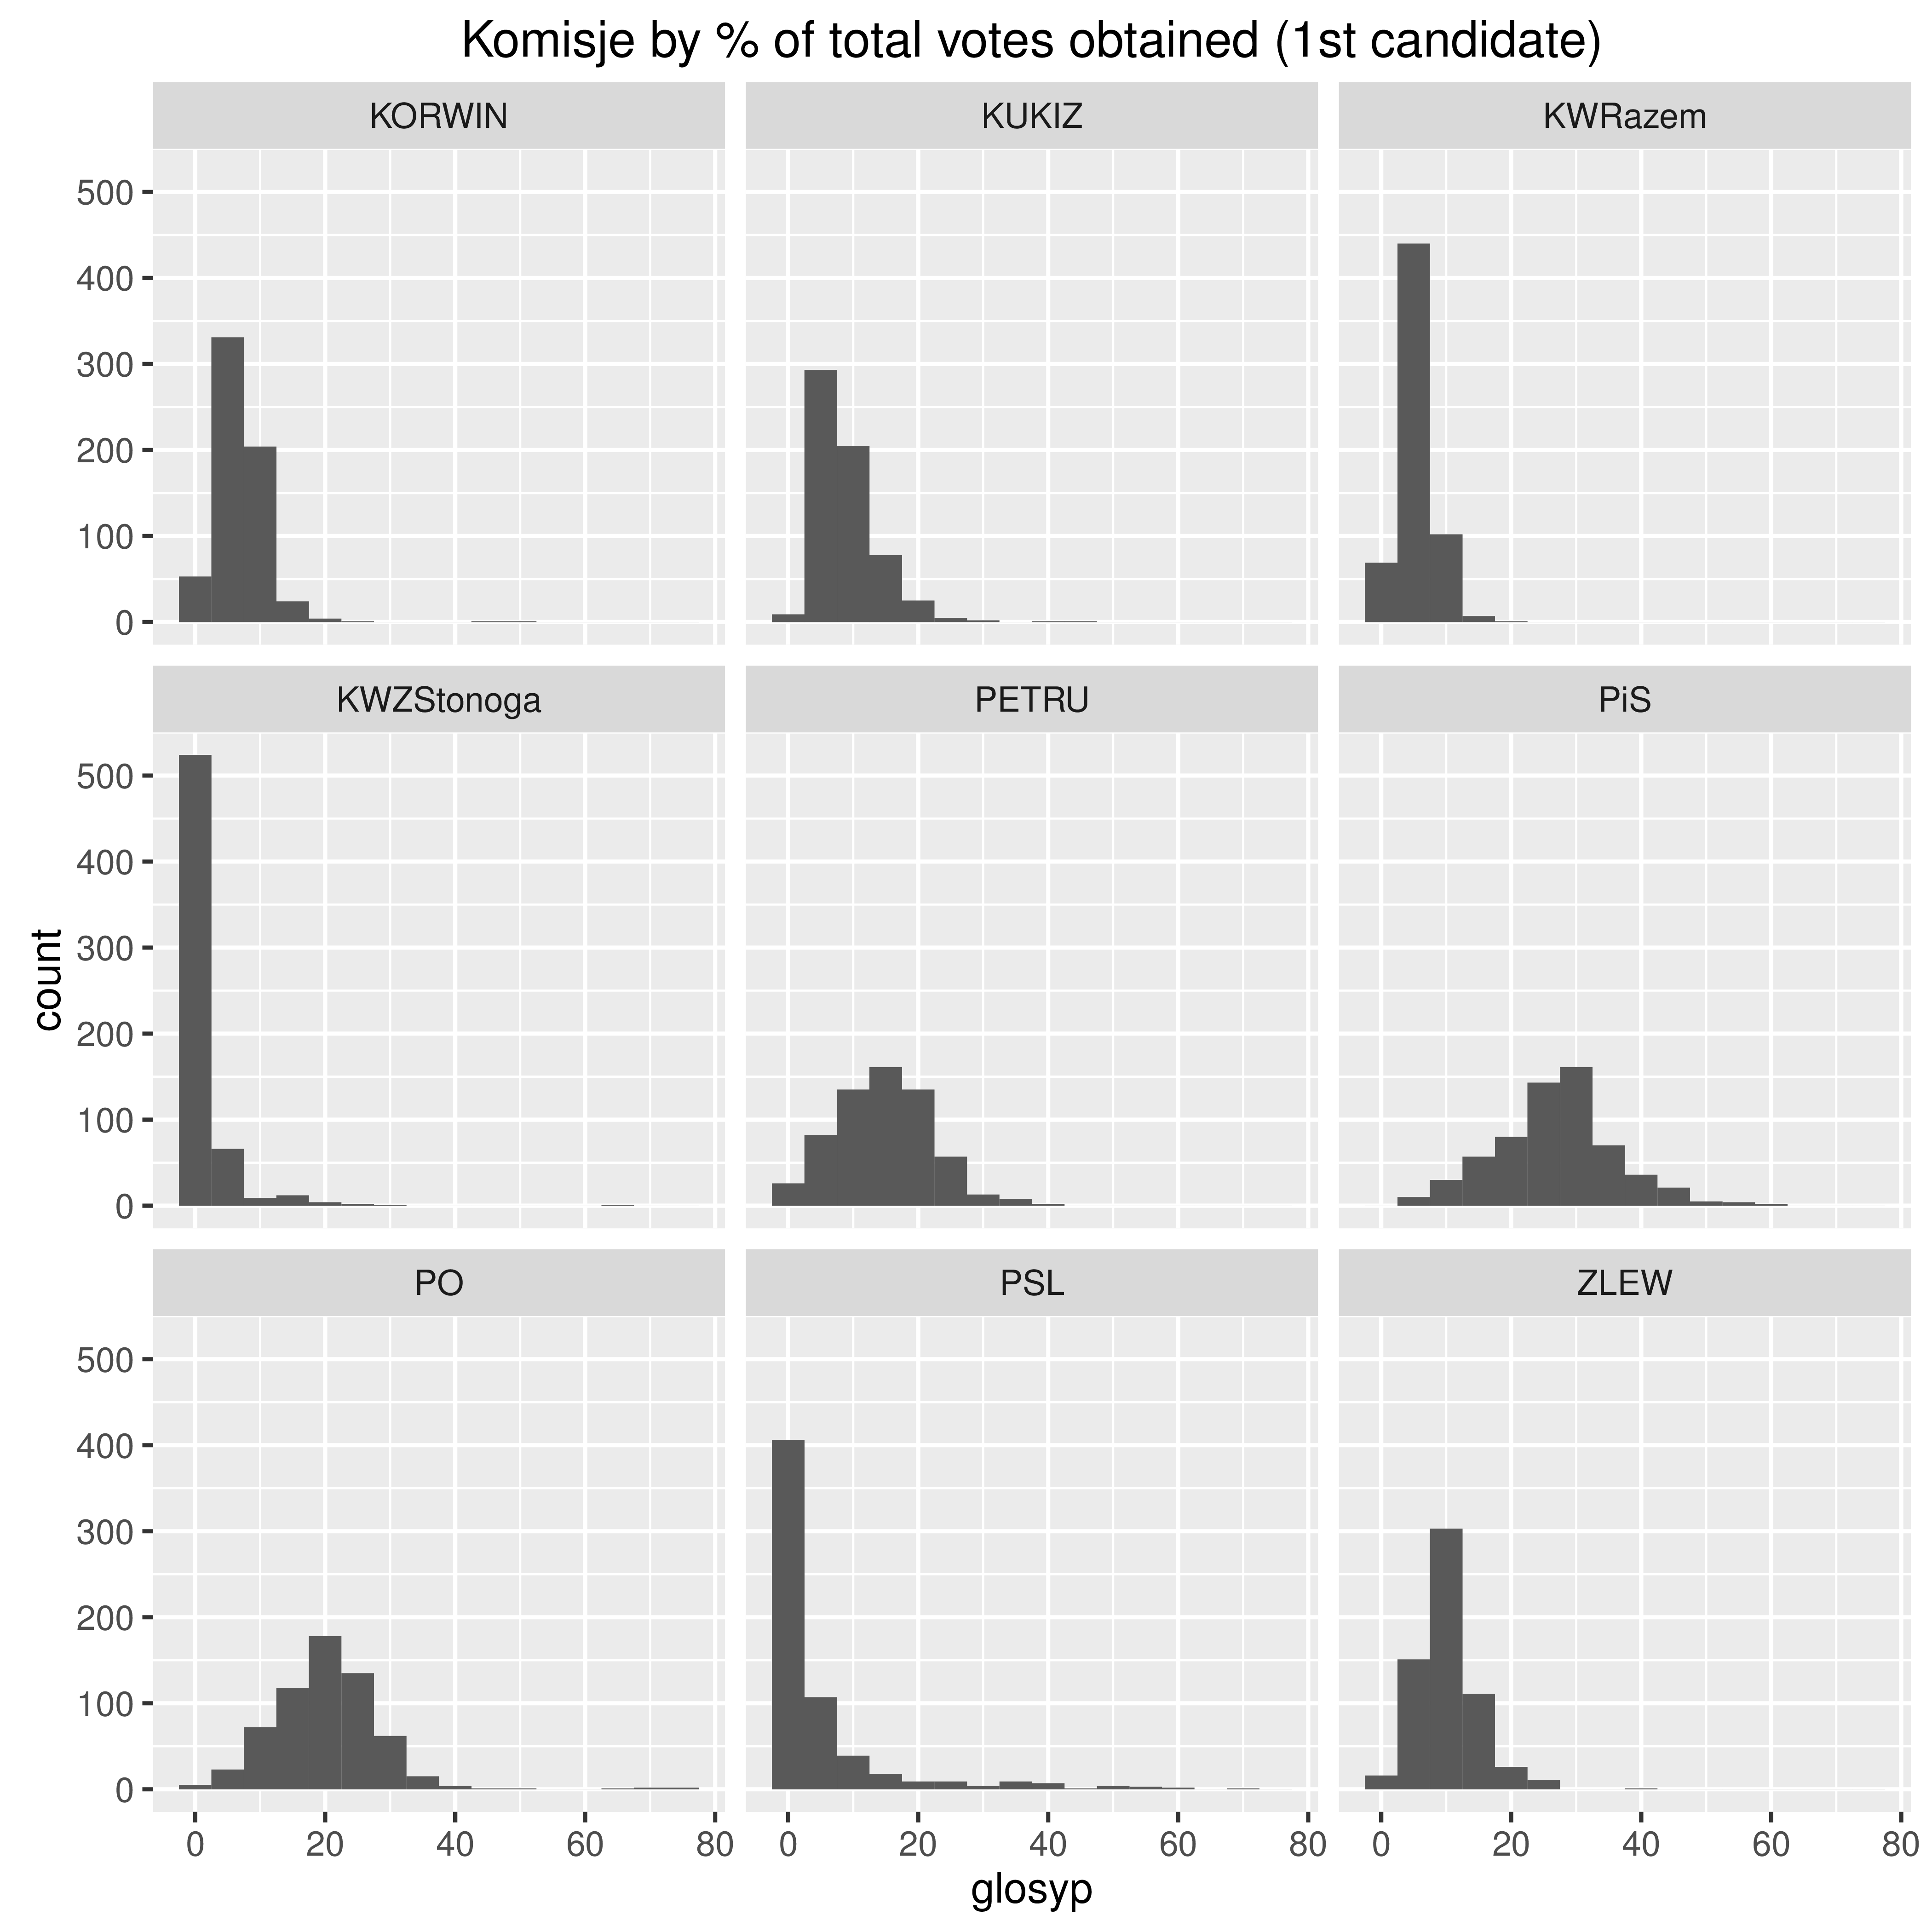
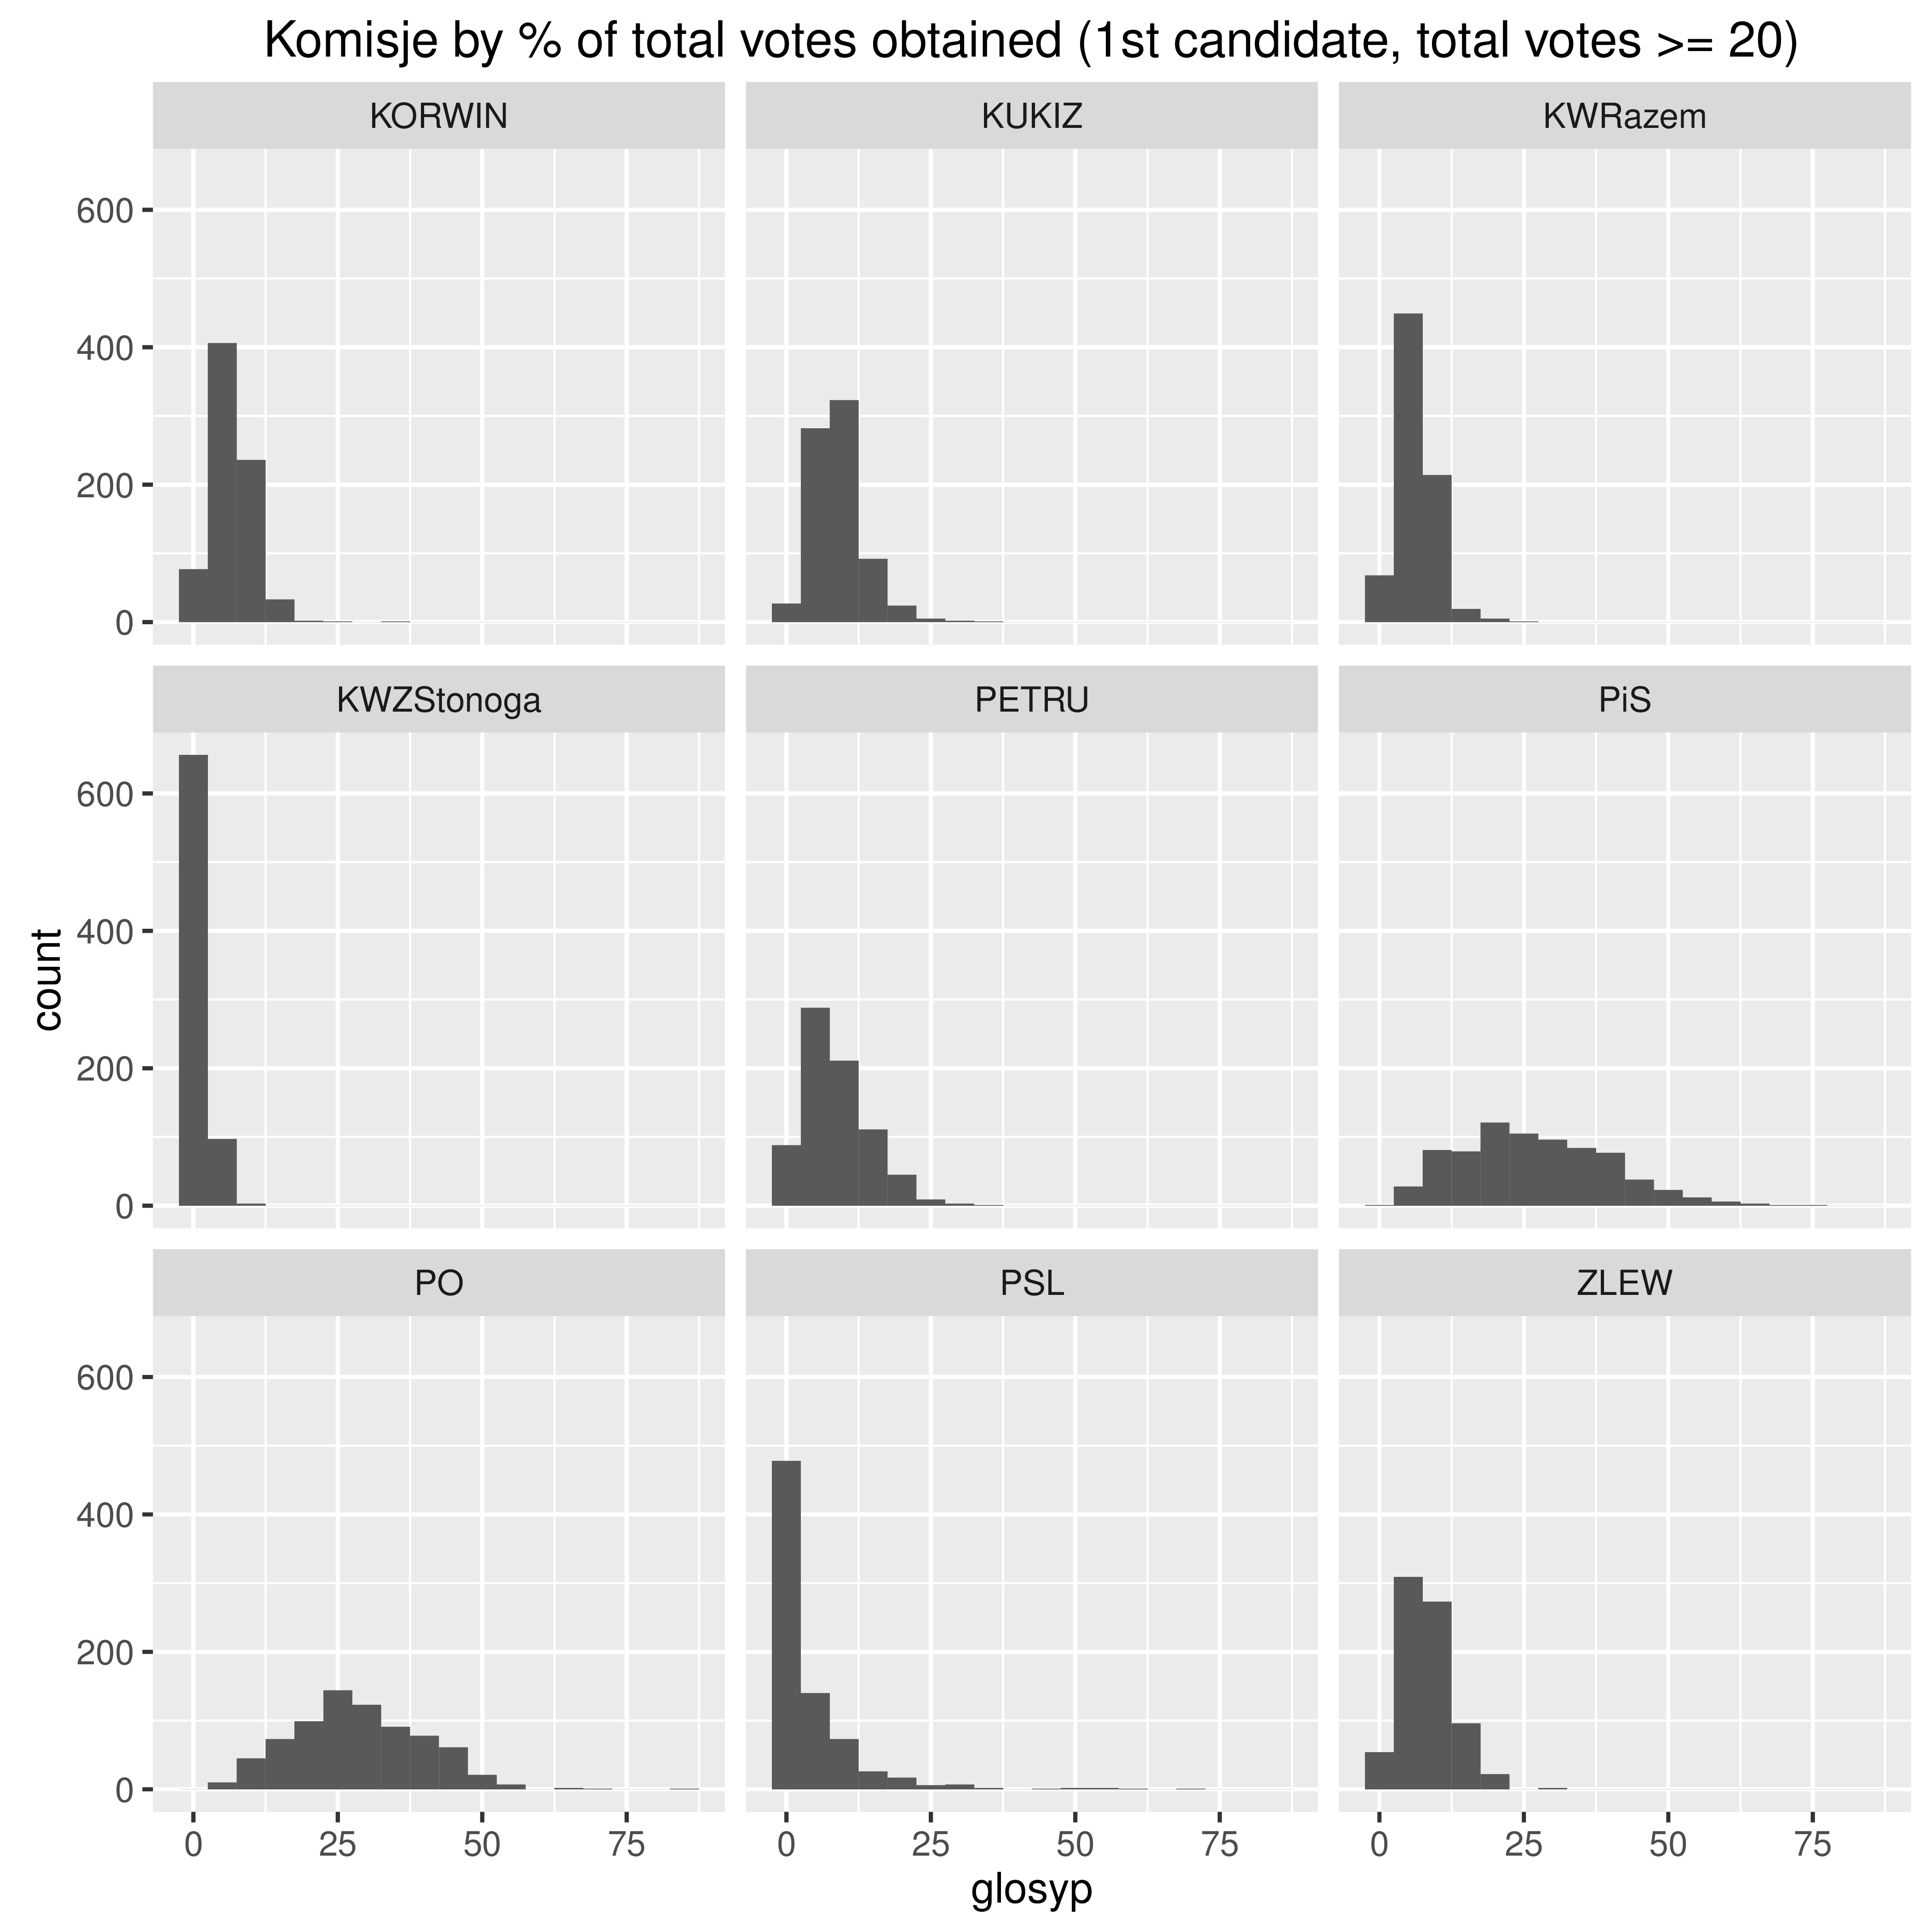
Czyli na przykład pani Hojarska dostała 1668 głosów w 656 komisjach co daje średnio 2,5 głosa/komisję (Mediana 1 głos). Rozkłady liczby głosów przedstawione w postaci wykresów słupkowych wyglądają następująco (pierwsze trzy rysunki to okręg 25, następne trzy to okręg 26):

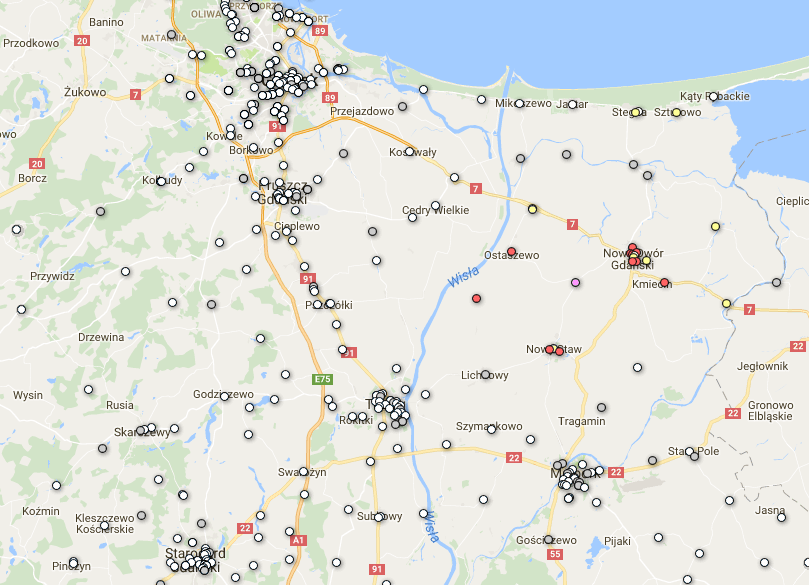
No i wreszcie przedstawienie wyników na mapie z wykorzystanie Google Fusion Tables link do GFT:

Link do danych jest tutaj.

niedziela, 25 lutego 2018

W prawe ucho lewą ręką przez poręcz

Doszedłem do punktu, w którym tylko tak mogę się podrapać:-)

Mianowicie do pisania bloga używam ciągle kodowania ISO8859-2. Chciałem zmienić na UTF-8, ale wymagałoby to pewnych zabiegów związanych z późniejszym publikowaniem. Nie wchodząc w szczegóły nie chce mi się poświęcać temu czas.

Z drugiej strony czasami ISO-8859-2 ogranicza. Na tę okoliczność wymyśliłem sprytny trick: teksty zawierająca nieincydentalne znaki spoza ISO8859-2 będę pisał w UTF-8 a potem zamienię znaki spoza zakresu ISO8859-2 na character entities typu &cośtam; a resztę przekoduję do ISO. Dało się:

  ## zmienia UTF na encje (http://billposer.org/Software/uni2ascii.html)
  uni2ascii -e -a D ekstremalna_skosnosc.bl8 > ekstremalna_skosnosc.enc
  ## zmienia encje na znaki iso8859-2 (tylko polskie znaki): 
  perl entutf2iso88592.pl ekstremalna_skosnosc.enc > ekstremalna_skosnosc.blx

Śmiesznie, ale działa. Programu uni2ascii nie było w archiwach Fedory, ale bez problemu się skompilował ze źródła.

Hojarskiej ekstremalnie skośny rozkład głosów

Uczono mnie, że współczynnik skośności aczkolwiek może przyjąć wartości większe od 3, to w praktyce taka sytuacja się nie zdarza. Dlatego z rezerwą podszedłem do obliczeń, z których wynikało, że dla pewnego zbioru danych wynosi on 14:

library(moments)
# Wynik 1-ki z listy komitetu Z.Stonogi (D.Hojarska, wybory 2015)
s <- read.csv("hojarska.csv", sep = ';', header=T, na.string="NA");
skewness(s$glosy)
[1] 14.08602

nrow(s)
[1] 657

sum(s$glosy)
[1] 1671

Pierwsza hipoteza jest taka, że formuła liczenia współczynnika może być egzotyczna. Ustalmy zatem jak toto jest liczone:

?skewness
Description:  
This function computes skewness of given data

Wiele to się nie dowiedziałem. Po ściągnięciu źródła można ustalić, że to współczynnik klasyczny czyli iloraz trzeciego momentu centralnego przez odchylenie standardowe do trzeciej potęgi. Zatem jak najbardziej klasyczny a nie egzotyczny. Sprawdźmy co wyliczy Perl dla pewności:

#!/usr/bin/perl

print STDERR "** Użycie: $0 plik numer-kolumny (pierwszy wiersz jest pomijany)\n";
print STDERR "** Domyślnie: wyniki kandydata nr1 na liście komitetu Z.Stonoga (okr.25 / D.Hojarska)\n";

$file = "hojarska.csv"; ## default file
$column = 1; ## first column = 0

if ( $#ARGV >= 0 ) { $file=$ARGV[0]; } 
if ( $#ARGV >= 1 ) { $column=$ARGV[1]; } 

open (S, "$file") || die "Cannot open $file\n";

print "\nDane z pliku $file (kolumna: $column):\n"; 
$hdr = <S> ; # wczytaj i pomin naglowek ($n będzie prawidłowe)
while (<S>) { chomp();
  @tmp = split (/;/, $_); 
  $v = $tmp[$column];
   push(@L, $v) ; 
   $sum += $v; 
   $Counts{"$v"}++;
   $n++;
}

# Wyznaczenie średniej:
$mean = $sum /$n; 

## Wyznaczenie dominanty:
## przy okazji wydrukowanie danych pogrupowanych
print "+--------+---------+--------+--------+--------+\n";
print "| Głosy  | Obwody  |  cumGł | cumGł% |  cumN% |\n";
print "+--------+---------+--------+--------+--------+\n";
$maxc = -1;
for $c (sort {$a <=> $b } keys %Counts ) { 
  $sumCum += $Counts{"$c"} * $c; 
  $nCum += $Counts{"$c"}; 
  if ($maxc_pos < $Counts{$c} ) { 
    $maxc_pos = $Counts{$c} ; $maxc_val = $c
  }
  printf "| %6d |  %6d | %6d | %6.2f | %6.2f |\n", 
    $c,  $Counts{$c}, $sumCum, $sumCum/$sum *100, $nCum/$n *100;
}
print "+--------+---------+--------+--------+--------+\n\n";

$mode = $maxc_val; # dominanta

## Wyznaczenie mediany:
$half = int(($#L +1)/2 );
@L = sort ({ $a <=> $b } @L) ; #numerycznie
##print "$half of @L\n";
$median = $L[$half];

printf "Średnie: x̄ = %.3f (N=%d) Me =%.3f D = %.3f\n", $mean, $n, $median, $mode;

## Odchylenia od średniej:
for my $l (@L) {##
  $sd1 = ($l - $mean) ; 
  $sd2 = $sd1 * $sd1; # ^2 
  $sd3 = $sd2 * $sd1; # ^3

  $sum_sd1 += $sd1; $sum_sd2 += $sd2;
  $sum_sd3 += $sd3;
}

# odchylenie std./3-ci moment:
$sd = sqrt(($sum_sd2 / $n)); 
$u3 = $sum_sd3/$n;

printf "Sumy (x-x̄): %.2f(¹) %.2f(²) %.2f(³)\n", 
   $sum_sd1, $sum_sd2, $sum_sd3;
printf "Rozproszenie: σ = %.3f µ³ = %.3f\n", $sd, $u3;

printf "Skośność: (x̄-D)/σ = %.2f", ($mean -$mode)/$sd;
printf " 3(x̄-Me)/σ) = %.2f", 3 * ($mean - $median)/$sd;
printf " (µ³/σ³) = %.2f\n", $u3/($sd*$sd*$sd);
##//

Uruchomienie powyższego skryptu daje w wyniku to samo. Moja pewność, że wszystko jest OK jest teraz (prawie że) stuprocentowa.

Wracając do R:

library(ggplot2);
p <-  ggplot(data = s, aes(x = glosy)) + geom_histogram(binwidth = 4)
p
breaks <- ggplot_build(p)$data
breaks

[[1]]
     y count   x xmin xmax      density      ncount    ndensity PANEL group
1  482   482   0   -2    2 0.1834094368 1.000000000 2628.000000     1    -1
2  140   140   4    2    6 0.0532724505 0.290456432  763.319502     1    -1
...

Pierwszy przedział jest definiowany jako (-2;2], ale z uwagi na wartość danych de facto liczy głosy w komisjach, w których Hojarska dostała 0--2 głosów (drugi to (2;6], itd) i ni cholery nie da się tego zmienić na coś bardziej zbliżonego do prawdy. Bo tak jak jest to faktycznie pierwszy przedział jest dwa razy węższy niż każdy pozostały. W szczególności prawdziwa średnia, w tym przedziale wynosi 1,259 głosa, zaś liczona jako środek przedziału przez liczebność wynosi 1.0 (482 *1/482). Wg formuły ggplota środek przedziału to zero zatem średnia też wyjdzie 0, tj. wartość jest wyznaczona z dużym/nieokreślonym błędem.

Dzieje się tak ponieważ: the histogram is centered at 0, and the first bars xlimits are at 0.5*binwidth and -0.5*binwidth. Dopiero gdy dane są dodatnie, to ggplot zaczyna od zera. No ale nasz zbiór zawiera zera i klops. Zmiana tego jest nietrywialna.

Zamiast ggplota moża użyć po prostu polecenia hist:

h <- hist(s$glosy, breaks=seq(0,max(s$glosy), by=4) )
h

$breaks
 [1]   0   4   8  12  16  20  24  28  32  36  40  44  48  52  56  60  64  68  72
[20]  76  80  84  88  92  96 100 104 108 112 116 120 124 128 132 136 140 144 148
[39] 152

$counts
 [1] 592  42   6   4   2   2   2   1   2   1   2   0   0   0   0   0   0   0   0
[20]   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   0   1

$density
 [1] 0.2252663623 0.0159817352 0.0022831050 0.0015220700 0.0007610350
 [6] 0.0007610350 0.0007610350 0.0003805175 0.0007610350 0.0003805175
[11] 0.0007610350 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[16] 0.0000000000 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[21] 0.0000000000 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[26] 0.0000000000 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[31] 0.0000000000 0.0000000000 0.0000000000 0.0000000000 0.0000000000
[36] 0.0000000000 0.0000000000 0.0003805175

$mids
 [1]   2   6  10  14  18  22  26  30  34  38  42  46  50  54  58  62  66  70  74
[20]  78  82  86  90  94  98 102 106 110 114 118 122 126 130 134 138 142 146 150

No teraz liczy (prawie) jak trzeba pierwszy przedział [0;4], drugi (4;8] itd. Prawie bo na upartego pierwszy przedział jest szeroki na 5 wartości a kolejne na 4. Eh te detale i te upierdliwe zero:-)

Przy okazji się zadumałem, a cóż to jest to density. W pierwszym podejściu, że to są częstości, ale nie, bo ewidentnie nie sumują się do 1:

  ?hist
  density: values f^(x[i]), as estimated density values. If
          `all(diff(breaks) == 1)', they are the relative frequencies
          `counts/n' and in general satisfy sum[i; f^(x[i])
          (b[i+1]-b[i])] = 1, where b[i] = `breaks[i]

No dość kryptycznie, ale można się domyśleć, że nie $\sum_i d_i =1$, ale $\sum_i d_i * w_i$, gdzie $w_i$, to szerokość przedziału $i$ (a $d_i$ oznacza gęstość w przedziale $i$ oczywiście). Pole pod krzywą będzie zatem równe 1, jak tego należy się spodziewać po gęstości.

Wprawdzie już to padło mimochodem wyżej, ale analizowany zbiór danych to liczba oddanych głosów na numer jeden na liście komitetu wyborczego Zbigniewa Stonogi w okręgu wyborczym 25 w wyborach do Sejmu w 2015 roku. Tym numerem jeden była Danuta Hojarska, która faktycznie dostała 152 głosy w jednej komisji (we wsi, w której mieszka) oraz 0--4 głosów w 90% pozostałych komisjach (w tym 0 głosów w 191/657.0 = 29% komisjach).

Analiza przestrzenna

Ze starych zapasów odgrzebałem plik CSV ze współrzędnymi obwodowych komisji wyborczych i połączyłem go z wynikami uzyskanymi przez Hojarską z zamiarem wyświetlenia tego na mapie za pomocą Google Fusion Tables (GFT):

obwod;coordexact;glosy;icon
101884;54.2701205 18.6317438;3;measle_white
101885;54.260714 18.6282809;0;measle_white
101886;54.262187 18.632082;2;measle_white
101887;54.257501 18.63147;1;measle_white
101888;54.25786 18.6306574;7;measle_grey
...

Kolumna icon zawiera nazwę ikony, która jest definiowana wg schematu: 0--3 głosy biala (measle_white); 4--9 głosów szara (measle_grey) 9-19 głosów żółta (small_yellow) 20--99 głosów czerwona (small_red) 100 i więcej głosów purpurowa (small_purple). Zestawienie dostępnych w GFT ikon można znaleźć tutaj. Konfigurowanie GFT aby korzystała z kolumny z nazwami ikon sprowadza się do wyklikania stosownej pozycji (Configure map →Feature map →Change feature styles →Use icon specified in a column.)

Przy okazji odkurzyłem zasób skryptów/zasobów używanych do geokodowania i/lub przygotowywania danych pod potrzeby GFT, w szczególności: joincvs.pl (łączy dwa pliki csv w oparciu o wartości n-tej kolumny w pierwszym pliku oraz m-tej kolumny w drugim); geocodeCoder0.pl (uruchamia geokodera Google). Oba skrypty i jeszcze parę rzeczy można znaleźć: tutaj.

środa, 21 lutego 2018

time plot tygodniowej liczby twitów

Załóżmy, że plik CSV zawiera liczbę opublikowanych twitów (dane tygodniowe). Problem: przedstawić szereg w postaci przebiegu czasowego (time plot). Taki skrypt R wymyśliłem do zrealizowania tego zadania:

require(ggplot2)

args <- commandArgs(TRUE)
ttname <- args[1];
file <- paste(ttname, ".csv", sep="")
filePDF <- paste(ttname, ".pdf", sep="")

d <- read.csv(file, sep = ';',  header=T, na.string="NA", );
## Plik CSV jest postaci:

##str(d)

## wiersze 1,2 + ostatni są nietypowe (usuwamy)
rows2remove <- c(1, 2, nrow(d));
d <- d[ -rows2remove, ];

## szacujemy prosty model trendu
lm <- lm(data=d, posts ~ no ); summary(lm)
posts.stats <- fivenum(d$posts);
posts.mean <- mean(d$posts);
sumCs <- summary(d$posts);

otherc <- coef(lm);
# W tytule średnia/mediana i równanie trendu
title <- sprintf ("Weekly for %s # me/av = %.1f/%.1f (y = %.2f x + %.1f)", 
  ttname, sumCs["Median"], sumCs["Mean"], otherc[2], otherc[1] );

##str(d$no)
## Oś x-ów jest czasowa
## Skróć yyyy-mm-dd do yy/mmdd
d$date <- sub("-", "/", d$date) ## zmienia tylko pierwszy rr-mm-dd
d$date <- sub("-", "", d$date) ## usuwa mm-dd
d$date <- gsub("^20", "", d$date) ## usuwa 20 z numeru roku 2018 -> 18
weeks <- length(d$no);
## https://stackoverflow.com/questions/5237557/extract-every-nth-element-of-a-vector
## Na skali pokaż do 20 element /dodaj ostatni `na pałę' (najwyżej zajdą na siebie)
## możnaby to zrobić bardziej inteligentnie ale nie mam czasu
scaleBreaks <- d$no[c(seq(1, weeks, 20), weeks)];
scaleLabs <- d$date[c(seq(1, weeks, 20), weeks)];

ggplot(d, aes(x = no, y = posts)) +
  geom_line() +
  ggtitle(title) +
  ylab(label="#") +
  xlab(label=sprintf("time (yy/mmdd) n=%d", weeks )) +
  scale_x_continuous(breaks=scaleBreaks, labels=scaleLabs) +
  geom_smooth(method = "lm")

ggsave(file=filePDF)  

środa, 14 lutego 2018

Wycieczka do Lizbony 2018


Fatima

Dorsz czyli Bacalhau

Ciastka

Słynna Pasteis de Belem

GDP Pocket

Szóstego lutego pojechaliśmy do Portugalii. Wizzair lata konkretnie z GDA do Lizbony.

Nasza kwatera była w centrum: 25 Rua do Cardal de S. José (25 to numer domu). Pod numerem 23 jest restauracja i tam urzęduje współwłaściciel. Z metra to 200m faktycznie:

You can also come with the underground. The access is nearby the exit of the airport. Line red til the end. Change for the blue line direction santa Apolonia, stop Avenida station. The apartment is located at some 200 metros.

Pobyt wyglądał tak, że #1 dzień: stare miasto, zamek św Jerzego oraz muzeum kafli ceramicznych (azulejos). Dzień #2: Fatima. Dzień #3: Sintra a konkretnie zwiedzanie dwóch pałaców tj. Palácio Nacional de Sintra + Quinta_da_Regaleira + wejście pod pałac Pena. Do pałacu Pena nie weszliśmy, bo była kiepska pogoda/gęsta mgła, więc i tak by było kiepsko widać z zewnątrz, a w środku to tam za dużo nie ma do oglądania. Poza tym byliśmy już zmęczeni. Za to po powrocie do Lizbony weszliśmy do muzeum pieniądza -- ale nie było warto (wstęp jest za darmo więc jak komuś się nudzi...) Dzień #4: Belem a konkretnie klasztor Hieronimitów (grobowiec v.d. Gammy) oraz Muzeum Morskie. W Belem była też czasowa wystawa grafik Eschera, ale się okazało, że wstęp za 11EUR więc nam przeszła chęć oglądania Eschera.

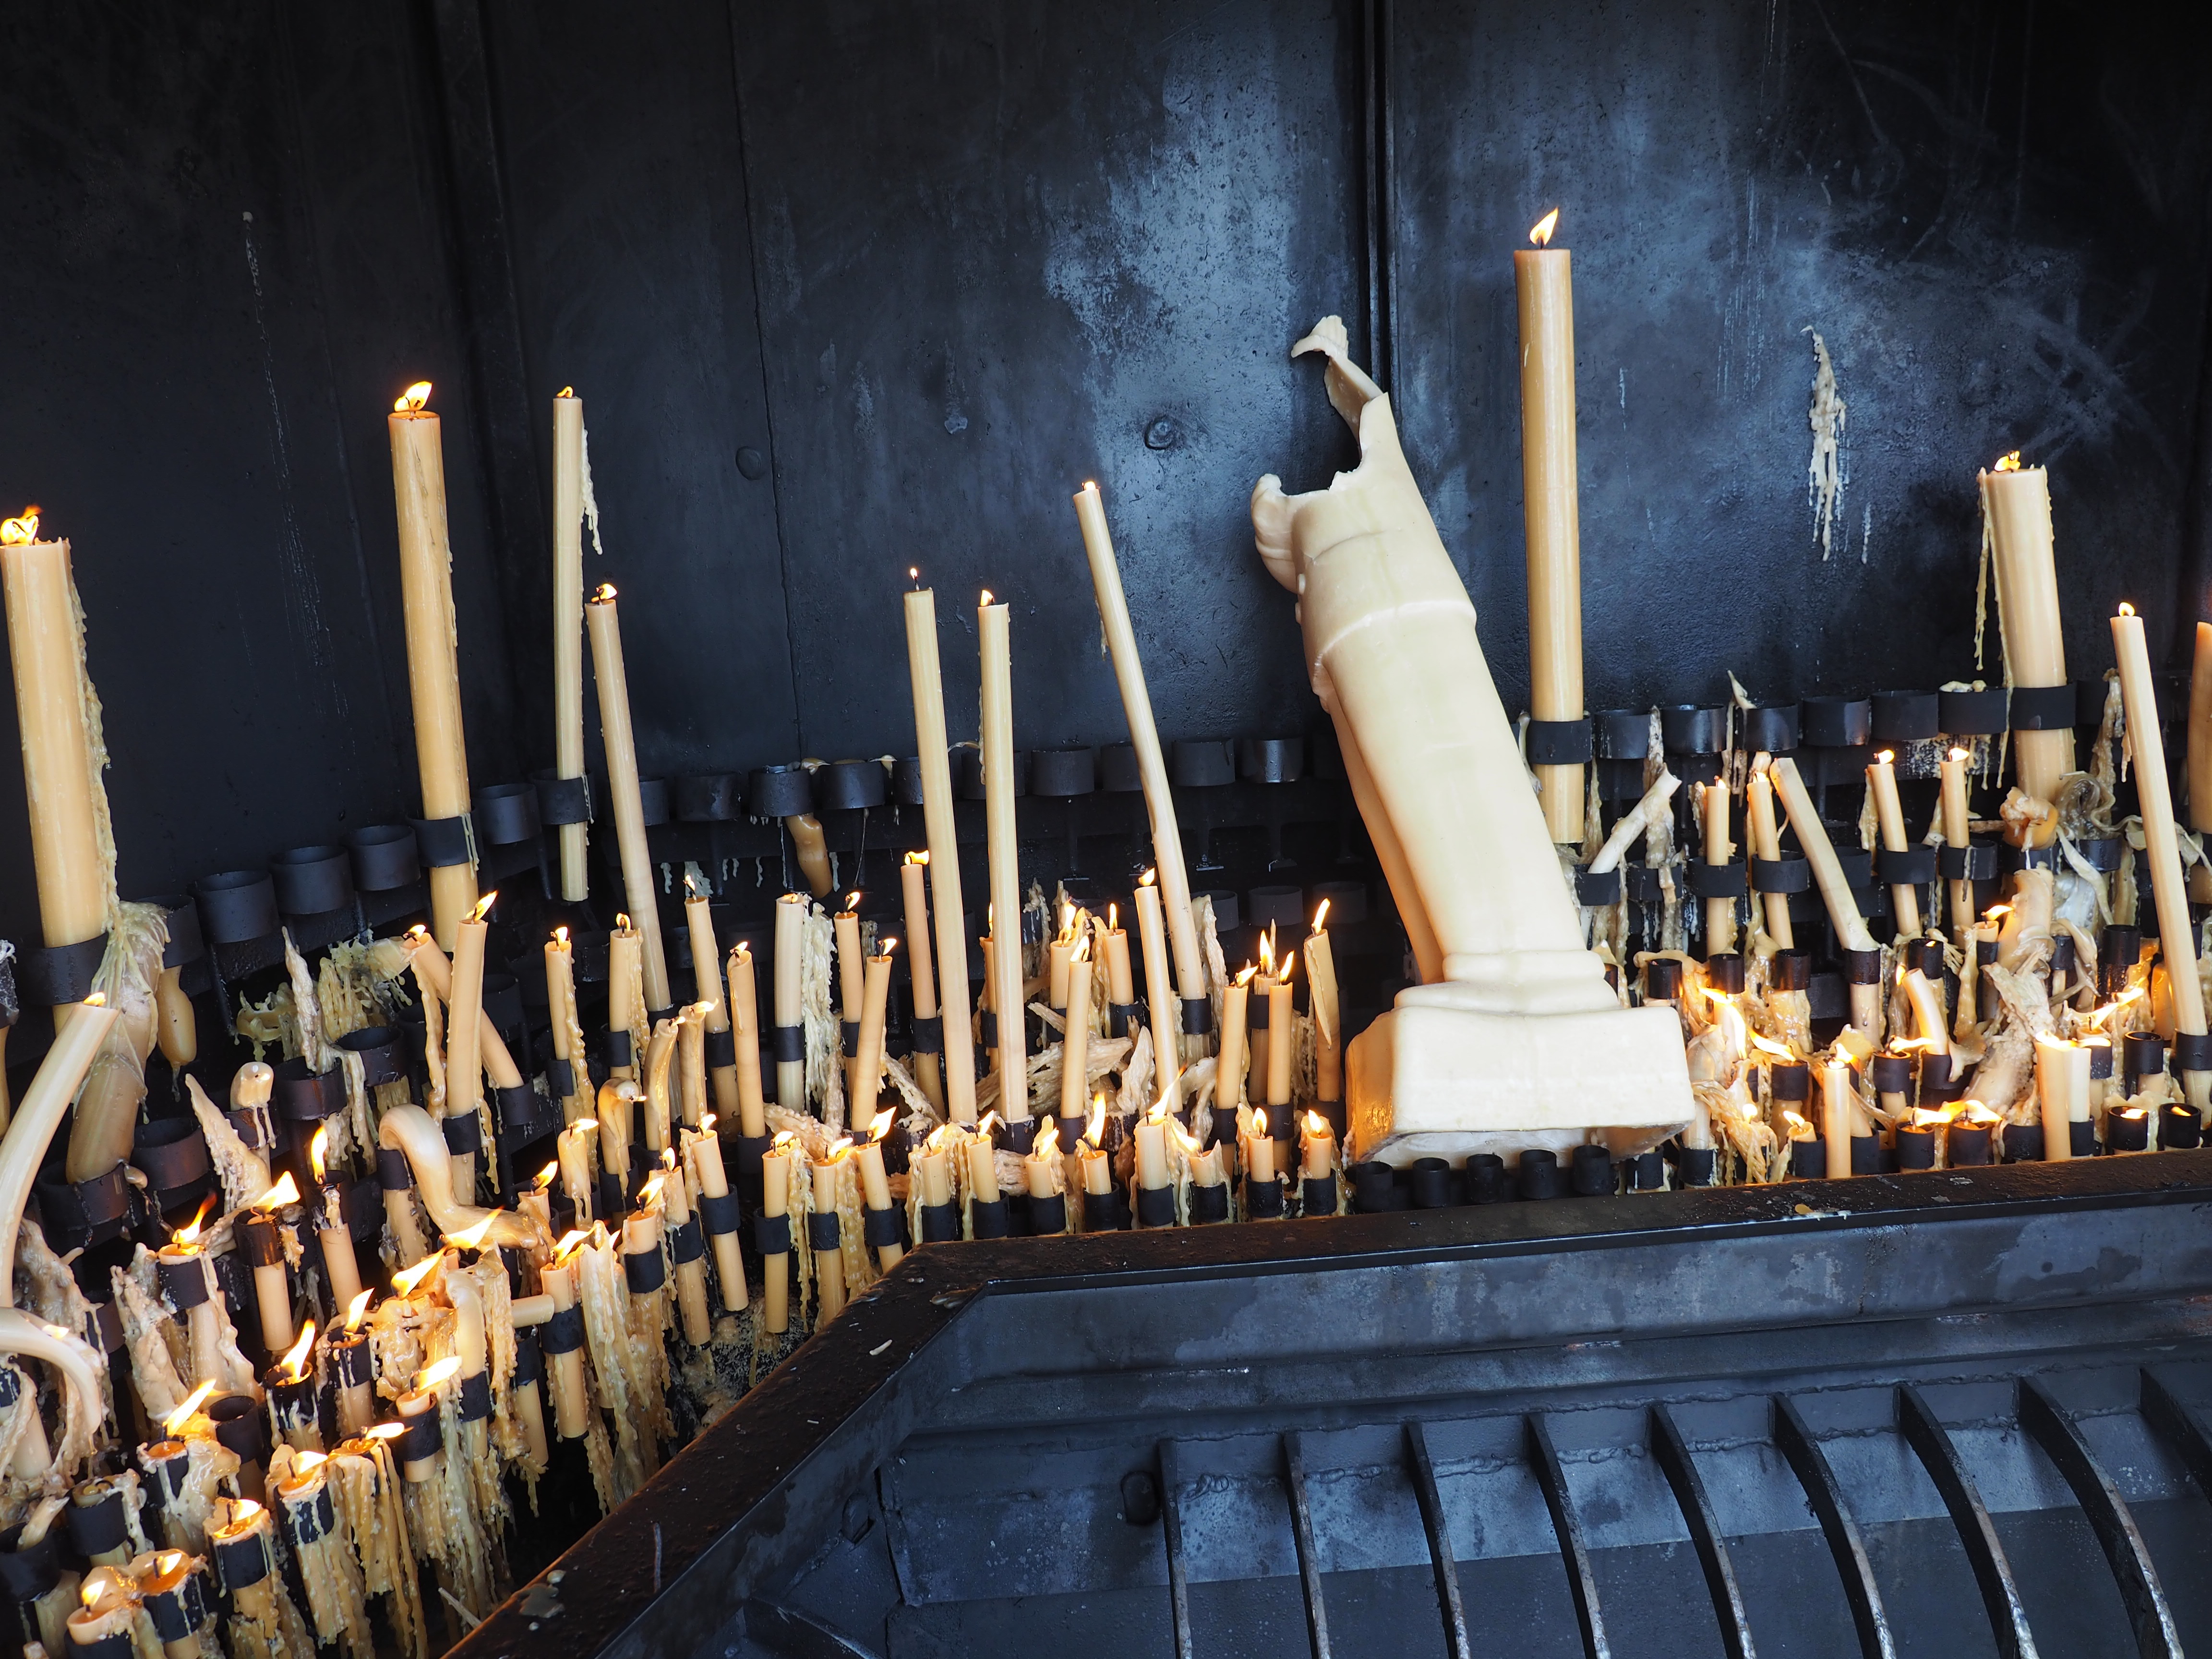
Wracając do dnia #2 czyli do Fatimy, to w szczególności ciekaw byłem konfrontacji opowieści W. Cejrowskiego z cyklu Boso przez świat z rzeczywistością. Ja przynajmniej po obejrzeniu Cejrowskiego odniosłem wrażenie niesłychanego skrzywienia w stronę komercji i dziwnych zabobonów, tj. że są tutaj jakieś gigantyczne wielkopowierzchniowe sklepy z dewocjonaliami, na których sprzedaje się masowo bardzo dziwne rzeczy typu woskowe organy ludzkie, które potem płoną na ogromnych stosach... Rzeczywistość nie potwierdziła tej wizji, nawet bym powiedział, że WC mocno przesadził. Owszem są sklepy, owszem sprzedaje się świece w kształcie organów, ale zarówno te sklepy nie są wcale gigantyczne jak i te dziwne dewocjonalia są marginesem. Jest też jeden całkiem mały budynek przeznaczony na spalenie świec ofiarnych (por. zdjęcie obok). Sklepy są wielkości tych z Częstochowy a dziwne świece stanowią margines -- dominują tradycyjne przedmioty, takie jak figura Matki Boskiej. Uwaga na koniec: podczas naszego pobytu Fatima była prawie pusta -- być może wrażenie jest inne podczas popularnych uroczystości kościelnych.

Co do kosztów to wydaliśmy 2700PLN na dwie osoby w tym 890 na bilety lotnicze + 520 PLN na kwaterę (4 noce x 2 osoby via AirBnB). W Sintrze wydaliśmy 40 EUR (2x pałac, tj. 4 bilety + dojazd) a w Fatimie 50 EUR (4x bilet autobusowy 2 x tam + 2 x stamtąd po 12,50 EUR). Bilet do muzeum morskiego 6.50EUR (warto), Azulejos 5.00 (też warto) Klasztor i zamek po circa 10EUR.

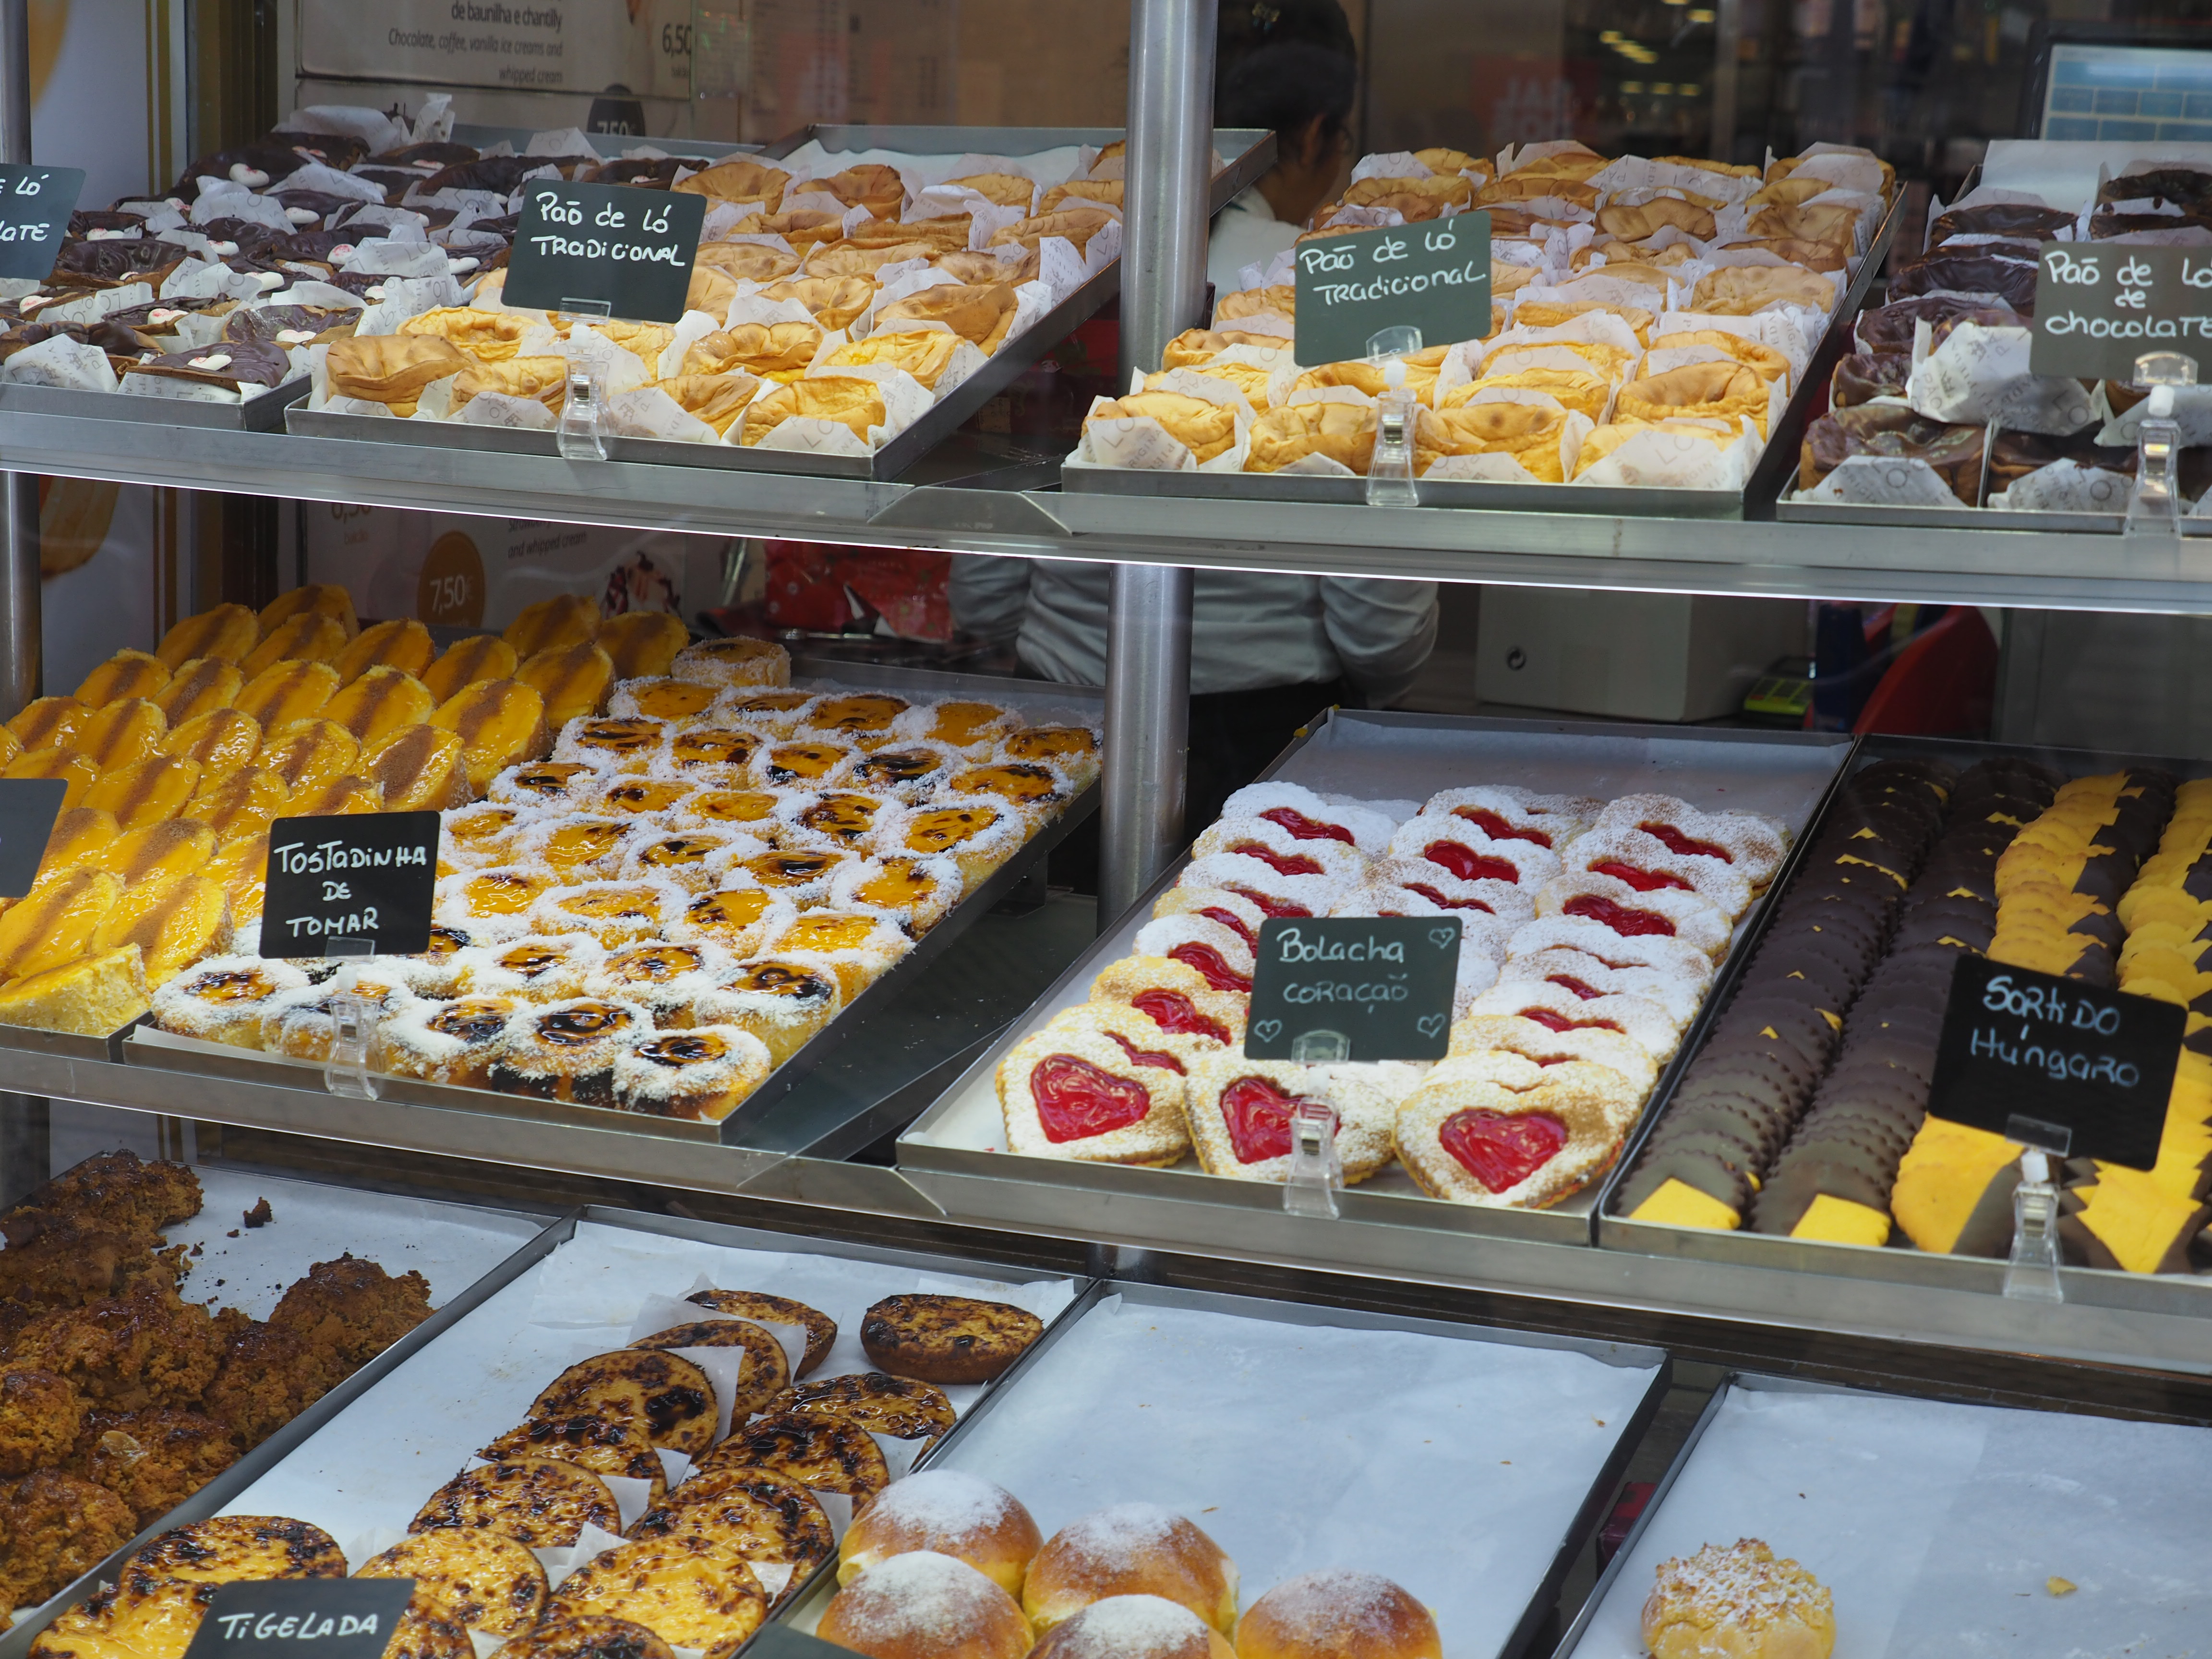
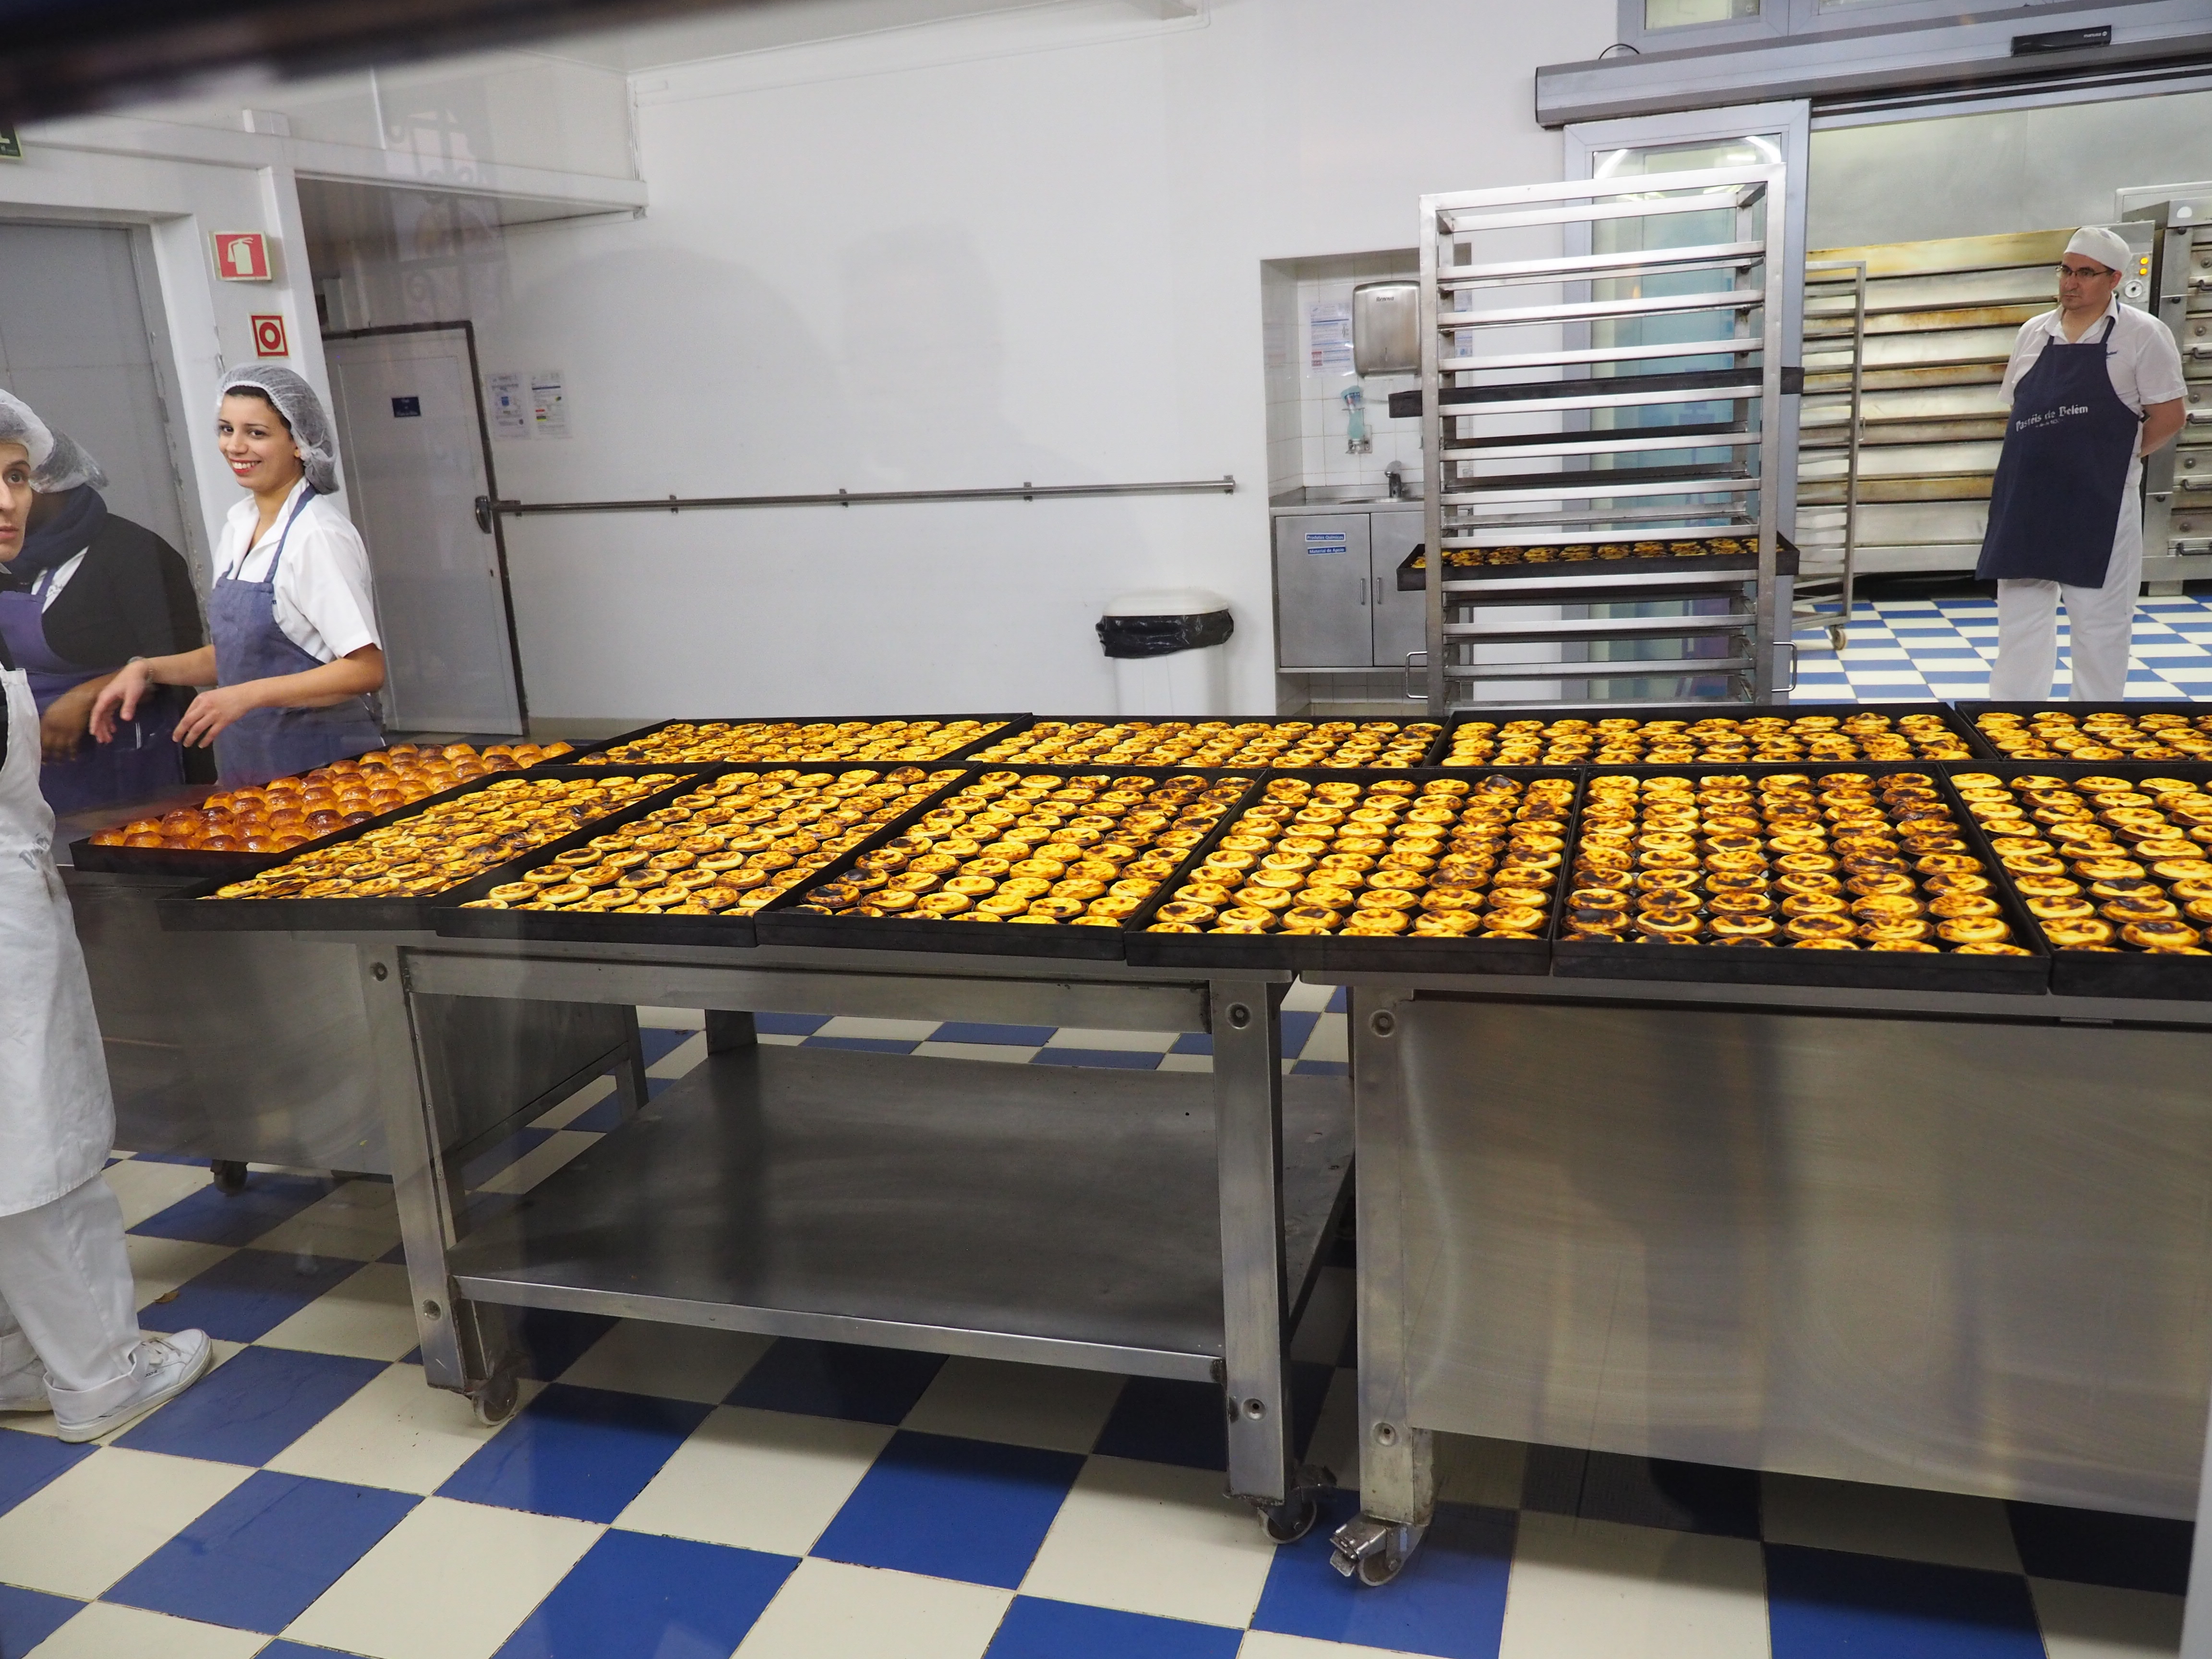
Rzucało się w oczy dla przybysza z kraju Biedronki tysiąca małych biznesów, a sklepów wielko czy średnio powierzchniowych jak na lekarstwo. Wśród sklepów #1 jest cukiernia/cukiernio-kawiarnia. Oni muszą pochłaniać ogromne ilości ciastek, które są mocno słodzone i zwykle nadziewane budyniem. Z zazdrością zauważyłem, że tego po miejscowych nie widać (że tyle cukru jedzą). W centrum Lizbony można też było spotkać małe-rodzinne sklepy spożywcze, sklepy AGD, księgarnie. Wygląda że wszystko to ma klientów i jakoś tam prosperuje...

W aspekcie sportowo-rekreacyjnym odniosłem za to wrażenie, że na rowerach to oni tu nie jeżdżą--być może wynika to z ukształtowania terenu. Na pewno w centrum Lizbony jeżdżenie na rowerze przy tamtejszych nachyleniach i wąskich ulicach to dla niewyczynowca mordęga. Trochę ludzi za to biega (po bruku--brrrr), nawet wcześnie rano widziałem takich zapaleńców. O tyle bieganie rano ma sens (w centrum), że nie ma ruchu (no i oczywiście zdaję sobie sprawę, że wielu biega rano bo potem leci do roboty.)

Przed wycieczką (z myślą o minimalizacji bagażu, ale także z planami wykorzystania w pracy) nabyłem najmniejszy laptop świata czyli GDP Pocket. Mało to on nie kosztował, ale sprawdził się. W wolnych chwilach doinstalowałem zresztą na nim prawie wszystko co mam na normalnym laptopie (bo zresztą na normalnym mam taki sam dysk jak na GP -- 120Gb), łącznie z TeXem, R oraz Pythonem i Perlem.

BTW na GDP Pocket jest dostępne Ubuntu i może bym i go zainstalował, gdyby nie plany używania tego urządzenia także w pracy -- Windows jednak jest bardziej kompatybilne ze wszystkim.

Samolot do GDA mieliśmy o 22.00, ale na lotnisko żeśmy się zwinęli już o 18:30, bo Elka była padnięta, a poza zwiedzaniem nie mieliśmy koncepcji co robić. W GDA byliśmy 02:30 nad ranem, przywitani zimą i -4C. W tamtą stronę podróż była mocno niekomfortowa, a to dlatego że było ciasno (rząd 28) a dwa rzędy przed nami rozkoszne Ruskie zresztą dziecię grało (bez słuchawek) w jakąś durną grę na konsoli. Powrotna za to była super komfortowa--mieliśmy miejsca w 4-tym rzędzie i wydaje mi się, że tam fotele są rzadziej rozstawione. No i nie było żadnego wkurwiającego ruskiego rebionka z konsolą.

Do pobrania ślady kml ze zdjęciami; zdjęcia; ślady gpx/kml.

Migracja do Debian Stretch na jupiterze (svn)

Się poprzedni wpis kończył jakoby odtworzenie repozytorium svn było prostą sprawą, ale w praniu się okazało, że nie do końca:

# zapisanie starego
svnadmin dump svnrepo > svnR.out
# odtworzenie
svnadmin create svnrepo
svnadmin load svnrepo < svnR.out

Próba zapisu skutkuje komunikatami o błędach. No tak zachciało mi się zmienić port na niestandardowy. Żeby svn wiedział jak się połączyć trzeba dopisać (na koncie komputera klienta, w sekcji [tunnels]):

vi ~/.subversion/config
ssh = $SVN_SSH ssh -q -p PORTNUMBER
# addgroup svn
Adding group `svn' (GID 1002) ...
# gpasswd -a "tomek" svn
##Adding user tomek to group svn
# chgrp -R svn path-to-svnrepo

Teraz

svn info
Ścieżka: .
Working Copy Root Path: /home/tomek/orgfiles
URL: svn+ssh://tomek@umbriel/media/usbstick/svnrepo/tp/orgfiles
...

## Zmień svn+ssh://tomek@umbriel/path-to-repo na nowe:
svn relocate svn+ssh://tomek@umbriel/path-to-repo/path-to-project